

ElevenLabs-Dokumentation
Starten Sie mit Ihrem Coding-Agent. Sie benötigen zuvor weder ein Konto noch einen API-Schlüssel.
Fügen Sie dies in Claude Code, Cursor oder Codex ein. Es meldet Sie an oder erstellt ein Konto, erstellt einen Schlüssel und fügt das SDK zu Ihrem Projekt hinzu.
So funktioniert es, oder lesen Sie den Quellcode des Befehls onboard, um genau zu sehen, was er Ihrem Agenten mitteilt.
Wie funktioniert ElevenLabs?
ElevenLabs bietet KI-Sprachinfrastruktur: Text-to-Speech, Speech-to-Text, KI-Stimme klonen, Voice Agents und generatives Audio. Sie können sie auf vier Arten nutzen, jeweils für unterschiedliche Zielgruppen.
ElevenCreative ist eine No-Code-Webanwendung, mit der Kreative, Produzenten und Editoren Voiceovers, Musik, Synchronisationen und Studioprojekte direkt im Browser erstellen.
ElevenAgents ist die Plattform zum Entwickeln und Betreiben von Voice Agents – mit einem visuellen Builder für nicht technische Nutzer und vollständiger programmatischer Steuerung für Entwickler.
ElevenAPI stellt alle Funktionen über eine REST-Schnittstelle mit offiziellen Python- und TypeScript-SDKs bereit, damit Entwickler Sprache in ihre eigenen Anwendungen und Workflows einbetten können.
Reception.ai ist ein sofort einsetzbarer KI-Telefonempfang für kleine und mittlere Unternehmen. Er nimmt Anrufe an, vereinbart Termine und verwaltet das Tagesgeschäft über ein zentrales Dashboard.
Wählen Sie Ihren Weg
ElevenCreative
Erfahren Sie in Schritt-für-Schritt-Anleitungen, wie Sie die ElevenCreative-Plattform nutzen
ElevenAgents
Erfahren Sie, wie Sie Agents mit ElevenLabs entwickeln, starten und skalieren
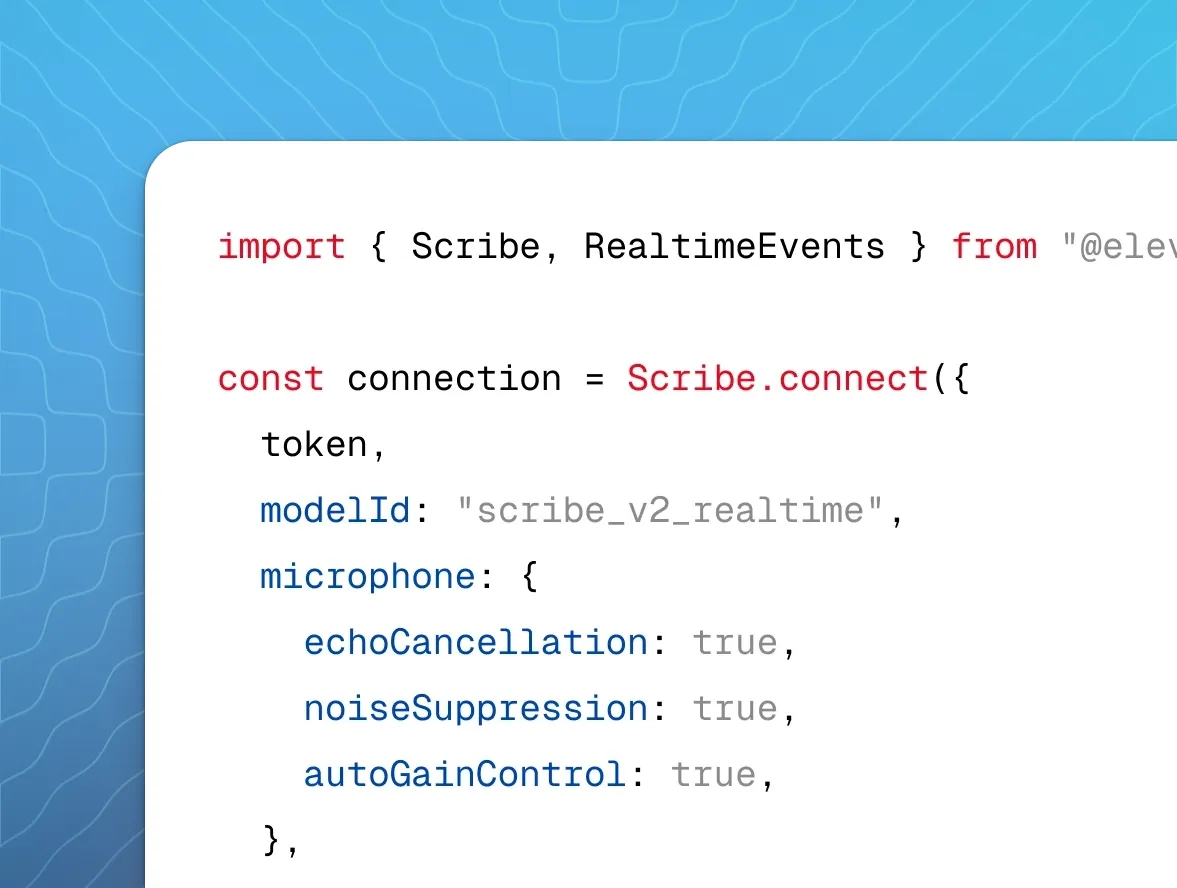
ElevenAPI
Erfahren Sie anhand von Beispielen und Tutorials, wie Sie die ElevenLabs API integrieren
Konzepte
Stimmen sind die Sprachpersona, die bei der Audiogenerierung verwendet wird. Jede Stimme hat eine eindeutige ID – zum Beispiel JBFqnCBsd6RMkjVDRZzb –, die Sie im Dashboard auswählen oder in API-Anfragen übergeben. ElevenLabs pflegt eine Bibliothek mit über 10.000 Stimmen. Sie können auch eine Stimme aus einer Audioaufnahme klonen oder aus einer Textbeschreibung generieren.
Modelle steuern Qualität, Latenz und Sprachabdeckung des generierten Audios. eleven_v4 erzeugt die ausdrucksstärksten Ergebnisse in über 90 Sprachen. eleven_v4_turbo ist für Echtzeitanwendungen mit einer medianen Inferenzlatenz von ~100 ms ausgelegt. Jede Funktion – Speech-to-Text, Musik, Soundeffekte – hat ein eigenes Modell. Unter Welches Modell sollte ich verwenden? finden Sie Hilfe bei der Auswahl.
Wie funktioniert die Preisgestaltung?
Credits sind die gemeinsame Verbrauchseinheit für alle Produkte. Text-to-Speech kostet einen Credit pro Zeichen des Eingabetexts. Andere Vorgänge werden pro Sekunde verarbeitetem Audio abgerechnet. Credits werden monatlich zurückgesetzt, und ungenutzte Credits werden bis zu zwei Monate übertragen. Eine vollständige Aufschlüsselung finden Sie unter Preise.
Wenn Sie die API ohne monatliches Abonnement nutzen möchten, können Sie mit Pay As You Go ein Guthaben im Voraus bezahlen, das bei der Nutzung von ElevenLabs aufgebraucht wird, nachdem alle Abonnement-Credits verwendet wurden.
Für den Produktiveinsatz entwickelt
Wie schnell ist ElevenLabs Text-to-Speech?
Eleven Flash v2.5 generiert Audio mit einer Modellinferenzlatenz von ~75 ms, Eleven v4 Turbo mit einem Median von ~100 ms. Scribe v2 Realtime liefert teilweise Transkripte in ~150 ms. Diese Angaben schließen Anwendungs- und Netzwerklatenz aus. Daher dauert es länger, bis Ihre Nutzer Audio hören. Latenz verstehen erklärt, was diese Angaben abdecken, und Latenzoptimierung zeigt, wie Sie die End-to-End-Latenz reduzieren.
Wie bewältigt ElevenLabs Skalierung?
Ihr Tarif legt fest, wie viele Anfragen gleichzeitig verarbeitet werden. Ein Gleichzeitigkeit-Limit ist keine Obergrenze für parallele Gespräche: Als Faustregel kann ein Limit von 5 je nach verwendeten Stimmen und Anwendungsfall etwa 100 gleichzeitige Audioübertragungen unterstützen. Enterprise-Tarife bieten höhere Limits. Unter Gleichzeitigkeit und Priorität finden Sie Limits je Tarif und Hinweise zu Lasttests.
Enterprise-Kontrollen
- Private Bereitstellungen führen ElevenAgents, Text to Speech und Speech to Text in Ihrem eigenen Cloud-Konto aus, sodass Texte, Audio und Transkripte in Ihrem Netzwerk bleiben.
- Datenresidenz speichert Ihre Daten in isolierten Umgebungen in der EU, Indien oder Singapur statt am standardmäßigen Standort in den USA. Dies ist eine Enterprise-Funktion.
- Workspaces zentralisieren Abrechnung, gemeinsame Ressourcen, Teamzugriff und API-Schlüsselverwaltung. Enterprise-Workspaces bieten zusätzlich SSO über SAML 2.0 oder OIDC sowie Audit-Logs administrativer Aktionen im OCSF-Schema.
Generieren Sie Ihr erstes Audio
Installieren Sie das SDK, legen Sie Ihren API-Schlüssel als Umgebungsvariable fest und wandeln Sie Text mit einer einzigen Anfrage in eine MP3-Datei um. Wenn Ihr Coding-Agent diese Einrichtung übernehmen soll, lesen Sie Mit Ihrem Coding-Agent einrichten.
API-Schlüssel festlegen
Erstellen Sie einen API-Schlüssel und fügen Sie ihn einer .env-Datei in Ihrem Projektverzeichnis hinzu:
Audio generieren und speichern
Führen Sie das Skript mit python example.py oder npx tsx example.mts aus und öffnen Sie dann output.mp3. Um dasselbe über das Terminal zu tun, verwenden Sie die ElevenLabs CLI:
Der ElevenAPI-Schnellstart erläutert dieselbe Anfrage ausführlicher, einschließlich der CLI-Einrichtung und der Audiowiedergabe über Ihre Lautsprecher.
Was kann ich mit ElevenAgents entwickeln?
ElevenAgents kombiniert Spracherkennung, ein LLM Ihrer Wahl, Text-to-Speech und Sprecherwechsel zu einem einzelnen Voice Agent, den Sie im Dashboard oder über die SDKs konfigurieren.
- Kundensupport: Beantworten Sie Fragen anhand Ihrer eigenen Dokumentation, indem Sie dem Agenten eine Wissensdatenbank hinzufügen.
- Telefonleitungen: Verbinden Sie eine Twilio-Nummer über die native Integration, um eingehende und ausgehende Anrufe zu bearbeiten, oder binden Sie Ihr vorhandenes Telefonsystem über SIP-Trunking ein.
- Outbound-Kampagnen: Führen Sie mit Batch Calling viele ausgehende Anrufe gleichzeitig durch.
- Websites und Apps: Betten Sie mit dem Widget einen Agenten ein, der sowohl Sprache als auch Text verarbeitet.
Der ElevenAgents-Schnellstart erstellt einen ersten Agenten vollständig von Anfang bis Ende.
Welches Modell sollte ich verwenden?
Beginnen Sie mit Ihrem Anwendungsfall. Jede Modell-ID unten ist der Wert, den Sie in API-Anfragen als model_id übergeben.
Weitere Anwendungsfälle finden Sie unter Das richtige Modell wählen, vollständige Spezifikationen in der Modellreferenz.
† Ohne Anwendungs- & Netzwerklatenz. Siehe Latenz verstehen.