

Modelle
Flaggschiffmodelle
Text to Speech
Speech to Text
Voice Agents
Musik
Modellübersicht
Die ElevenLabs API bietet eine Reihe von Audiomodellen, die für unterschiedliche Anwendungsfälle, Qualitätsstufen und Leistungsanforderungen optimiert sind.
† Ohne Anwendungs- und Netzwerklatenz. Siehe Latenz verstehen.
Veraltete Modelle
Die Modelle eleven_turbo_v2_5 und eleven_turbo_v2 sind funktional gleichwertig mit den
Modellen eleven_flash_v2_5 bzw. eleven_flash_v2, mit Ausnahme der durchschnittlich geringeren Latenz der Flash-
Modelle. Wir empfehlen, Flash-Modelle statt Turbo-Modellen in allen Anwendungsfällen zu
verwenden.
Eleven v4
Eleven v4 ist unser hochmodernes Sprachsynthesemodell und liefert Audio in höchster Qualität, Ausdrucksstärke und Kontrolle über die Darbietung von Stimmen. Eleven v4 unterstützt KI-Stimme klonen in hoher Qualität mit zuverlässigem Erhalt der Sprecheridentität über lange Textgenerierungen hinweg.
Dieses Modell eignet sich gut für folgende Szenarien:
- Charakter-Voiceovers: Ideal für Spiele und Animationen dank seiner emotionalen Bandbreite.
- Emotionale Dialoge: Erstellen Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis.
- Hörbuchproduktion: Perfekt für lange Erzählungen mit komplexer emotionaler Darbietung.
- Mehrsprachige Projekte: Erhält eine konsistente Stimmqualität bei Sprachwechseln.
Eleven v4 ist über die Text to Dialogue API verfügbar.
Unterstützte Sprachen
Die Modellfamilie Eleven v4 unterstützt über 90 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Koreanisch (ko), Kirgisisch (ky), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Eleven v4 Turbo
Eleven v4 Turbo ist unser hochmodernes Modell für Sprachsynthese in Echtzeit und liefert Audio in hoher Qualität, Ausdrucksstärke und Kontrolle über die Darbietung von Stimmen. Eleven v4 Turbo unterstützt KI-Stimme klonen in hoher Qualität und liefert Ergebnisse mit einer medianen Inferenzlatenz von ~100 ms.
Dieses Modell eignet sich gut für folgende Szenarien:
- Support-Agenten: Betreiben Sie Sprachagenten, die Kundenanfragen in Echtzeit lösen.
- KI-Assistenten: Erstellen Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis.
- Interaktive Charaktere: Hervorragend für Audioerlebnisse mit ausdrucksstarken Charakteren.
Eleven v4 Turbo ist über den Text to Dialogue WebSocket verfügbar.
Unterstützte Sprachen
Die Modellfamilie Eleven v4 unterstützt über 90 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Koreanisch (ko), Kirgisisch (ky), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Eleven v3
Eleven v3 ist unser Sprachsynthesemodell der vorherigen Generation. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen.
Mit Eleven v3 kommt eine neue Text to Dialogue API, mit der Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen erstellen können. Eleven v3 kann auch mit der Text to Speech API verwendet werden, um natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen zu erzeugen.
Lesen Sie hier mehr über die Text to Dialogue API.
Unterstützte Sprachen
Das Modell Eleven v3 unterstützt über 70 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Kirgisisch (ky), Koreanisch (ko), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational ist unser Modell der vorherigen Generation für Sprachsynthese in Echtzeit. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen.
Mit Eleven v3 Conversational kommt ein neuer Text to Dialogue WebSocket, mit dem Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen erstellen können.
Mit Eleven v3 Conversational kommt ein neuer Text to Dialogue WebSocket, mit dem Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen erstellen können.
Lesen Sie hier mehr über den Text to Dialogue WebSocket.
Unterstützte Sprachen
Das Modell Eleven v3 unterstützt über 70 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Kirgisisch (ky), Koreanisch (ko), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Multilingual v2
Eleven Multilingual v2 ist ein emotional sensibles Sprachsynthesemodell der vorherigen Generation. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und kontextuellem Verständnis in mehreren Sprachen.
Das Modell liefert über alle unterstützten Sprachen hinweg eine konsistente Stimmqualität und Persönlichkeit und bewahrt dabei die einzigartigen Eigenschaften und den Akzent des Sprechers.
Dieses Modell überzeugt besonders bei Szenarien, die hochwertige, emotional nuancierte Sprache erfordern:
- Charakter-Voiceovers: Ideal für Spiele und Animationen dank seiner emotionalen Bandbreite.
- Professionelle Inhalte: Gut geeignet für Unternehmensvideos und E-Learning-Materialien.
- Mehrsprachige Projekte: Erhält eine konsistente Stimmqualität bei Sprachwechseln.
- Stabile Qualität: Erzeugt konsistente Audioausgabe in hoher Qualität.
Es hat zwar eine höhere Latenz und höhere Kosten pro Zeichen als Flash-Modelle, liefert jedoch bessere Qualität für Projekte, bei denen lebensechte Sprache wichtig ist.
Unsere mehrsprachigen v2-Modelle unterstützen 29 Sprachen:
Englisch (USA, UK, Australien, Kanada), Japanisch, Chinesisch, Deutsch, Hindi, Französisch (Frankreich, Kanada), Koreanisch, Portugiesisch (Brasilien, Portugal), Italienisch, Spanisch (Spanien, Mexiko), Indonesisch, Niederländisch, Türkisch, Filipino, Polnisch, Schwedisch, Bulgarisch, Rumänisch, Arabisch (Saudi-Arabien, VAE), Tschechisch, Griechisch, Finnisch, Kroatisch, Malaiisch, Slowakisch, Dänisch, Tamil, Ukrainisch & Russisch.
Flash v2.5
Eleven Flash v2.5 ist unser schnellstes Sprachsynthesemodell, entwickelt für Echtzeitanwendungen und die Agents Platform. Es liefert hochwertige Sprache mit extrem niedriger Latenz (~75 ms†) in 32 Sprachen.
Das Modell vereint Geschwindigkeit und Qualität. Damit eignet es sich ideal für interaktive Anwendungen und bewahrt zugleich eine natürlich klingende Ausgabe sowie konsistente Stimmeigenschaften über verschiedene Sprachen hinweg.
Dieses Modell eignet sich besonders für:
- Agents Platform: Perfekt für Sprachagenten und Chatbots in Echtzeit.
- Interaktive Anwendungen: Ideal für Spiele und Anwendungen, die sofortige Reaktionen erfordern.
- Verarbeitung im großen Maßstab: Effizient für die Text-to-Speech-Konvertierung großer Mengen.
Mit seinem günstigeren Preis für API-Generierungen und 75 ms Latenz ist Flash v2.5 die kosteneffiziente Option für alle, die schnelle und zuverlässige Sprachsynthese in mehreren Sprachen benötigen.
Flash v2.5 unterstützt 32 Sprachen – alle Sprachen der v2-Modelle sowie:
Ungarisch, Norwegisch & Vietnamesisch
† Ohne Anwendungs- und Netzwerklatenz. Siehe Latenz verstehen.
Hinweise
Textnormalisierung mit Zahlen
Bei der Verwendung von Flash v2.5 werden Zahlen standardmäßig möglicherweise nicht wie erwartet normalisiert. Beispielsweise werden Telefonnummern unter Umständen so vorgelesen, dass sie für Nutzer nicht klar verständlich sind. Ähnlich betroffen sind Daten und Währungen.
Um die niedrige Latenz zu bewahren, ist die Normalisierung für Flash v2.5 standardmäßig deaktiviert. Enterprise-Kunden können die Textnormalisierung für v2.5-Modelle jedoch aktivieren, indem sie in ihrer Anfrage den Parameter apply_text_normalization auf “on” setzen.
Das Modell Multilingual v2 normalisiert Zahlen besser. Daher empfehlen wir es für Telefonnummern und andere Fälle, in denen die Zahlennormalisierung wichtig ist.
Für Anwendungen mit niedriger Latenz oder auf der Agents Platform empfiehlt es sich, dass Ihr LLM den Text normalisiert, bevor Sie ihn an das TTS-Modell übergeben, oder den Parameter apply_text_normalization zu verwenden (bei v2.5-Modellen nur für Enterprise-Tarife).
Leitfaden zur Modellauswahl
Hinweise dazu, welches Modell am besten zu Ihren Anforderungen und Ihrem Anwendungsfall passt, finden Sie im Leitfaden zur Modellauswahl.
Anforderungen
Anwendungsfall
Zeichenlimits
Die maximale Anzahl unterstützter Zeichen in einer einzelnen Text-to-Speech-Anfrage variiert je nach Modell.
Scribe v2
Scribe v2 ist unser hochmodernes Spracherkennungsmodell für präzise Transkription in über 90 Sprachen. Es bietet genaue Zeitstempel auf Wortebene und erweiterte Funktionen wie Sprecherdiarisierung und dynamische Audio-Tags.
Dieses Modell überzeugt in Szenarien, die eine präzise Speech-to-Text-Konvertierung erfordern:
- Transkriptionsdienste: Perfekt für die Umwandlung von Audio- und Videoinhalten in Text
- Meeting-Dokumentation: Ideal zum Erfassen und Dokumentieren von Gesprächen
- Inhaltsanalyse: Gut geeignet für die Verarbeitung und Analyse von Audioinhalten
- Mehrsprachige Erkennung: Unterstützt präzise Transkription in über 90 Sprachen
Wichtige Funktionen:
- Präzise Transkription mit Zeitstempeln auf Wortebene
- Sprecherdiarisierung für Audio mit mehreren Sprechern
- Dynamische Audio-Tags für zusätzlichen Kontext
- Unterstützung für über 90 Sprachen
- Entitätserkennung
- Keyterm-Prompting
- Transkriptbearbeitung
Lesen Sie hier mehr über Scribe v2.
Scribe v2 Realtime
Scribe v2 Realtime, unser schnellstes und präzisestes Modell für Live-Spracherkennung, liefert hochmoderne Genauigkeit in über 90 Sprachen bei extrem niedrigen 150 ms Latenz.
Dieses Modell überzeugt bei dialogorientierten Anwendungsfällen:
- Live-Meeting-Transkription: Perfekt für Transkription in Echtzeit
- KI-Agenten: Ideal für Live-Gespräche
- Mehrsprachige Erkennung: Unterstützt präzise Transkription in über 90 Sprachen mit automatischer Spracherkennung
Wichtige Funktionen:
- Extrem niedrige Latenz: Erhalten Sie Teiltranskriptionen in ~150 Millisekunden
- Streaming-Unterstützung: Senden Sie Audio in Abschnitten und erhalten Sie Transkripte in Echtzeit
- Mehrere Audioformate: Unterstützung für PCM (8 kHz bis 48 kHz) und μ-law-Kodierung
- Voice Activity Detection (VAD): Automatische Sprachsegmentierung anhand von Stilleerkennung
- Manuelle Commit-Steuerung: Volle Kontrolle darüber, wann Transkriptsegmente abgeschlossen werden
- Entitätserkennung
- Transkriptbearbeitung
Lesen Sie hier mehr über Scribe v2 Realtime.
Scribe v2 Medical
Scribe v2 Medical ist ein Batch-Spracherkennungsmodell, das auf medizinische und klinische Audiodaten spezialisiert ist. Es ist ein Finetune von Scribe v2 und verbessert die Erkennung von Arzneimittelnamen, Anatomie, Pathologie und klinischen Diktaten, während es bei Alltagssprache die Genauigkeit von Scribe v2 erreicht. Es verwendet dieselbe Speech to Text API wie Scribe v2 und wird zum gleichen Preis abgerechnet. Übergeben Sie scribe_v2_medical als model_id.
Bestimmungszweck
Scribe v2 Medical ist ein Batch-Modell der Speech-to-Text-API für Entwickler und Organisationen zur Integration in Anwendungen, die klinische Audiodaten, darunter Gespräche zwischen medizinischem Personal und Patienten, Diktate, Aufnahme- und Versorgungskoordinationstelefonate, in Entwürfe von Transkripten für Dokumentations- und zugehörige administrative Workflows umwandeln. Der resultierende Text ist vor der Verwendung zur Überprüfung und Korrektur durch medizinisches Fachpersonal oder andere autorisierte Nutzer vorgesehen. Scribe v2 Medical ist nicht dazu bestimmt, klinische Informationen zu interpretieren oder Diagnosen, Behandlungsempfehlungen, klinische Entscheidungen oder andere klinische Beratung bereitzustellen.
Dieses Modell eignet sich gut für:
- Klinische Dokumentation: Umgebungsaufnahmen und Notizen, in denen medizinische Begriffe mitten im Gespräch vorkommen
- Diktate: Dichte Abfolgen von Medikamenten, Dosierungen und Befunden
- Aufnahme- und Koordinationstelefonate: Patienten beschreiben ihre eigenen Beschwerden, oft telefonisch
- Compliance-Workflows: Kombinieren Sie es mit Entitätserkennung für PHI-Kategorien
Wichtige Funktionen:
- Dasselbe Anfrageformat wie Scribe v2 (
keyterms,entity_detection,no_verbatim, Diarisierung, Zeitstempel) - Verbesserte Erkennung von Medikamentennamen sowie Begriffen aus Anatomie und Pathologie
- Keine Verschlechterung bei Alltagssprache gegenüber Scribe v2
- Unterstützung für über 90 Sprachen
- Sprecherdiarisierung für Audio mit mehreren Sprechern
- Dynamische Audio-Tags
- Entitätserkennung, einschließlich PHI-Kategorien
Scribe v2 Medical ist ein Batch-Modell. Verwenden Sie für Live-Transkription Scribe v2 Realtime.
Scribe v2 Medical ist HIPAA-fähig. Enterprise-Kunden erhalten Business Associate Agreements sowie den Zero Retention Mode (ZRM). Bei aktiviertem ZRM werden Audioeingabe und Textausgabe sofort nach Abschluss jeder Anfrage gelöscht. ElevenLabs speichert nichts, und Ihre Anwendung erhält die vollständige API-Antwort und verwaltet Transkripte unter Ihren eigenen Kontrollen.
Unternehmen, die HIPAA-Konformität benötigen, müssen ElevenLabs Sales kontaktieren, um vor dem Senden geschützter Gesundheitsinformationen ein Business Associate Agreement (BAA) zu unterzeichnen.
Lesen Sie hier mehr über Speech to Text.
Eleven Realtime
Eleven Realtime ist eine neue Klasse von Speech-to-Speech-Modellen für den Aufbau natürlicher Sprachagenten. Jedes Realtime-Modell ist ein vollständiger Sprachagent: Spracherkennung, Spracherkennung und Sprecherwechsel, LLM sowie Text to Speech, von ElevenLabs ausgewählt und abgestimmt, damit alles als ein System zusammenarbeitet. Wählen Sie ein Realtime-Modell, erhalten Sie mit einer einzigen Auswahl einen leistungsfähigen Agenten – ohne Komponenten konfigurieren zu müssen.
Zwei Realtime-Modelle sind verfügbar.
Eleven Realtime v1 Mini ist für schnelle, natürliche Gespräche optimiert und eignet sich gut für folgende Szenarien:
- KI-Assistenten: Schnelle, ausdrucksstarke Dialoge, bei denen das Gespräch selbst das Produkt ist.
- Lernbegleiter: Natürlicher Austausch, der mit dem Lerntempo Schritt hält.
- Interaktive Charaktere: Ausdrucksstarke Charaktere für Spiele und Unterhaltung.
Eleven Realtime v1 Max ist für komplexe Aufgaben optimiert und eignet sich gut für folgende Szenarien:
- Kundensupport: Lösen von Anfragen, die das Befolgen eines Prozesses und das Abrufen von Informationen erfordern.
- Lead-Qualifizierung: Strukturierte Gespräche, die Informationen erfassen und nächste Schritte festlegen.
- Mehrstufige Workflows: Aufgaben, die Tools aufrufen, um Informationen abzurufen oder Aktionen auszuführen.
Wichtige Funktionen:
- Spracherkennung, Sprecherwechsel, Sprachmodell und Stimme in einer Modellauswahl
- Natürlicher Sprecherwechsel und Umgang mit Unterbrechungen
- Tool-Aufrufe
- Anpassbare Stimmen aus der ElevenLabs-Stimmbibliothek
- Unterstützung für über 90 Sprachen
- Wechsel zwischen v1 Mini und v1 Max durch Modellauswahl statt Integrationsänderung
Eleven Realtime ist in ElevenAgents verfügbar, wo Sie ein Realtime-Modell im Modell-Dropdown auswählen, sowie über die Realtime API, die für Kompatibilität mit OpenAIs Realtime API über WebSocket entwickelt wurde. Wenn Sie bereits OpenAIs Realtime API verwenden, lesen Sie den Migrationsleitfaden.
Unterstützte Sprachen
Realtime-Modelle unterstützen über 90 Sprachen. Siehe die Sprachliste für Eleven v4.
Lesen Sie hier mehr über Eleven Realtime.
Eleven Music
Eleven Music ist unser Musikgenerierungsmodell in Studioqualität. Damit können Sie Musik jedes Stils mit Prompts in natürlicher Sprache erstellen.
Dieses Modell eignet sich hervorragend für folgende Szenarien:
- Spiele-Soundtracks: Erstellen Sie immersive Soundtracks für Spiele
- Podcast-Hintergründe: Ergänzen Sie Podcasts mit professioneller Musik
- Marketing: Fügen Sie Werbe-Reels Hintergrundmusik hinzu
Wichtige Funktionen:
- Vollständige Kontrolle über Genre, Stil und Struktur
- Gesang oder rein instrumental
- Mehrsprachig, einschließlich Englisch, Spanisch, Deutsch, Japanisch und weiteren Sprachen
- Bearbeiten Sie Klang und Liedtext einzelner Abschnitte oder des gesamten Songs
Lesen Sie hier mehr über Eleven Music.
Parallelität und Priorität
Ihr Abonnement bestimmt, wie viele Anfragen gleichzeitig verarbeitet werden können und welche Priorität Ihre Anfragen in der Warteschlange haben. Speech to Text hat ein erhöhtes Parallelitätslimit. Sobald das Parallelitätslimit erreicht ist, werden weitere Anfragen zusammen mit Anfragen niedrigerer Priorität in einer Warteschlange verarbeitet. In der Praxis erhöht dies die Latenz in der Regel nur um etwa 50 ms.
Die Response-Header enthalten current-concurrent-requests und maximum-concurrent-requests, mit denen Sie Ihre Parallelität überwachen können.
API-Anfragen pro Minute im Vergleich zu parallelen Anfragen
Es ist wichtig zu verstehen, dass API-Anfragen pro Minute und parallele Anfragen unterschiedliche Metriken sind, die von Ihren Nutzungsmustern abhängen.
API-Anfragen pro Minute können von parallelen Anfragen abweichen, da dies von der Dauer jeder Anfrage und der Bündelung der Anfragen abhängt.
Beispiel 1: Zeitlich versetzte Anfragen Wenn Sie 180 Anfragen pro Minute hätten, die jeweils 1 Sekunde zur Verarbeitung benötigen, und diese im Abstand von jeweils 0,33 Sekunden senden würden, läge die maximale Anzahl paralleler Anfragen bei 3 und der Durchschnitt ebenfalls bei 3, da immer 3 Anfragen gleichzeitig verarbeitet würden.
Beispiel 2: Gebündelte Anfragen Wenn Sie jedoch ein anderes Nutzungsmuster hätten, etwa 180 Anfragen pro Minute, die jeweils 3 Sekunden zur Verarbeitung benötigen, aber alle gleichzeitig ausgelöst würden, läge die maximale Anzahl paralleler Anfragen bei 180 und der Durchschnitt bei 9 (in den ersten 3 Sekunden der Minute wurden 180 Anfragen gleichzeitig verarbeitet, in den letzten 57 Sekunden 0 Anfragen).
Da unser System die Parallelität berücksichtigt, sind Anfragen pro Minute weniger wichtig als die Dauer jeder Anfrage und das Muster, nach dem sie gesendet werden.
Die Art, wie Endpunktanfragen gestellt werden, beeinflusst die Parallelitätslimits:
- Bei HTTP zählt jede Anfrage einzeln für Ihr Parallelitätslimit.
- Beim Text to Speech WebSocket zählt nur die Zeit, in der unser Modell Audio generiert, für Ihr Parallelitätslimit. Das bedeutet, dass ein offener WebSocket die meiste Zeit gar nicht für Ihr Parallelitätslimit zählt.
- Die Text to Dialogue WebSockets funktionieren anders: Jede offene Verbindung reserviert eine Dialogsitzung aus einem separaten Pool, solange sie geöffnet bleibt. Über die Verbindung generiertes Audio zählt nicht für Ihr Standard-Parallelitätslimit. Das ist leichter nachzuvollziehen, da eine Verbindung einer Sitzung entspricht. Ihre Dialogsitzungslimits sind auf diese neue Methode zur Parallelitätsmessung abgestimmt. Siehe Text to Dialogue-Parallelität.
Parallelitätslimits verstehen
Das Parallelitätslimit Ihres Plans sollte nicht als maximale Anzahl gleichzeitiger Unterhaltungen, Telefonate, Charakter-Voiceovers usw. verstanden werden, die gleichzeitig verarbeitet werden können. Die tatsächliche Anzahl hängt von mehreren Faktoren ab, darunter die verwendeten KI-Stimmen und die Merkmale des Anwendungsfalls.
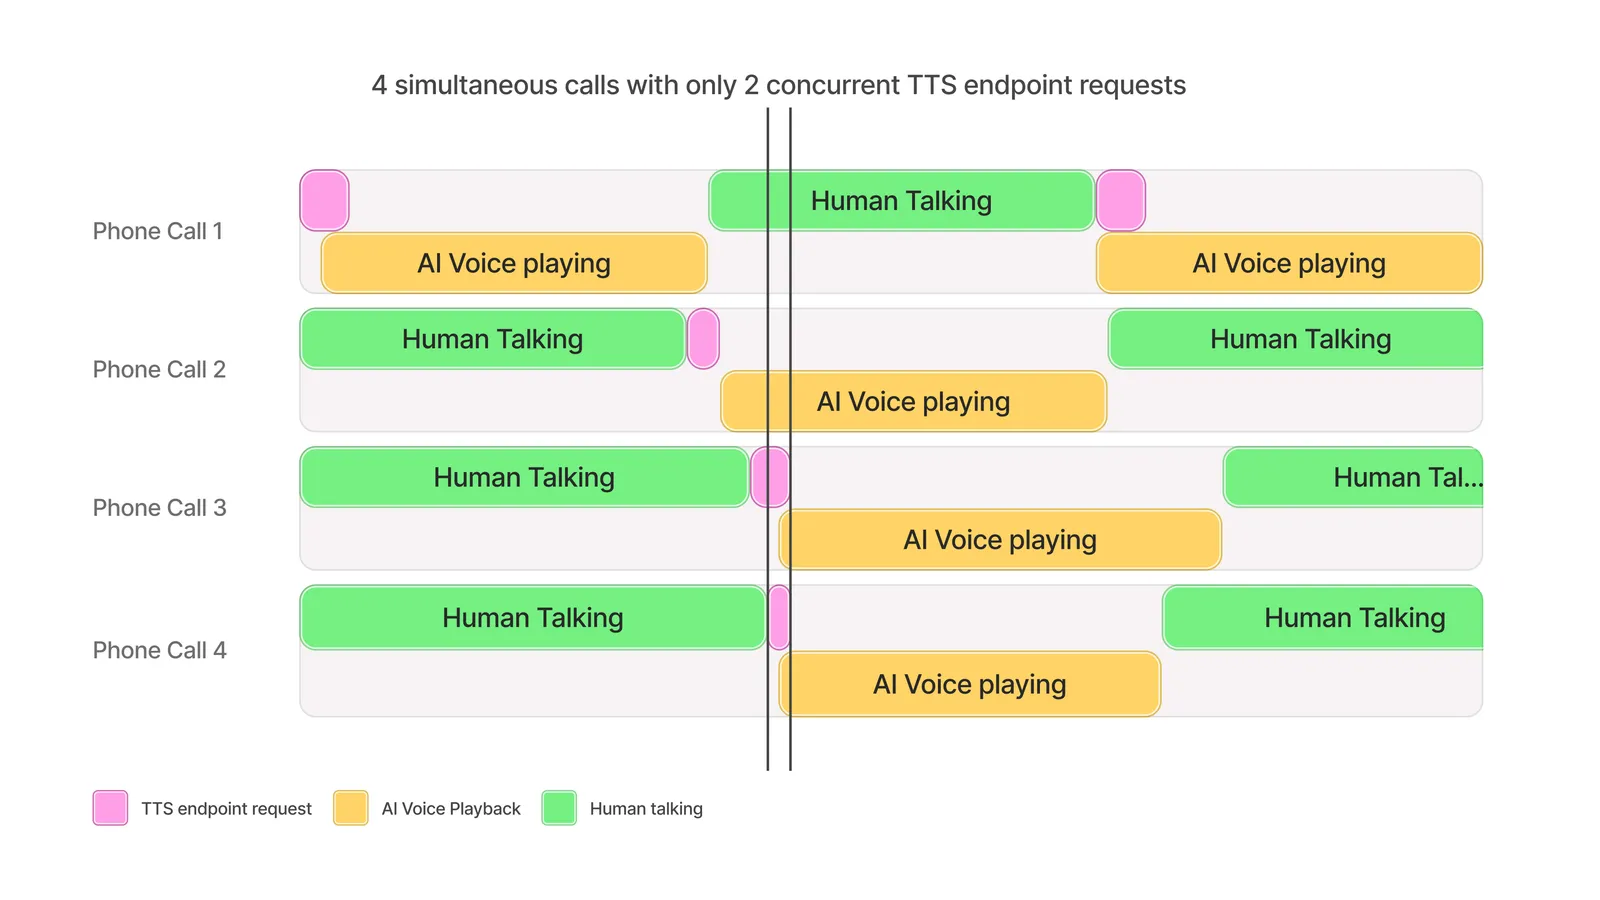
Als grobe Faustregel kann ein Parallelitätslimit von 5 in der Regel bis zu etwa 100 gleichzeitige Audioübertragungen unterstützen.
Das liegt an der Geschwindigkeit der Audiogenerierung im Verhältnis zur Verarbeitungszeit der TTS-Anfrage. Das folgende Diagramm zeigt beispielhaft, wie 4 parallele Anrufe mit verschiedenen Nutzern ermöglicht werden können, während nur 2 parallele Anfragen anfallen.
KI-Sprachagenten entwickeln
Wenn TTS für Dialoge verwendet wird, kann ein Parallelitätslimit von 5 etwa 100 Übertragungen für ausgewogene Gespräche zwischen KI-Agenten und menschlichen Teilnehmern unterstützen.
Bei Anwendungsfällen, in denen der KI-Agent seltener spricht als der Mensch, etwa im Kundensupport, können mehr als 100 gleichzeitige Gespräche unterstützt werden.
Charakter-Voiceovers
Im Allgemeinen können bei einem Parallelitätslimit von 5 mehr als 100 gleichzeitige Charakter-Voiceovers unterstützt werden.
Die Anzahl kann je nach Dialoghäufigkeit des Charakters, Länge der Pausen und In-Game-Aktionen zwischen den Zeilen variieren.
Live-Synchronisation
Parallele Synchronisationsstreams folgen in der Regel der angegebenen Faustregel.
Wenn die Übertragung Phasen mit Gesprächspausen enthält, etwa durch einen Soundtrack oder visuelle Szenen, sind möglicherweise mehr gleichzeitige Synchronisationsstreams als vorgeschlagen möglich.
Wenn Sie die Parallelitätslimits Ihres Plans überschreiten und den Enterprise-Plan nutzen, können Modellanfragen je nach verfügbarer Kapazität nach bestem Bemühen dennoch erfolgreich sein, jedoch langsamer.
Um Ihr Parallelitätslimit und Ihre Warteschlangenpriorität zu erhöhen, upgraden Sie Ihren Abonnementplan .
Enterprise-Kunden können über ihren Account Manager ein höheres Parallelitätslimit anfordern.
Text to Dialogue-Parallelität
Text to Dialogue-Anfragen werden abhängig davon, wie Sie die API aufrufen, auf zwei verschiedene Arten abgerechnet:
- HTTP-Endpunkte (Dialog erstellen und Dialog streamen) zählen während der Audiogenerierung für das Standard-Parallelitätslimit Ihres Plans, wie jede andere Text to Speech-Anfrage.
- WebSocket-Endpunkte wie der Text to Dialogue WebSocket werden als Dialogsitzungen abgerechnet. Eine offene Verbindung belegt eine Dialogsitzung, solange sie geöffnet bleibt, unabhängig davon, ob gerade Audio generiert wird.
Sitzungsbasierte Abrechnung vereinfacht die Kapazitätsplanung: Eine Verbindung entspricht einer Sitzung, sodass Ihre Nutzung nicht mit der Generierungsaktivität schwankt. Da eine Sitzung für die gesamte Verbindung belegt wird und nicht nur während der Audiogenerierung, sind Ihre Dialogsitzungslimits auf diese neue Methode zur Parallelitätsmessung abgestimmt.
Wenn Sie eine Verbindung öffnen, während alle Dialogsitzungen Ihres Workspaces belegt sind, wird die neue Verbindung mit einem too_many_concurrent_requests-Fehler abgelehnt. Um Sitzungen freizugeben, schließen Sie nicht mehr benötigte Verbindungen. Eine Verbindung wird außerdem nach 20 Sekunden Inaktivität automatisch geschlossen, sofern Sie keine keep_alive-Nachrichten senden.
Um Dialogsitzungen zu überwachen, öffnen Sie unten in der Dashboard-Seitenleiste Developers, wählen Sie den Tab Analytics und sehen Sie sich in der Nutzungsansicht die Metrik Concurrent requests an. Dialogsitzungen werden als eigene Reihe, TTD Websocket Sessions, getrennt von Ihren anderen parallelen Anfragen angezeigt.
Parallelitätslimits mit Skalierungstests prüfen
Skalierungstests können helfen, clientseitige Skalierungsprobleme zu erkennen und zu überprüfen, ob Parallelitätslimits für Ihren Anwendungsfall korrekt festgelegt sind.
Es wird dringend empfohlen, End-to-End-Workflows so nah wie möglich an der realen Nutzung zu testen. Die empfohlene Methode dafür ist, zu simulieren und zu messen, wie viele Nutzer unterstützt werden können. Wichtig ist:
- Simulieren Sie Nutzer, nicht reine Anfragen.
- Simulieren Sie typisches Nutzerverhalten, etwa das Warten auf Audiowiedergabe, das Sprechen des Nutzers oder den Abschluss der Transkription, bevor Anfragen gestellt werden.
- Erhöhen Sie die Nutzerzahl über mehrere Minuten hinweg langsam.
- Variieren Sie Anforderungszeitpunkte und Größe der Anfragen zufällig.
- Erfassen Sie Latenzmetriken und alle von der API zurückgegebenen Fehlercodes.
Um beispielsweise ein Agentensystem zu testen, das für 100 gleichzeitige Gespräche ausgelegt ist, würden Sie bis zu 100 einzelne „Nutzer“ erstellen, die jeweils ein Gespräch simulieren. Gespräche bestehen typischerweise aus einem wiederholten Zyklus von etwa 10 Sekunden Nutzersprache, gefolgt von einem TTS-API-Aufruf für etwa 150 Zeichen und anschließend etwa 10 Sekunden Audiowiedergabe für den Nutzer. Daher sollte jeder Nutzer dem Muster folgen, alle 20 Sekunden einen WebSocket-Text-to-Speech-API-Aufruf für 150 Textzeichen auszuführen, wobei die Wartezeit und die Anzahl angeforderter Zeichen leicht zufällig variiert werden. Der Test würde darin bestehen, jede Sekunde einen Nutzer zu starten, bis 100 vorhanden sind, und dann insgesamt 10 Minuten lang die Gesamtstabilität zu testen.
Beispiel für ein Skalierungstestskript
Dieses Beispiel verwendet locust als Test-Framework mit direkten API-Aufrufen an die ElevenLabs API.
Es folgt dem oben aufgeführten Beispiel und testet ein System mit dialogorientierten Agenten, bei dem jeder Nutzer alle 20 Sekunden 1 Anfrage sendet.