

Modellen
Topmodellen
Text to Speech
Speech to Text
Spraakagents
Muziek
Overzicht van modellen
De ElevenLabs API biedt een reeks audiomodellen die zijn geoptimaliseerd voor verschillende use cases, kwaliteitsniveaus en prestatievereisten.
† Exclusief applicatie- en netwerklatentie. Bekijk Inzicht in latentie.
Verouderde modellen
De modellen eleven_turbo_v2_5 en eleven_turbo_v2 zijn functioneel gelijkwaardig aan respectievelijk de
modellen eleven_flash_v2_5 en eleven_flash_v2, behalve dat de latentie van de Flash-
modellen gemiddeld lager is. We raden aan in alle use
cases de Flash-modellen te gebruiken in plaats van de Turbo-modellen.
Eleven v4
Eleven v4 is ons geavanceerde model voor spraaksynthese en biedt audio van onze hoogste kwaliteit, expressiviteit en controle over de uitvoering van stemmen. Eleven v4 ondersteunt zeer nauwkeurig stemklonen met betrouwbaar behoud van de spreker bij lange tekstgeneraties.
Dit model werkt goed in de volgende scenario’s:
- Character Voiceovers: Ideaal voor games en animatie dankzij het emotionele bereik.
- Emotional Dialogue: Genereer natuurlijke, levensechte dialogen met een groot emotioneel bereik en contextueel begrip.
- Audiobook Production: Perfect voor lange vertellingen met complexe emotionele uitvoering.
- Multilingual Projects: Behoudt consistente stemkwaliteit bij het wisselen tussen talen.
Eleven v4 is beschikbaar via de Text to Dialogue API.
Ondersteunde talen
De Eleven v4-modelfamilie ondersteunt meer dan 90 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Koreaans (ko), Kirgizisch (ky), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v4 Turbo
Eleven v4 Turbo is ons geavanceerde model voor realtime spraaksynthese en biedt hoogwaardige audio, expressiviteit en controle over de uitvoering van stemmen. Eleven v4 Turbo ondersteunt zeer nauwkeurig stemklonen en levert resultaten met een mediane inferentielatentie van ~100 ms.
Dit model werkt goed in de volgende scenario’s:
- Support agents: Voorzie voice agents van mogelijkheden om klantvragen realtime op te lossen.
- AI assistants: Genereer natuurlijke, levensechte dialogen met een groot emotioneel bereik en contextueel begrip.
- Interactive characters: Uitstekend voor audio-ervaringen met expressieve personages.
Eleven v4 Turbo is beschikbaar via de Text to Dialogue-websocket.
Ondersteunde talen
De Eleven v4-modelfamilie ondersteunt meer dan 90 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Koreaans (ko), Kirgizisch (ky), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v3
Eleven v3 is ons spraaksynthesemodel van de vorige generatie, dat natuurlijke, levensechte spraak produceert met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 komt een nieuwe Text to Dialogue API, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen. Je kunt Eleven v3 ook gebruiken met de Text to Speech API om natuurlijke, levensechte spraak te genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Lees hier meer over de Text to Dialogue API.
Ondersteunde talen
Het Eleven v3-model ondersteunt meer dan 70 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Kirgizisch (ky), Koreaans (ko), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational is ons model van de vorige generatie voor realtime spraaksynthese. Het produceert natuurlijke, levensechte spraak met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 Conversational komt een nieuwe Text to Dialogue WebSocket, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 Conversational komt een nieuwe Text to Dialogue WebSocket, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Lees hier meer over de Text to Dialogue WebSocket.
Ondersteunde talen
Het Eleven v3-model ondersteunt meer dan 70 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Kirgizisch (ky), Koreaans (ko), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Multilingual v2
Eleven Multilingual v2 is een emotioneel bewust spraaksynthesemodel van de vorige generatie. Het produceert natuurlijke, levensechte spraak met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Het model levert consistente stemkwaliteit en persoonlijkheid in alle ondersteunde talen, terwijl de unieke kenmerken en het accent van de spreker behouden blijven.
Dit model blinkt uit in scenario’s die hoogwaardige, emotioneel genuanceerde spraak vereisen:
- Character Voiceovers: Ideaal voor games en animatie dankzij het emotionele bereik.
- Professional Content: Zeer geschikt voor bedrijfsvideo’s en e-learningmateriaal.
- Multilingual Projects: Behoudt consistente stemkwaliteit bij het wisselen tussen talen.
- Stable Quality: Produceert consistente audio-uitvoer van hoge kwaliteit.
Hoewel het een hogere latentie en hogere kosten per teken heeft dan Flash-modellen, biedt het superieure kwaliteit voor projecten waarin levensechte spraak belangrijk is.
Onze meertalige v2-modellen ondersteunen 29 talen:
Engels (VS, VK, Australië, Canada), Japans, Chinees, Duits, Hindi, Frans (Frankrijk, Canada), Koreaans, Portugees (Brazilië, Portugal), Italiaans, Spaans (Spanje, Mexico), Indonesisch, Nederlands, Turks, Filipijns, Pools, Zweeds, Bulgaars, Roemeens, Arabisch (Saoedi-Arabië, VAE), Tsjechisch, Grieks, Fins, Kroatisch, Maleis, Slowaaks, Deens, Tamil, Oekraïens & Russisch.
Flash v2.5
Eleven Flash v2.5 is ons snelste model voor spraaksynthese, ontworpen voor realtime applicaties en Agents Platform. Het levert hoogwaardige spraak met ultralage latentie (~75 ms†) in 32 talen.
Het model brengt snelheid en kwaliteit in balans, waardoor het ideaal is voor interactieve applicaties, terwijl het natuurlijk klinkende uitvoer en consistente stemkenmerken in verschillende talen behoudt.
Dit model is bijzonder geschikt voor:
- Agents Platform: Perfect voor realtime voice agents en chatbots.
- Interactive Applications: Ideaal voor games en applicaties die een onmiddellijke reactie vereisen.
- Large-Scale Processing: Efficiënt voor tekst-naar-spraakconversie op grote schaal.
Dankzij de lagere prijs voor API-generaties en een latentie van 75 ms is Flash v2.5 de kosteneffectieve optie voor iedereen die snelle, betrouwbare spraaksynthese in meerdere talen nodig heeft.
Flash v2.5 ondersteunt 32 talen: alle talen van v2-modellen plus:
Hongaars, Noors & Vietnamees
† Exclusief applicatie- en netwerklatentie. Zie Informatie over latentie.
Aandachtspunten
Tekstnormalisatie met getallen
Wanneer je Flash v2.5 gebruikt, worden getallen standaard niet altijd genormaliseerd zoals je verwacht. Zo worden telefoonnummers mogelijk op een manier uitgesproken die niet duidelijk is voor de gebruiker. Dat geldt op vergelijkbare wijze voor datums en valuta’s.
Standaard is normalisatie uitgeschakeld voor Flash v2.5 om de lage latentie te behouden. Enterprise-klanten kunnen tekstnormalisatie voor v2.5-modellen nu echter inschakelen door in je request de parameter apply_text_normalization in te stellen op “on”.
Het Multilingual v2-model normaliseert getallen beter, dus we raden aan dit te gebruiken voor telefoonnummers en andere gevallen waarin getalnormalisatie belangrijk is.
Voor applicaties met lage latentie of Agents Platform-applicaties is het een best practice om je LLM de tekst te laten normaliseren voordat je deze doorgeeft aan het TTS-model, of om de parameter apply_text_normalization te gebruiken (alleen Enterprise-abonnementen voor v2.5-modellen).
Handleiding voor modelselectie
Raadpleeg de handleiding voor modelselectie voor advies over welk model het beste bij je vereisten en use case past.
Vereisten
Use case
Tekenlimieten
Het maximale aantal tekens dat wordt ondersteund in één tekst-naar-spraakrequest verschilt per model.
Scribe v2
Scribe v2 is ons geavanceerde spraakherkenningsmodel, ontworpen voor nauwkeurige transcriptie in meer dan 90 talen. Het biedt nauwkeurige timestamps op woordniveau en geavanceerde functies zoals sprekerdiarisatie en dynamische audiotagging.
Dit model blinkt uit in scenario’s die nauwkeurige spraak-naar-tekstconversie vereisen:
- Transcriptiediensten: Perfect voor het omzetten van audio- en videocontent naar tekst
- Vergaderdocumentatie: Ideaal voor het vastleggen en documenteren van gesprekken
- Contentanalyse: Zeer geschikt voor het verwerken en analyseren van audiocontent
- Meertalige herkenning: Ondersteunt nauwkeurige transcriptie in meer dan 90 talen
Belangrijkste functies:
- Nauwkeurige transcriptie met timestamps op woordniveau
- Sprekerdiarisatie voor audio met meerdere sprekers
- Dynamische audiotagging voor meer context
- Ondersteuning voor meer dan 90 talen
- Entiteitsdetectie
- Keyterm prompting
- Transcriptbewerking
Lees hier meer over Scribe v2.
Scribe v2 Realtime
Scribe v2 Realtime, ons snelste en nauwkeurigste model voor live spraakherkenning, biedt geavanceerde nauwkeurigheid in meer dan 90 talen met een ultralage latentie van 150 ms.
Dit model blinkt uit in conversationele use cases:
- Live vergadertranscriptie: Perfect voor realtime transcriptie
- AI-agents: Ideaal voor live gesprekken
- Meertalige herkenning: Ondersteunt nauwkeurige transcriptie in meer dan 90 talen met automatische taalherkenning
Belangrijkste functies:
- Ultralage latentie: ontvang gedeeltelijke transcripties in ~150 milliseconden
- Streamingondersteuning: verstuur audio in delen terwijl je realtime transcripts ontvangt
- Meerdere audioformats: ondersteuning voor PCM (8 kHz tot 48 kHz) en μ-law-codering
- Voice Activity Detection (VAD): automatische spraaksegmentatie op basis van stiltedetectie
- Handmatige commitcontrole: volledige controle over wanneer je transcriptsegmenten voltooit
- Entiteitsdetectie
- Transcriptbewerking
Lees hier meer over Scribe v2 Realtime.
Scribe v2 Medical
Scribe v2 Medical is een batchmodel voor spraakherkenning dat is gespecialiseerd in medische en klinische audio. Het is een finetune van Scribe v2 die de herkenning van medicijnnamen, anatomie, pathologie en klinisch dicteren verbetert, terwijl de nauwkeurigheid van Scribe v2 voor alledaagse spraak behouden blijft. Het gebruikt dezelfde Speech to Text API als Scribe v2 en wordt tegen hetzelfde tarief gefactureerd. Geef scribe_v2_medical door als model_id.
Beoogd gebruik
Scribe v2 Medical is een batchmodel voor de Speech-to-Text API waarmee ontwikkelaars en organisaties het kunnen integreren in applicaties die klinische audio, waaronder zorgverlener-patiëntgesprekken, dicteren, intake- en zorgcoördinatiegesprekken, omzetten in concepttranscripten voor documentatie en gerelateerde administratieve workflows. De resulterende tekst is bedoeld om vóór gebruik te worden gecontroleerd en gecorrigeerd door een zorgprofessional of andere bevoegde gebruiker. Scribe v2 Medical is niet bedoeld om klinische informatie te interpreteren of diagnoses, behandeladviezen, klinische beslissingen of andere klinische richtlijnen te geven.
Dit model is zeer geschikt voor:
- Klinische documentatie: Ambient encounters en notities waarin medische termen tijdens het gesprek naar voren komen
- Dicteren: Dichte reeksen van medicatie, doseringen en bevindingen
- Intake- en coördinatiegesprekken: Patiënten die hun eigen aandoeningen beschrijven, vaak telefonisch
- Complianceworkflows: Combineer met entiteitsdetectie voor PHI-categorieën
Belangrijkste functies:
- Dezelfde requeststructuur als Scribe v2 (
keyterms,entity_detection,no_verbatim, diarisatie, timestamps) - Verbeterde herkenning van medicijnnamen en termen voor anatomie en pathologie
- Geen achteruitgang bij alledaagse spraak ten opzichte van Scribe v2
- Ondersteuning voor meer dan 90 talen
- Sprekerdiarisatie voor audio met meerdere sprekers
- Dynamische audiotagging
- Entiteitsdetectie, inclusief PHI-categorieën
Scribe v2 Medical is een batchmodel. Gebruik voor live transcriptie Scribe v2 Realtime.
Scribe v2 Medical komt in aanmerking voor HIPAA, met Business Associate Agreements beschikbaar voor Enterprise-klanten en daarnaast Zero Retention Mode (ZRM). Als ZRM is ingeschakeld, worden de audio-invoer en tekstuitvoer direct verwijderd nadat elke request is voltooid. ElevenLabs bewaart niets en je applicatie ontvangt de volledige API-response en bewaart transcripts onder je eigen beheer.
Bedrijven die HIPAA-compliance vereisen, moeten contact opnemen met ElevenLabs Sales om een Business Associate Agreement (BAA) te ondertekenen voordat zij beschermde gezondheidsinformatie versturen.
Lees hier meer over Speech to Text.
Eleven Realtime
Eleven Realtime is een nieuwe klasse Speech to Speech-modellen voor het bouwen van natuurlijke voice agents. Elk Realtime-model is een complete voice agent: spraakherkenning, spraakactiviteitsdetectie en beurtwisseling, LLM en tekst naar spraak, door ElevenLabs geselecteerd en afgestemd om samen als één systeem te werken. Selecteer een Realtime-model en je krijgt met één keuze een goed presterende agent, zonder onderdelen die je hoeft te configureren.
Er zijn twee Realtime-modellen beschikbaar.
Eleven Realtime v1 Mini is geoptimaliseerd voor snelle, natuurlijke gesprekken en werkt goed in de volgende scenario’s:
- AI-assistenten: Snelle, expressieve dialogen waarbij het gesprek zelf het product is.
- Educatieve tutors: Natuurlijke uitwisseling die het tempo van de leerling volgt.
- Interactieve personages: Expressieve personages voor games en entertainment.
Eleven Realtime v1 Max is geoptimaliseerd voor complexe taken en werkt goed in de volgende scenario’s:
- Klantsupport: Vragen oplossen waarvoor je een proces moet volgen en informatie moet opzoeken.
- Leads kwalificeren: Gestructureerde gesprekken waarin informatie wordt verzameld en vervolgstappen worden bepaald.
- Workflows met meerdere stappen: Taken waarbij tools worden aangeroepen om informatie op te zoeken of acties uit te voeren.
Belangrijkste functies:
- Spraakherkenning, beurtwisseling, taalmodel en stem in één modelkeuze
- Natuurlijke beurtwisseling en verwerking van onderbrekingen
- Tools aanroepen
- Aanpasbare stemmen uit de stemmenbibliotheek van ElevenLabs
- Ondersteuning voor meer dan 90 talen
- Wissel tussen v1 Mini en v1 Max met een modelselectie, niet met een integratiewijziging
Eleven Realtime is beschikbaar in ElevenAgents, waar je een Realtime-model selecteert in de modeldropdown, en via de Realtime API, die is ontworpen om via WebSocket compatibel te zijn met de Realtime API van OpenAI. Als je de Realtime API van OpenAI al gebruikt, raadpleeg dan de migratiehandleiding.
Ondersteunde talen
Realtime-modellen ondersteunen meer dan 90 talen. Bekijk de taallijst voor Eleven v4.
Lees hier meer over Eleven Realtime.
Eleven Music
Eleven Music is ons model voor muziekgeneratie van studiokwaliteit. Hiermee kun je met prompts in natuurlijke taal muziek in elke stijl genereren.
Dit model is uitstekend voor de volgende scenario’s:
- Gamesoundtracks: Maak meeslepende soundtracks voor games
- Podcastachtergronden: Verrijk podcasts met professionele muziek
- Marketing: Voeg achtergrondmuziek toe aan advertentiereels
Belangrijkste functies:
- Volledige controle over genre, stijl en structuur
- Zang of alleen instrumentaal
- Meertalig, waaronder Engels, Spaans, Duits, Japans en meer
- Bewerk het geluid en de songtekst van afzonderlijke secties of het hele nummer
Lees hier meer over Eleven Music.
Gelijktijdigheid en prioriteit
Je abonnementsplan bepaalt hoeveel requests tegelijk kunnen worden verwerkt en welk prioriteitsniveau je requests in de wachtrij hebben. Speech to Text heeft een verhoogde limiet voor gelijktijdigheid. Zodra de gelijktijdigheidslimiet is bereikt, worden volgende requests in een wachtrij verwerkt samen met requests met een lagere prioriteit. In de praktijk voegt dit doorgaans slechts ~50 ms latentie toe.
De responseheaders bevatten current-concurrent-requests en maximum-concurrent-requests, waarmee je je gelijktijdigheid kunt monitoren.
API-requests per minuut versus gelijktijdige requests
Het is belangrijk om te begrijpen dat API-requests per minuut en gelijktijdige requests verschillende statistieken zijn die afhangen van je gebruikspatronen.
Het aantal API-requests per minuut kan verschillen van het aantal gelijktijdige requests, omdat dit afhangt van de duur van elke request en hoe de requests in batches worden verstuurd.
Voorbeeld 1: Gespreide requests Als je 180 requests per minuut had die elk 1 seconde nodig hadden om te voltooien en je ze met tussenpozen van 0,33 seconden verstuurde, zou het maximale aantal gelijktijdige requests 3 zijn en het gemiddelde ook 3, omdat er altijd 3 actief zouden zijn.
Voorbeeld 2: Requests in batches Als je echter een ander gebruikspatroon had, zoals 180 requests per minuut die elk 3 seconden nodig hadden om te voltooien maar allemaal tegelijk werden verstuurd, zou het maximale aantal gelijktijdige requests 180 zijn en het gemiddelde 9 (in de eerste 3 seconden van de minuut waren er 180 requests tegelijk, in de laatste 57 seconden 0 requests).
Omdat ons systeem kijkt naar gelijktijdigheid, zijn requests per minuut minder belangrijk dan de duur van elke request en het patroon waarin ze worden verstuurd.
De manier waarop endpointrequests worden gedaan, heeft invloed op gelijktijdigheidslimieten:
- Met HTTP telt elke request afzonderlijk mee voor je gelijktijdigheidslimiet.
- Met de Text to Speech WebSocket telt alleen de tijd waarin ons model audio genereert mee voor je gelijktijdigheidslimiet. Dit betekent dat een open websocket meestal helemaal niet meetelt voor je gelijktijdigheidslimiet.
- De Text to Dialogue WebSockets werken anders: elke open verbinding reserveert één dialoogsessie uit een afzonderlijke pool zolang deze open blijft, en audio die via de verbinding wordt gegenereerd telt niet mee voor je standaardgelijktijdigheidslimiet. Dit is ontworpen om eenvoudiger te begrijpen te zijn, omdat één verbinding één sessie is, en je limieten voor dialoogsessies zijn afgestemd op deze nieuwe methode voor gelijktijdigheid. Zie gelijktijdigheid voor Text to Dialogue.
Gelijktijdigheidslimieten begrijpen
De gelijktijdigheidslimiet die bij je abonnement hoort, mag niet worden geïnterpreteerd als het maximale aantal gelijktijdige gesprekken, telefoongesprekken, character voice-overs enzovoort dat tegelijk kan worden afgehandeld. Het werkelijke aantal hangt af van verschillende factoren, waaronder de specifieke gebruikte AI-stemmen en de kenmerken van de use case.
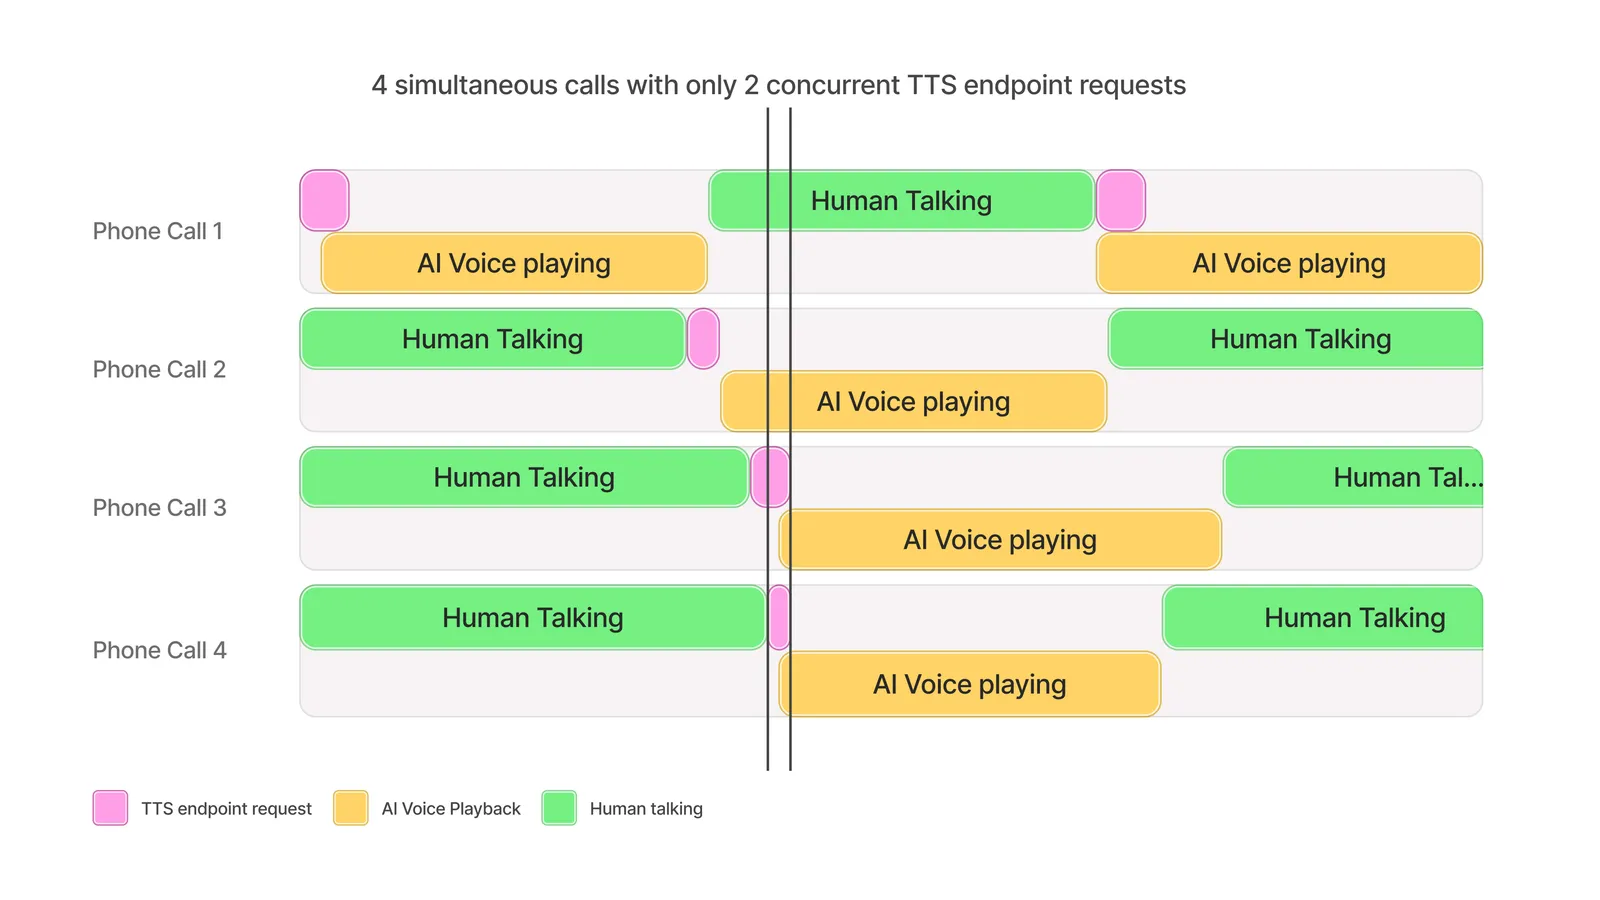
Als algemene vuistregel geldt dat een gelijktijdigheidslimiet van 5 doorgaans tot ongeveer 100 gelijktijdige audio-uitzendingen kan ondersteunen.
Dit komt door de snelheid waarmee audio wordt gegenereerd ten opzichte van de tijd die nodig is om de TTS-request te verwerken. Het onderstaande diagram laat zien hoe 4 gelijktijdige gesprekken met verschillende gebruikers mogelijk zijn, terwijl er slechts 2 gelijktijdige requests worden gebruikt.
AI-stemagents bouwen
Wanneer TTS wordt gebruikt om een dialoog mogelijk te maken, kan een gelijktijdigheidslimiet van 5 ongeveer 100 uitzendingen ondersteunen voor evenwichtige gesprekken tussen AI-agents en menselijke deelnemers.
Voor use cases waarin de AI-agent minder vaak spreekt dan de mens, zoals interacties met klantenservice, kunnen meer dan 100 gelijktijdige gesprekken worden ondersteund.
Character voice-overs
Over het algemeen kunnen meer dan 100 gelijktijdige character voice-overs worden ondersteund met een gelijktijdigheidslimiet van 5.
Het aantal kan variëren afhankelijk van de dialoogfrequentie van het personage, de lengte van pauzes en acties in de game tussen regels.
Live nasynchronisatie
Gelijktijdige nasynchronisatiestreams volgen over het algemeen de opgegeven vuistregel.
Als de uitzending momenten met gesprekspauzes bevat (bijvoorbeeld vanwege een soundtrack, visuele scènes enzovoort), zijn mogelijk meer gelijktijdige nasynchronisatiestreams mogelijk dan wordt voorgesteld.
Als je op enig moment de gelijktijdigheidslimieten van je abonnement overschrijdt en je het Enterprise-abonnement hebt, kunnen modelrequests afhankelijk van de beschikbare capaciteit alsnog slagen, zij het langzamer, op basis van best effort.
Verhoog je gelijktijdigheidslimiet en wachtrijprioriteit door je abonnementsplan te upgraden.
Enterprise-klanten kunnen een hogere gelijktijdigheidslimiet aanvragen via hun accountmanager.
Gelijktijdigheid voor Text to Dialogue
Text to Dialogue-requests worden op twee verschillende manieren gemeten, afhankelijk van hoe je de API aanroept:
- HTTP-endpoints (Create dialogue en Stream dialogue) tellen mee voor de standaardgelijktijdigheidslimiet van je abonnement terwijl audio wordt gegenereerd, net als elke andere Text to Speech-request.
- WebSocket-endpoints zoals de Text to Dialogue WebSocket worden gemeten als dialoogsessies. Een open verbinding houdt een dialoogsessie vast zolang deze open blijft, ongeacht of er momenteel audio wordt gegenereerd.
Meten op basis van sessies houdt capaciteitsplanning eenvoudig: één verbinding is één sessie, waardoor je gebruik niet fluctueert met generatieactiviteit. Omdat een sessie gedurende de hele verbinding wordt aangehouden in plaats van alleen tijdens het genereren van audio, zijn je limieten voor dialoogsessies afgestemd op deze nieuwe methode voor gelijktijdigheid.
Als je een verbinding opent terwijl alle dialoogsessies van je workspace in gebruik zijn, wordt de nieuwe verbinding geweigerd met een too_many_concurrent_requests-fout. Maak sessies vrij door verbindingen die je niet meer nodig hebt te sluiten — een verbinding sluit ook automatisch na 20 seconden inactiviteit, tenzij je keep_alive-berichten verstuurt.
Om dialoogsessies te monitoren, open je Developers onderaan de zijbalk van het dashboard, selecteer je het tabblad Analytics en bekijk je de statistiek Concurrent requests in de gebruiksweergave. Dialoogsessies worden als een eigen reeks gerapporteerd, TTD Websocket Sessions, los van je andere gelijktijdige requests.
Gelijktijdigheidslimieten op schaal testen
Testen op schaal kan nuttig zijn om schaalbaarheidsproblemen aan de clientzijde te identificeren en te verifiëren dat gelijktijdigheidslimieten correct zijn ingesteld voor je use case.
We raden sterk aan om end-to-end workflows zo dicht mogelijk bij het werkelijke gebruik te testen. De aanbevolen methode hiervoor is simuleren en meten hoeveel gebruikers kunnen worden ondersteund. Het is belangrijk om:
- Gebruikers te simuleren, geen losse requests
- Typisch gebruikersgedrag te simuleren, zoals wachten tot het afspelen van audio, spreken door de gebruiker of transcriptie is voltooid voordat requests worden gedaan
- Het aantal gebruikers geleidelijk op te schalen over een periode van enkele minuten
- Variatie toe te voegen aan de timing en omvang van requests
- Latentiemetingen en foutcodes die door de API worden teruggegeven vast te leggen
Om bijvoorbeeld een agentsysteem te testen dat is ontworpen om 100 gelijktijdige gesprekken te ondersteunen, maak je maximaal 100 afzonderlijke “gebruikers” die elk een gesprek simuleren. Gesprekken bestaan doorgaans uit een herhalende cyclus van ~10 seconden waarin de gebruiker praat, gevolgd door een TTS API-call voor ~150 tekens, gevolgd door ~10 seconden waarin audio voor de gebruiker wordt afgespeeld. Elke gebruiker moet daarom het patroon volgen om elke 20 seconden via een websocket een Text-to-Speech API-call te doen voor 150 tekens tekst, met een kleine hoeveelheid variatie in de wachttijd en het aantal aangevraagde tekens. De test bestaat uit het starten van één gebruiker per seconde totdat er 100 zijn, gevolgd door een test van in totaal 10 minuten om de algehele stabiliteit te testen.
Voorbeeldscript voor testen op schaal
Dit voorbeeld gebruikt locust als testframework met directe API-calls naar de ElevenLabs API.
Het volgt het bovenstaande voorbeeld en test een conversationeel agentsysteem waarbij elke gebruiker elke 20 seconden 1 request verstuurt.