

Modelos
Modelos destacados
Texto a Voz
Voz a Texto
Agentes de voz
Música
Descripción general de los modelos
La API de ElevenLabs ofrece una gama de modelos de audio optimizados para distintos casos de uso, niveles de calidad y requisitos de rendimiento.
† Sin incluir la latencia de la aplicación y la red. Consulta Comprender la latencia.
Modelos obsoletos
Los modelos eleven_turbo_v2_5 y eleven_turbo_v2 son funcionalmente equivalentes a los
modelos eleven_flash_v2_5 y eleven_flash_v2 respectivamente, salvo que la latencia de los modelos Flash
es menor de media. Recomendamos usar los modelos Flash en lugar de los modelos Turbo en todos los casos de
uso.
Eleven v4
Eleven v4 es nuestro modelo de síntesis de voz más avanzado, que ofrece audio de máxima calidad, expresividad y control sobre la interpretación de las voces. Eleven v4 admite clonación de voz de alta fidelidad con una preservación fiable del hablante en generaciones de texto largas.
Este modelo funciona bien en los siguientes casos:
- Locuciones de personajes: Ideal para videojuegos y animación por su gama emocional.
- Diálogo emocional: Genera diálogos naturales y realistas, con una amplia gama emocional y comprensión del contexto.
- Producción de audiolibros: Perfecto para narraciones extensas con una interpretación emocional compleja.
- Proyectos multilingües: Mantiene una calidad de voz consistente al cambiar de idioma.
Eleven v4 está disponible a través de la API de Texto a Diálogo.
Idiomas compatibles
La familia de modelos Eleven v4 admite más de 90 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), coreano (ko), kirguís (ky), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Eleven v4 Turbo
Eleven v4 Turbo es nuestro modelo más avanzado para la síntesis de voz en tiempo real, que ofrece audio de alta calidad, expresividad y control sobre la interpretación de las voces. Eleven v4 Turbo admite clonación de voz de alta fidelidad y ofrece resultados con una latencia de inferencia mediana de ~100 ms.
Este modelo funciona bien en los siguientes casos:
- Agentes de soporte: Impulsa agentes de voz que resuelven consultas de clientes en tiempo real.
- Asistentes de IA: Genera diálogos naturales y realistas, con una amplia gama emocional y comprensión del contexto.
- Personajes interactivos: Excelente para experiencias de audio con personajes expresivos.
Eleven v4 Turbo está disponible a través del WebSocket de Texto a Diálogo.
Idiomas compatibles
La familia de modelos Eleven v4 admite más de 90 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), coreano (ko), kirguís (ky), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Eleven v3
Eleven v3 es nuestro modelo de síntesis de voz de generación anterior, que produce voz natural y realista con una amplia gama emocional y comprensión del contexto en varios idiomas.
Con Eleven v3 llega una nueva API de Texto a Diálogo, que te permite generar diálogos naturales y realistas, con una amplia gama emocional y comprensión del contexto en varios idiomas. También puedes usar Eleven v3 con la API de Texto a Voz para generar voz natural y realista, con una amplia gama emocional y comprensión del contexto en varios idiomas.
Lee más sobre la API de Texto a Diálogo aquí.
Idiomas compatibles
El modelo Eleven v3 admite más de 70 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), chichewa (ny), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), kirguís (ky), coreano (ko), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational es nuestro modelo de generación anterior para la síntesis de voz en tiempo real. Produce voz natural y realista con una amplia gama emocional y comprensión del contexto en varios idiomas.
Con Eleven v3 Conversational llega un nuevo WebSocket de Texto a Diálogo, que te permite generar diálogos naturales y realistas, con una amplia gama emocional y comprensión del contexto en varios idiomas.
Con Eleven v3 Conversational llega un nuevo WebSocket de Texto a Diálogo, que te permite generar diálogos naturales y realistas, con una amplia gama emocional y comprensión del contexto en varios idiomas.
Lee más sobre el WebSocket de Texto a Diálogo aquí.
Idiomas compatibles
El modelo Eleven v3 admite más de 70 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), chichewa (ny), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), kirguís (ky), coreano (ko), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Multilingual v2
Eleven Multilingual v2 es un modelo de síntesis de voz de generación anterior con sensibilidad emocional. Produce voz natural y realista con una amplia gama emocional y comprensión del contexto en varios idiomas.
El modelo ofrece una calidad y personalidad de voz consistentes en todos los idiomas compatibles, al tiempo que conserva las características y el acento únicos del hablante.
Este modelo destaca en casos que requieren voz de alta calidad y con matices emocionales:
- Locuciones de personajes: Ideal para videojuegos y animación por su gama emocional.
- Contenido profesional: Muy adecuado para vídeos corporativos y materiales de e-learning.
- Proyectos multilingües: Mantiene una calidad de voz consistente al cambiar de idioma.
- Calidad estable: Produce una salida de audio consistente y de alta calidad.
Aunque tiene una latencia y un coste por carácter mayores que los modelos Flash, ofrece una calidad superior para proyectos en los que una voz realista es importante.
Nuestros modelos multilingües v2 son compatibles con 29 idiomas:
Inglés (EE. UU., Reino Unido, Australia, Canadá), japonés, chino, alemán, hindi, francés (Francia, Canadá), coreano, portugués (Brasil, Portugal), italiano, español (España, México), indonesio, neerlandés, turco, filipino, polaco, sueco, búlgaro, rumano, árabe (Arabia Saudí, EAU), checo, griego, finés, croata, malayo, eslovaco, danés, tamil, ucraniano y ruso.
Flash v2.5
Eleven Flash v2.5 es nuestro modelo de síntesis de voz más rápido, diseñado para aplicaciones en tiempo real y la plataforma de agentes. Ofrece voz de alta calidad con una latencia ultrabaja (~75 ms†) en 32 idiomas.
El modelo equilibra velocidad y calidad, por lo que es ideal para aplicaciones interactivas, a la vez que mantiene una salida de sonido natural y características de voz consistentes entre idiomas.
Este modelo es especialmente adecuado para:
- Plataforma de agentes: Perfecto para agentes de voz y chatbots en tiempo real.
- Aplicaciones interactivas: Ideal para juegos y aplicaciones que requieren una respuesta inmediata.
- Procesamiento a gran escala: Eficiente para la conversión masiva de texto a voz.
Con su precio más bajo para generaciones mediante API y su latencia de 75 ms, Flash v2.5 es la opción rentable para cualquiera que necesite una síntesis de voz rápida y fiable en varios idiomas.
Flash v2.5 es compatible con 32 idiomas: todos los idiomas de los modelos v2, además de:
Húngaro, noruego y vietnamita
† Sin incluir la latencia de la aplicación y la red. Consulta Información sobre la latencia.
Consideraciones
Normalización de texto con números
Al usar Flash v2.5, los números no se normalizan de forma predeterminada como podrías esperar. Por ejemplo, los números de teléfono podrían leerse de una forma poco clara para el usuario. Las fechas y las monedas se ven afectadas de manera similar.
De forma predeterminada, la normalización está desactivada en Flash v2.5 para mantener la baja latencia. Sin embargo, los clientes Enterprise ya pueden activar la normalización de texto para los modelos v2.5 estableciendo el parámetro apply_text_normalization en “on” en su solicitud.
El modelo Multilingual v2 normaliza mejor los números, por lo que recomendamos usarlo para números de teléfono y otros casos en los que la normalización de números sea importante.
Para aplicaciones de baja latencia o de la plataforma de agentes, la práctica recomendada es que tu LLM normalice el texto antes de pasarlo al modelo de TTS, o usar el parámetro apply_text_normalization (solo planes Enterprise para modelos v2.5).
Guía de selección de modelos
Para saber qué modelo se adapta mejor a tus requisitos y caso de uso, consulta la guía de selección de modelos.
Requisitos
Caso de uso
Límites de caracteres
El número máximo de caracteres admitidos en una sola solicitud de texto a voz varía según el modelo.
Scribe v2
Scribe v2 es nuestro modelo de reconocimiento de voz más avanzado, diseñado para transcripciones precisas en más de 90 idiomas. Proporciona marcas de tiempo precisas a nivel de palabra y funciones avanzadas como la diarización de hablantes y el etiquetado dinámico de audio.
Este modelo destaca en casos que requieren una conversión precisa de voz a texto:
- Servicios de transcripción: Perfecto para convertir contenido de audio o vídeo en texto
- Documentación de reuniones: Ideal para capturar y documentar conversaciones
- Análisis de contenido: Muy adecuado para el procesamiento y análisis de contenido de audio
- Reconocimiento multilingüe: Admite transcripciones precisas en más de 90 idiomas
Funciones principales:
- Transcripción precisa con marcas de tiempo a nivel de palabra
- Diarización de hablantes para audio con varios hablantes
- Etiquetado dinámico de audio para mejorar el contexto
- Compatibilidad con más de 90 idiomas
- Detección de entidades
- Prompting de términos clave
- Edición de transcripciones
Lee más sobre Scribe v2 aquí.
Scribe v2 Realtime
Scribe v2 Realtime, nuestro modelo de reconocimiento de voz en directo más rápido y preciso, ofrece una precisión de última generación en más de 90 idiomas con una latencia ultrabaja de 150 ms.
Este modelo destaca en casos de uso conversacionales:
- Transcripción de reuniones en directo: Perfecto para la transcripción en tiempo real
- Agentes de IA: Ideal para conversaciones en directo
- Reconocimiento multilingüe: Admite transcripciones precisas en más de 90 idiomas con reconocimiento automático del idioma
Funciones principales:
- Latencia ultrabaja: obtén transcripciones parciales en ~150 milisegundos
- Compatibilidad con streaming: envía audio en fragmentos mientras recibes transcripciones en tiempo real
- Varios formatos de audio: compatibilidad con PCM (de 8 kHz a 48 kHz) y codificación μ-law
- Detección de actividad de voz (VAD): segmentación automática de voz basada en la detección de silencio
- Control de confirmación manual: control total sobre cuándo finalizar los segmentos de la transcripción
- Detección de entidades
- Edición de transcripciones
Lee más sobre Scribe v2 Realtime aquí.
Scribe v2 Medical
Scribe v2 Medical es un modelo de reconocimiento de voz por lotes especializado en audio médico y clínico. Es un finetune de Scribe v2 que mejora el reconocimiento de nombres de medicamentos, anatomía, patología y dictado clínico, al tiempo que mantiene la precisión de Scribe v2 en el habla cotidiana. Utiliza la misma API de Voz a Texto que Scribe v2 y se factura a la misma tarifa. Pasa scribe_v2_medical como model_id.
Uso previsto
Scribe v2 Medical es un modelo de API de Voz a Texto por lotes para que desarrolladores y organizaciones lo integren en aplicaciones que convierten audio clínico, incluidas conversaciones entre profesionales sanitarios y pacientes, dictados, llamadas de admisión y coordinación asistencial, en borradores de transcripciones para documentación y flujos de trabajo administrativos relacionados. El texto resultante está destinado a la revisión y corrección por parte de un profesional sanitario u otro usuario autorizado antes de su uso. Scribe v2 Medical no está diseñado para interpretar información clínica ni proporcionar diagnósticos, recomendaciones de tratamiento, decisiones clínicas u otras orientaciones clínicas.
Este modelo es adecuado para:
- Documentación clínica: Consultas ambientales y notas en las que aparecen términos médicos durante la conversación
- Dictado: Secuencias densas de medicamentos, dosis y hallazgos
- Llamadas de admisión y coordinación: Pacientes que describen sus propias afecciones, a menudo por teléfono
- Flujos de trabajo de cumplimiento normativo: Combínalo con la detección de entidades para categorías de PHI
Funciones principales:
- Misma estructura de solicitud que Scribe v2 (
keyterms,entity_detection,no_verbatim, diarización, marcas de tiempo) - Mejor reconocimiento de nombres de medicamentos y términos de anatomía y patología
- Sin pérdida de rendimiento en el habla cotidiana frente a Scribe v2
- Compatibilidad con más de 90 idiomas
- Diarización de hablantes para audio con varios hablantes
- Etiquetado dinámico de audio
- Detección de entidades, incluidas categorías de PHI
Scribe v2 Medical es un modelo por lotes. Para transcripción en directo, usa Scribe v2 Realtime.
Scribe v2 Medical cumple los requisitos de HIPAA, con acuerdos de asociado comercial disponibles para clientes Enterprise, así como el modo de retención cero (ZRM). Con ZRM activado, la entrada de audio y la salida de texto se eliminan inmediatamente después de que se complete cada solicitud. ElevenLabs no retiene nada, y tu aplicación recibe la respuesta completa de la API y conserva las transcripciones bajo tus propios controles.
Las empresas que requieran el cumplimiento de HIPAA deben contactar con Ventas de ElevenLabs para firmar un Acuerdo de Asociado Comercial (BAA) antes de enviar información sanitaria protegida.
Lee más sobre Voz a Texto aquí.
Eleven Realtime
Eleven Realtime es una nueva clase de modelos de Voz a Voz para crear agentes de voz naturales. Cada modelo Realtime es un agente de voz completo: reconocimiento de voz, detección de actividad de voz y gestión de turnos, LLM y texto a voz, seleccionados y ajustados por ElevenLabs para funcionar juntos como un solo sistema. Selecciona un modelo Realtime y obtendrás un agente de buen rendimiento con una sola elección, sin componentes que configurar.
Hay dos modelos Realtime disponibles.
Eleven Realtime v1 Mini está optimizado para conversaciones rápidas y naturales, y funciona bien en los siguientes casos:
- Asistentes de IA: Diálogo rápido y expresivo en el que la conversación en sí es el producto.
- Tutores educativos: Interacción natural que sigue el ritmo del alumno.
- Personajes interactivos: Personajes expresivos para juegos y entretenimiento.
Eleven Realtime v1 Max está optimizado para tareas complejas y funciona bien en los siguientes casos:
- Atención al cliente: Resolver consultas que requieren seguir un proceso y buscar información.
- Cualificación de leads: Conversaciones estructuradas que recopilan información y deciden los siguientes pasos.
- Flujos de trabajo de varios pasos: Tareas que llaman a herramientas para buscar información o realizar acciones.
Funciones principales:
- Reconocimiento de voz, gestión de turnos, modelo de lenguaje y voz en una sola elección de modelo
- Gestión natural de turnos e interrupciones
- Llamadas a herramientas
- Voces personalizables de la biblioteca de voces de ElevenLabs
- Compatibilidad con más de 90 idiomas
- Cambia entre v1 Mini y v1 Max con una selección de modelo, sin cambiar la integración
Eleven Realtime está disponible en ElevenAgents, donde seleccionas un modelo Realtime en el menú desplegable de modelos, y a través de la API Realtime, diseñada para ser compatible con la API Realtime de OpenAI mediante WebSocket. Si ya utilizas la API Realtime de OpenAI, consulta la guía de migración.
Idiomas compatibles
Los modelos Realtime admiten más de 90 idiomas. Consulta la lista de idiomas de Eleven v4.
Lee más sobre Eleven Realtime aquí.
Eleven Music
Eleven Music es nuestro modelo de generación de música con calidad de estudio. Te permite generar música de cualquier estilo mediante prompts en lenguaje natural.
Este modelo es excelente para los siguientes casos:
- Bandas sonoras para juegos: Crea bandas sonoras inmersivas para juegos
- Música de fondo para podcasts: Mejora podcasts con música profesional
- Marketing: Añade música de fondo a reels publicitarios
Funciones principales:
- Control total sobre el género, el estilo y la estructura
- Voz o solo instrumental
- Multilingüe, incluidos inglés, español, alemán, japonés y más
- Edita el sonido y la letra de secciones individuales o de toda la canción
Lee más sobre Eleven Music aquí.
Concurrencia y prioridad
Tu plan de suscripción determina cuántas solicitudes se pueden procesar simultáneamente y el nivel de prioridad de tus solicitudes en la cola. Voz a Texto tiene un límite de concurrencia más alto. Una vez alcanzado el límite de concurrencia, las solicitudes posteriores se procesan en una cola junto con solicitudes de menor prioridad. En la práctica, esto normalmente solo añade unos ~50 ms de latencia.
Las cabeceras de respuesta incluyen current-concurrent-requests y maximum-concurrent-requests, que puedes usar para supervisar tu concurrencia.
Solicitudes a la API por minuto frente a solicitudes simultáneas
Es importante entender que las solicitudes a la API por minuto y las solicitudes simultáneas son métricas diferentes que dependen de tus patrones de uso.
Las solicitudes a la API por minuto pueden diferir de las solicitudes simultáneas, ya que dependen de la duración de cada solicitud y de cómo se agrupan las solicitudes.
Ejemplo 1: Solicitudes espaciadas Si tuvieras 180 solicitudes por minuto, cada una tardara 1 segundo en completarse y las enviaras con 0,33 segundos de separación, el máximo de solicitudes simultáneas sería 3 y la media también sería 3, ya que siempre habría 3 en curso.
Ejemplo 2: Solicitudes por lotes Sin embargo, si tuvieras un patrón de uso diferente, como 180 solicitudes por minuto que tardaran 3 segundos en completarse pero se activaran todas a la vez, el máximo de solicitudes simultáneas sería 180 y la media sería 9 (en los primeros 3 segundos del minuto habría 180 solicitudes a la vez y en los últimos 57 segundos habría 0 solicitudes).
Como nuestro sistema se centra en la concurrencia, las solicitudes por minuto importan menos que la duración de cada solicitud y el patrón con el que se envían.
La forma en que se realizan las solicitudes a las rutas de API afecta a los límites de concurrencia:
- Con HTTP, cada solicitud cuenta individualmente para tu límite de concurrencia.
- Con el WebSocket de Texto a Voz, solo cuenta para tu límite de concurrencia el tiempo durante el que nuestro modelo genera audio. Esto significa que, durante la mayor parte del tiempo, un websocket abierto no cuenta en absoluto para tu límite de concurrencia.
- Los WebSockets de Texto a Diálogo funcionan de forma diferente: cada conexión abierta reserva una sesión de diálogo de un grupo independiente mientras permanezca abierta, y el audio generado a través de la conexión no cuenta para tu límite de concurrencia estándar. Esto está diseñado para que sea más fácil de entender: una conexión es una sesión, y los límites de sesiones de diálogo están dimensionados para adaptarse a esta nueva metodología de concurrencia. Consulta concurrencia de Texto a Diálogo.
Comprender los límites de concurrencia
El límite de concurrencia asociado a tu plan no debe interpretarse como el número máximo de conversaciones simultáneas, llamadas telefónicas, locuciones de personajes, etc., que se pueden gestionar a la vez. El número real depende de varios factores, entre ellos las voces IA específicas utilizadas y las características del caso de uso.
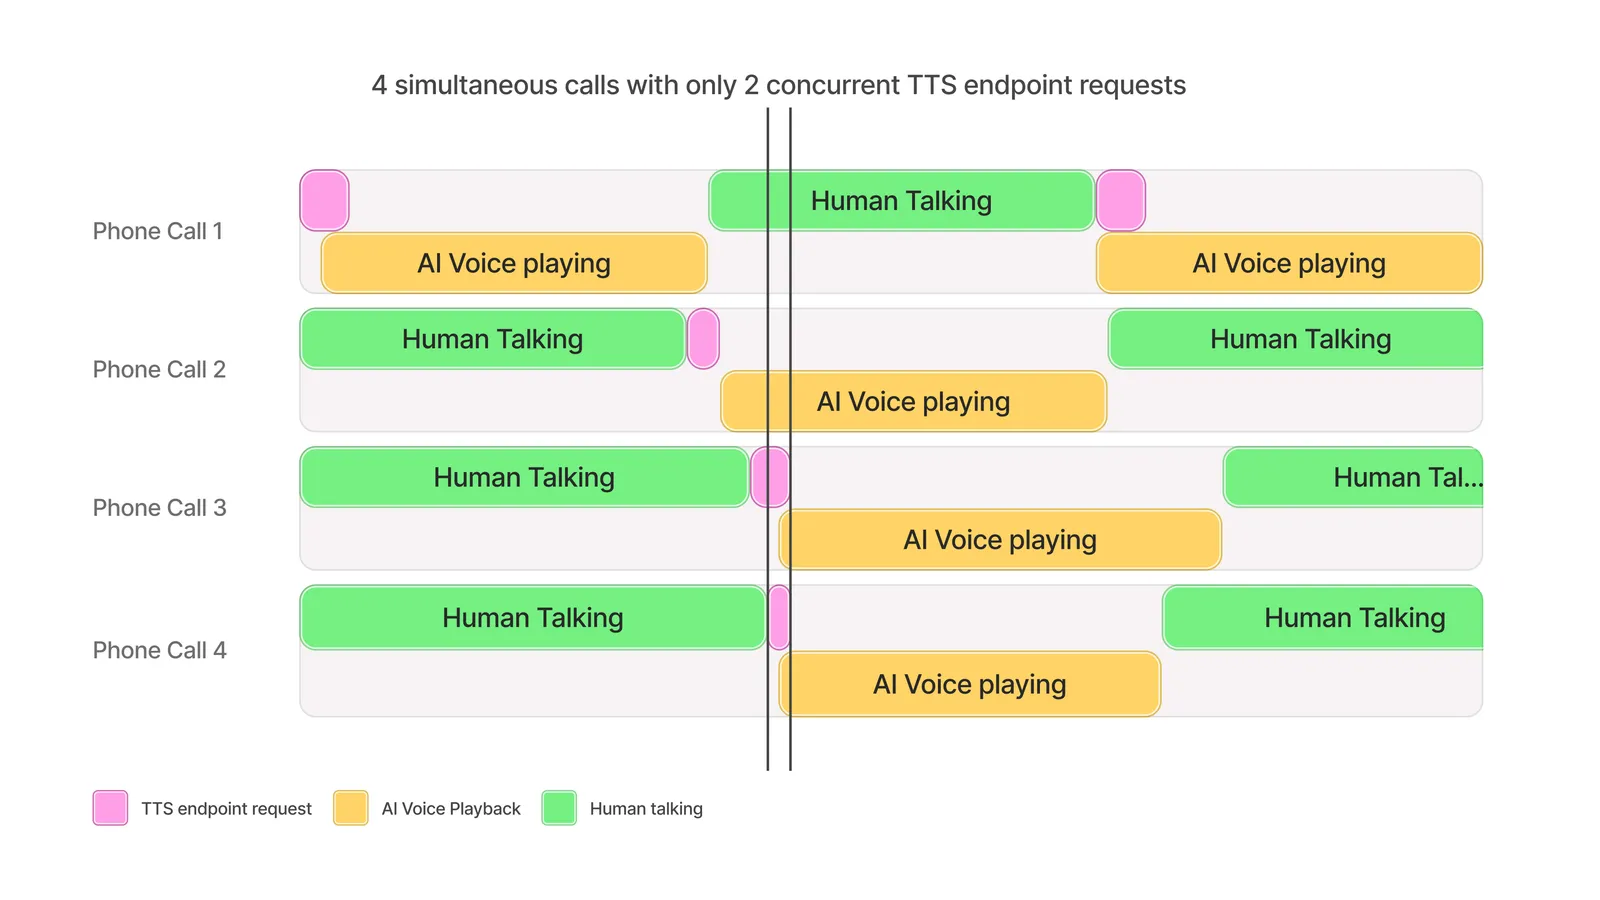
Como norma general, un límite de concurrencia de 5 suele poder admitir aproximadamente hasta 100 retransmisiones de audio simultáneas.
Esto se debe a la velocidad a la que se genera el audio en relación con el tiempo que tarda en procesarse la solicitud de TTS. El siguiente diagrama muestra un ejemplo de cómo se pueden realizar 4 llamadas simultáneas con distintos usuarios mientras solo se alcanzan 2 solicitudes simultáneas.
Crear agentes de voz IA
Cuando se usa TTS para facilitar el diálogo, un límite de concurrencia de 5 puede admitir unas 100 retransmisiones para conversaciones equilibradas entre agentes de IA y participantes humanos.
En casos de uso en los que el agente de IA habla con menos frecuencia que la persona, como las interacciones de atención al cliente, se podrían admitir más de 100 conversaciones simultáneas.
Locuciones de personajes
En general, se pueden admitir más de 100 locuciones de personajes simultáneas con un límite de concurrencia de 5.
El número puede variar según la frecuencia de diálogo del personaje, la duración de las pausas y las acciones dentro del juego entre líneas.
Doblaje en directo
Las transmisiones de doblaje simultáneas suelen seguir la heurística proporcionada.
Si la retransmisión incluye periodos de pausas conversacionales (por ejemplo, debido a una banda sonora, escenas visuales, etc.), podrían ser posibles más transmisiones de doblaje simultáneas de las sugeridas.
Si superas los límites de concurrencia de tu plan en algún momento y tienes el plan Enterprise, las solicitudes al modelo podrían seguir realizándose, aunque más lentamente, según la capacidad disponible y sin garantía de servicio.
Para aumentar tu límite de concurrencia y la prioridad en la cola, mejora tu plan de suscripción .
Los clientes Enterprise pueden solicitar un límite de concurrencia mayor contactando con su gestor de cuenta.
Concurrencia de Texto a Diálogo
Las solicitudes de Texto a Diálogo se miden de dos maneras distintas según cómo llames a la API:
- Las rutas de API HTTP (Crear diálogo y Transmitir diálogo) cuentan para el límite de concurrencia estándar de tu plan mientras se genera audio, como cualquier otra solicitud de Texto a Voz.
- Las rutas de API WebSocket, como el WebSocket de Texto a Diálogo, se miden como sesiones de diálogo. Una conexión abierta mantiene una sesión de diálogo mientras permanezca abierta, independientemente de si se está generando audio en ese momento.
La medición basada en sesiones simplifica la planificación de capacidad: una conexión es una sesión, por lo que tu uso no fluctúa con la actividad de generación. Como una sesión se mantiene durante toda la conexión y no solo mientras se genera audio, los límites de sesiones de diálogo están dimensionados para adaptarse a esta nueva metodología de concurrencia.
Si abres una conexión mientras todas las sesiones de diálogo de tu espacio de trabajo están en uso, la nueva conexión se rechaza con un error too_many_concurrent_requests. Para liberar sesiones, cierra las conexiones que ya no necesites; una conexión también se cierra automáticamente tras 20 segundos de inactividad, salvo que envíes mensajes keep_alive.
Para supervisar las sesiones de diálogo, abre Developers en la parte inferior de la barra lateral del panel de control, selecciona la pestaña Analytics y consulta la métrica Concurrent requests en la vista Usage. Las sesiones de diálogo se muestran como una serie propia, TTD Websocket Sessions, independiente de tus otras solicitudes simultáneas.
Límites de concurrencia para pruebas de escalado
Las pruebas de escalado pueden ser útiles para identificar problemas de escalado del lado del cliente y verificar que los límites de concurrencia estén configurados correctamente para tu caso de uso.
Es muy recomendable probar flujos de trabajo de principio a fin lo más cercanos posible al uso real; la metodología recomendada para conseguirlo consiste en simular y medir cuántos usuarios se pueden admitir. Es importante:
- Simular usuarios, no solicitudes sin procesar
- Simular comportamientos habituales de los usuarios, como esperar a que termine la reproducción de audio, que el usuario hable o que finalice la transcripción antes de realizar solicitudes
- Aumentar lentamente el número de usuarios durante un periodo de varios minutos
- Introducir aleatoriedad en los tiempos de las solicitudes y en su tamaño
- Recopilar métricas de latencia y cualquier código de error devuelto por la API
Por ejemplo, para probar un sistema de agentes diseñado para admitir 100 conversaciones simultáneas, crearías hasta 100 «usuarios» individuales, cada uno simulando una conversación. Las conversaciones suelen consistir en un ciclo repetido de unos 10 segundos en los que habla el usuario, seguidos de una llamada a la API de TTS para unos 150 caracteres, seguida de unos 10 segundos de reproducción de audio para el usuario. Por tanto, cada usuario debería seguir el patrón de realizar una llamada a la API de Texto a Voz mediante websocket para 150 caracteres de texto cada 20 segundos, introduciendo una pequeña aleatoriedad en el periodo de espera y el número de caracteres solicitados. La prueba consistiría en generar un usuario por segundo hasta alcanzar 100 y, después, realizar pruebas durante 10 minutos en total para comprobar la estabilidad general.
Ejemplo de script para pruebas de escalado
Este ejemplo usa locust como framework de pruebas con llamadas directas a la API de ElevenLabs.
Sigue el ejemplo descrito anteriormente y prueba un sistema de agentes conversacionales en el que cada usuario envía 1 solicitud cada 20 segundos.