

モデル
主力モデル
テキスト読み上げ
スピーチtoテキスト
音声エージェント
音楽
モデル概要
ElevenLabs APIは、さまざまなユースケース、品質レベル、パフォーマンス要件に最適化された幅広いオーディオモデルを提供しています。
† アプリケーションとネットワークのレイテンシは含まれません。レイテンシについて 理解する をご覧ください。
非推奨モデル
eleven_turbo_v2_5およびeleven_turbo_v2モデルは、それぞれ
eleven_flash_v2_5およびeleven_flash_v2モデルと機能的には同等ですが、Flash
モデルの方が平均レイテンシは低くなります。すべてのユース
ケースで、TurboモデルよりFlashモデルの使用をおすすめします。
Eleven v4
Eleven v4は、最高品質のオーディオ、豊かな表現力、音声表現の細かなコントロールを実現する、最先端の音声合成モデルです。Eleven v4は、高忠実度のボイスクローンに対応し、長文生成でも話者の特徴を安定して維持します。
このモデルは、次のようなシナリオに適しています。
- キャラクターボイスオーバー:豊かな感情表現により、ゲームやアニメーションに最適です。
- 感情豊かな対話:幅広い感情表現と文脈理解を備えた、自然で臨場感のある対話を生成します。
- オーディオブック制作:複雑な感情表現を伴う長尺ナレーションに最適です。
- 多言語プロジェクト:言語を切り替えても一貫した音声品質を維持します。
Eleven v4は、テキストtoダイアログAPIで利用できます。
対応言語
Eleven v4モデルファミリーは、以下を含む90以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、韓国語(ko)、キルギス語(ky)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Eleven v4 Turbo
Eleven v4 Turboは、リアルタイム音声合成向けの最先端モデルで、高品質なオーディオ、豊かな表現力、音声表現の細かなコントロールを実現します。Eleven v4 Turboは高忠実度のボイスクローンに対応し、推論レイテンシーの中央値約100msで結果を提供します。
このモデルは、次のようなシナリオに適しています。
- サポートエージェント:顧客からの問い合わせをリアルタイムで解決する音声エージェントを構築できます。
- AIアシスタント:幅広い感情表現と文脈理解を備えた、自然で臨場感のある対話を生成します。
- インタラクティブキャラクター:表現豊かなキャラクターを使ったオーディオ体験に最適です。
Eleven v4 Turboは、テキストtoダイアログWebSocketで利用できます。
対応言語
Eleven v4モデルファミリーは、以下を含む90以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、韓国語(ko)、キルギス語(ky)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Eleven v3
Eleven v3は前世代の音声合成モデルで、複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある音声を生成します。
Eleven v3では、新しいテキストtoダイアログAPIを利用できます。これにより、複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある対話を生成できます。Eleven v3は、テキスト読み上げAPIと組み合わせて、複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある音声を生成することもできます。
テキストtoダイアログAPIの詳細はこちらをご覧ください。
対応言語
Eleven v3モデルは、以下を含む70以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、チチェワ語(ny)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、キルギス語(ky)、韓国語(ko)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Eleven v3 Conversational
Eleven v3 Conversationalは、リアルタイム音声合成向けの前世代モデルです。複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある音声を生成します。
Eleven v3 Conversationalでは、新しいテキストtoダイアログWebSocketを利用できます。これにより、複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある対話を生成できます。
Eleven v3 Conversationalでは、新しいテキストtoダイアログWebSocketを利用できます。これにより、複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある対話を生成できます。
テキストtoダイアログWebSocketの詳細はこちらをご覧ください。
対応言語
Eleven v3モデルは、以下を含む70以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、チチェワ語(ny)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、キルギス語(ky)、韓国語(ko)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Multilingual v2
Eleven Multilingual v2は、感情を理解する前世代の音声合成モデルです。複数の言語にわたり、幅広い感情表現と文脈理解を備えた自然で臨場感のある音声を生成します。
このモデルは、話者固有の特徴やアクセントを維持しながら、対応するすべての言語で一貫した音声品質と個性を提供します。
このモデルは、高品質で感情表現豊かな音声が求められる次のような場面で優れています。
- キャラクターボイスオーバー:豊かな感情表現により、ゲームやアニメーションに最適です。
- プロフェッショナルコンテンツ:企業ビデオやeラーニング教材に適しています。
- 多言語プロジェクト:言語を切り替えても一貫した音声品質を維持します。
- 安定した品質:一貫して高品質なオーディオを出力します。
Flashモデルと比べてレイテンシーと1文字あたりのコストは高くなりますが、臨場感のある音声が重要なプロジェクトでは優れた品質を提供します。
Multilingual v2モデルは、29言語に対応しています。
英語(米国、英国、オーストラリア、カナダ)、日本語、中国語、ドイツ語、ヒンディー語、フランス語(フランス、カナダ)、韓国語、ポルトガル語(ブラジル、ポルトガル)、イタリア語、スペイン語(スペイン、メキシコ)、インドネシア語、オランダ語、トルコ語、フィリピン語、ポーランド語、スウェーデン語、ブルガリア語、ルーマニア語、アラビア語(サウジアラビア、アラブ首長国連邦)、チェコ語、ギリシャ語、フィンランド語、クロアチア語、マレー語、スロバキア語、デンマーク語、タミル語、ウクライナ語、ロシア語。
Flash v2.5
Eleven Flash v2.5は、リアルタイムアプリケーションとAgents Platform向けに設計された、最速の音声合成モデルです。32言語で、超低レイテンシー(約75ms†)の高品質な音声を提供します。
このモデルは速度と品質のバランスに優れ、自然な出力と、言語間で一貫した音声特性を維持しながら、インタラクティブなアプリケーションに最適です。
このモデルは特に次の用途に適しています。
- Agents Platform:リアルタイム音声エージェントやチャットボットに最適です。
- インタラクティブアプリケーション:即時応答が求められるゲームやアプリケーションに最適です。
- 大規模処理:大量のテキスト読み上げ変換を効率的に処理できます。
API生成の低価格と75msのレイテンシーにより、Flash v2.5は複数言語で高速かつ信頼性の高い音声合成を必要とするあらゆる方にとって、費用対効果の高い選択肢です。
Flash v2.5は、v2モデルのすべての言語に加え、以下を含む32言語に対応しています。
ハンガリー語、ノルウェー語、ベトナム語
† アプリケーションとネットワークのレイテンシーを除きます。レイテンシーについて をご覧ください。
考慮事項
数字のテキスト正規化
Flash v2.5を使用する場合、数字は想定どおりにはデフォルトで正規化されません。たとえば電話番号は、ユーザーにとって分かりにくい方法で読み上げられることがあります。日付や通貨についても同様です。
Flash v2.5では低レイテンシーを維持するため、デフォルトで正規化が無効になっています。ただし、エンタープライズのお客様は、リクエストで apply_text_normalization パラメーターを”on”に設定することで、v2.5モデルのテキスト正規化を有効にできます。
Multilingual v2モデルは数字の正規化により適しているため、電話番号など、数字の正規化が重要なケースにはこのモデルをおすすめします。
低レイテンシーまたはAgents Platformアプリケーションでは、TTSモデルに渡す前にLLMでテキストを正規化するか、apply_text_normalization パラメーターを使用するのがベストプラクティスです(v2.5モデルではエンタープライズプランのみ)。
モデル選択ガイド
要件やユースケースに最適なモデルについては、モデル選択ガイドをご覧ください。
要件
ユースケース
文字数上限
1回のテキスト読み上げリクエストで対応できる最大文字数は、モデルによって異なります。
Scribe v2
Scribe v2は、90以上の言語で正確な文字起こしを行うために設計された最先端の音声認識モデルです。正確な単語単位のタイムスタンプに加え、話者ダイアライゼーションや動的オーディオタグ付けなどの高度な機能を提供します。
このモデルは、正確なスピーチtoテキスト変換が必要な次のような場面で優れています。
- 文字起こしサービス:オーディオやビデオのコンテンツをテキストに変換するのに最適です。
- 会議ドキュメント:会話を記録・文書化するのに最適です。
- コンテンツ分析:オーディオコンテンツの処理と分析に適しています。
- 多言語認識:90以上の言語で正確な文字起こしに対応します。
主な機能:
- 単語単位のタイムスタンプを含む正確な文字起こし
- 複数話者のオーディオ向け話者ダイアライゼーション
- 文脈を強化する動的オーディオタグ付け
- 90以上の言語に対応
- エンティティ検出
- キータームプロンプト
- 文字起こし編集
Scribe v2の詳細はこちらをご覧ください。
Scribe v2 Realtime
Scribe v2 Realtimeは、最速かつ最高精度のライブ音声認識モデルです。90以上の言語で最先端の精度を実現し、超低レイテンシーの150msを提供します。
このモデルは、会話型のユースケースで優れています。
- ライブ会議の文字起こし:リアルタイム文字起こしに最適です。
- AIエージェント:ライブ会話に最適です。
- 多言語認識:自動言語認識により、90以上の言語で正確な文字起こしに対応します。
主な機能:
- 超低レイテンシー:約150ミリ秒で部分的な文字起こしを取得
- ストリーミング対応:オーディオをチャンクで送信しながら、リアルタイムで文字起こしを受信
- 複数のオーディオ形式:PCM(8kHz~48kHz)とμ-lawエンコーディングに対応
- 音声アクティビティ検出(VAD):無音検出に基づく自動音声セグメンテーション
- 手動コミット制御:文字起こしセグメントを確定するタイミングを完全に制御
- エンティティ検出
- 文字起こし編集
Scribe v2 Realtimeの詳細はこちらをご覧ください。
Scribe v2 Medical
Scribe v2 Medicalは、医療・臨床オーディオに特化したバッチ音声認識モデルです。Scribe v2を微調整したモデルで、日常会話におけるScribe v2と同等の精度を維持しながら、薬剤名、解剖学、病理学、臨床口述の認識を向上させます。Scribe v2と同じスピーチtoテキストAPIを使用し、料金も同一です。model_id として scribe_v2_medical を指定してください。
使用目的
Scribe v2 Medicalは、臨床医と患者の会話、口述、受付・ケア連携の通話などの臨床オーディオを、文書化や関連する管理業務のための下書き文字起こしに変換するアプリケーションへ、デベロッパーや組織が統合するためのバッチスピーチtoテキストAPIモデルです。生成されたテキストは、使用前に医療従事者またはその他の認可されたユーザーが確認・修正することを前提としています。Scribe v2 Medicalは、臨床情報の解釈、診断、治療の推奨、臨床上の判断、その他の臨床ガイダンスの提供を目的としたものではありません。
このモデルは、次の用途に適しています。
- 臨床文書化:会話の途中で医療用語が出てくるアンビエント診療やメモ
- 口述:薬剤、投与量、所見が密に連続する内容
- 受付・連携通話:患者が自身の症状を説明する通話(電話で行われることが多い)
- コンプライアンスワークフロー:PHIカテゴリにはエンティティ検出と組み合わせて使用
主な機能:
- Scribe v2と同じリクエスト形式(
keyterms、entity_detection、no_verbatim、ダイアライゼーション、タイムスタンプ) - 薬剤名、解剖学、病理学用語の認識を向上
- Scribe v2と比較して日常会話の精度低下なし
- 90以上の言語に対応
- 複数話者のオーディオ向け話者ダイアライゼーション
- 動的オーディオタグ付け
- PHIカテゴリを含むエンティティ検出
Scribe v2 Medicalはバッチモデルです。ライブ文字起こしには、Scribe v2 Realtimeを使用してください。
Scribe v2 MedicalはHIPAAの対象であり、エンタープライズのお客様には業務提携契約(BAA)およびゼロ保持モード(ZRM)を提供しています。ZRMを有効にすると、各リクエストの完了直後にオーディオ入力とテキスト出力が削除されます。ElevenLabsは何も保持せず、アプリケーションは完全なAPIレスポンスを受け取り、独自の管理下で文字起こしを保持します。
HIPAA準拠が必要な企業は、保護対象保健情報を送信する前に、ElevenLabs Salesへ連絡して業務提携契約(BAA)を締結する必要があります。
スピーチtoテキストの詳細はこちらをご覧ください。
Eleven Realtime
Eleven Realtimeは、自然な音声エージェントを構築するための新しいスピーチtoスピーチモデル群です。各Realtimeモデルは、完全な音声エージェントです。音声認識、音声アクティビティ検出とターンテイキング、LLM、テキスト読み上げを、1つのシステムとして連携するようElevenLabsが選定・調整しています。Realtimeモデルを選択するだけで、設定が必要なコンポーネントなしに、優れた性能のエージェントを利用できます。
2つのRealtimeモデルを利用できます。
Eleven Realtime v1 Mini は、高速で自然な会話向けに最適化されており、次のようなシナリオに適しています。
- AIアシスタント:会話そのものがプロダクトとなる、高速で表現豊かな対話。
- 教育チューター:学習者のペースに合わせた自然なやり取り。
- インタラクティブキャラクター:ゲームやエンターテインメント向けの表現豊かなキャラクター。
Eleven Realtime v1 Max は、複雑なタスク向けに最適化されており、次のようなシナリオに適しています。
- カスタマーサポート:プロセスに従い、情報を検索する必要がある問い合わせの解決。
- リードの選別:情報を収集し、次のステップを判断する構造化された会話。
- 複数ステップのワークフロー:ツールを呼び出して情報を検索したり、アクションを実行したりするタスク。
主な機能:
- 音声認識、ターンテイキング、言語モデル、音声を1つのモデル選択で利用
- 自然なターンテイキングと割り込み処理
- ツール呼び出し
- ElevenLabsボイスライブラリのカスタマイズ可能な音声
- 90以上の言語に対応
- インテグレーションを変更せず、モデル選択だけでv1 Miniとv1 Maxを切り替え
Eleven Realtimeは、モデルのドロップダウンからRealtimeモデルを選択できるElevenAgentsと、WebSocket経由でOpenAIのRealtime APIとの互換性を持つよう設計されたRealtime APIで利用できます。すでにOpenAIのRealtime APIを使用している場合は、移行ガイドをご覧ください。
対応言語
Realtimeモデルは90以上の言語に対応しています。Eleven v4の言語リストをご覧ください。
Eleven Realtimeの詳細はこちらをご覧ください。
Eleven Music
Eleven Musicは、スタジオ品質の音楽生成モデルです。自然言語のプロンプトで、あらゆるスタイルの音楽を生成できます。
このモデルは、次のようなシナリオに最適です。
- ゲームサウンドトラック:ゲーム向けの没入感あるサウンドトラックを作成
- ポッドキャストのBGM:プロ品質の音楽でポッドキャストを強化
- マーケティング:広告リールにBGMを追加
主な機能:
- ジャンル、スタイル、構成を完全にコントロール
- ボーカルあり、またはインストゥルメンタルのみ
- 英語、スペイン語、ドイツ語、日本語などを含む多言語対応
- 個々のセクションまたは曲全体のサウンドと歌詞を編集
Eleven Musicの詳細はこちらをご覧ください。
同時実行数と優先度
サブスクリプションプランによって、同時に処理できるリクエスト数と、キュー内でのリクエストの優先度が決まります。 スピーチtoテキストでは、同時実行数の上限が引き上げられています。 同時実行数の上限に達すると、以降のリクエストは優先度の低いリクエストとともにキューで処理されます。 通常、これによる遅延の増加は約50ms程度です。
レスポンスヘッダーには、同時実行数を監視するための current-concurrent-requests と maximum-concurrent-requests が含まれます。
1分あたりのAPIリクエスト数と同時リクエスト数
1分あたりのAPIリクエスト数と同時リクエスト数は、利用パターンによって異なる指標であることを理解しておくことが重要です。
1分あたりのAPIリクエスト数は、各リクエストの処理時間やリクエストのバッチ処理方法に左右されるため、同時リクエスト数とは異なる場合があります。
例1:間隔を空けたリクエスト 1分あたり180件のリクエストがあり、それぞれの完了に1秒かかり、0.33秒間隔で送信した場合、常に3件のリクエストが処理中となるため、最大同時リクエスト数は3、平均も3になります。
例2:バッチ処理されたリクエスト 一方、それぞれの完了に3秒かかる1分あたり180件のリクエストをすべて同時に送信するような異なる利用パターンでは、最大同時リクエスト数は180、平均は9になります(最初の3秒間は180件のリクエストが同時にあり、残りの57秒間は0件です)。
システムでは同時実行数を重視するため、1分あたりのリクエスト数よりも、各リクエストにかかる時間と送信タイミングのパターンのほうが重要です。
エンドポイントへのリクエスト方法は、同時実行数の上限に影響します。
- HTTPでは、各リクエストが個別に同時実行数の上限にカウントされます。
- テキスト読み上げWebSocketでは、モデルがオーディオを生成している時間だけが同時実行数の上限にカウントされます。つまり、ほとんどの時間では、接続中のWebSocketは同時実行数の上限にまったくカウントされません。
- テキストtoダイアログWebSocketの仕組みは異なります。接続が開いている間は、接続ごとに別のプールから1つのダイアログセッションが予約され、その接続で生成されたオーディオは通常の同時実行数の上限にカウントされません。1接続が1セッションとなるため理解しやすく、ダイアログセッションの上限はこの新しい同時実行方式に合わせて設定されています。詳しくは、テキストtoダイアログの同時実行数をご覧ください。
同時実行数の上限について
プランに紐づく同時実行数の上限は、同時に処理できる会話、電話、キャラクターボイスオーバーなどの最大数を示すものではありません。 実際の数は、使用するAI音声やユースケースの特性など、複数の要因によって異なります。
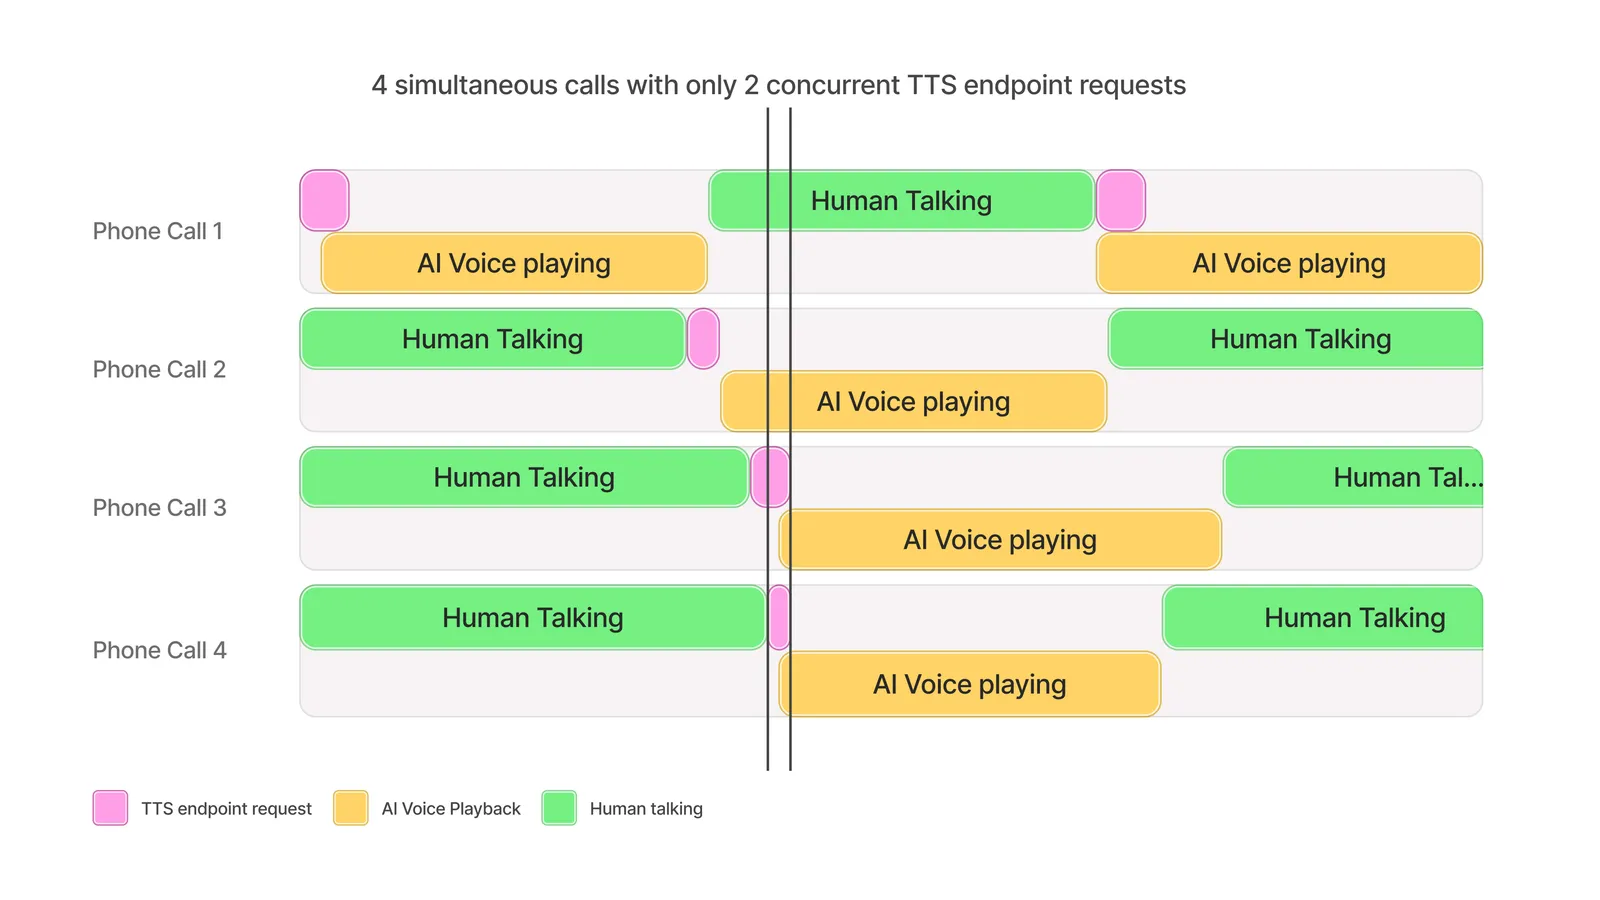
一般的な目安として、同時実行数の上限が5の場合、通常は最大約100件の同時オーディオ配信をサポートできます。
これは、オーディオの生成速度と、TTSリクエストの処理にかかる時間の関係によるものです。 以下の図は、異なるユーザーとの4件の同時通話を、同時リクエスト数が2に達するだけで処理する例です。
AI音声エージェントの構築
TTSをダイアログに使用する場合、同時実行数の上限が5であれば、AIエージェントと人間の参加者によるバランスの取れた会話で約100件の配信をサポートできます。
カスタマーサポートのように、AIエージェントの発話頻度が人間より低いユースケースでは、100件を超える同時会話をサポートできる場合があります。
キャラクターボイスオーバー
一般に、同時実行数の上限が5の場合、100件を超える同時キャラクターボイスオーバーをサポートできます。
数は、キャラクターのダイアログ頻度、間の長さ、セリフ間のゲーム内アクションによって異なります。
ライブ吹き替え
同時吹き替えストリームは、通常、提示された目安に従います。
配信に会話の間がある場合(例:サウンドトラックや映像シーンなどによる間)、目安より多くの同時吹き替えストリームが可能な場合があります。
プランの同時実行数の上限を超えた場合でも、エンタープライズプランでは、利用可能なキャパシティに応じてベストエフォートで、低速ながらモデルリクエストが成功することがあります。
同時実行数の上限とキューの優先度を引き上げるには、サブスクリプションプランをアップグレード してください。
エンタープライズのお客様は、アカウントマネージャーに連絡して、より高い同時実行数の上限をリクエストできます。
テキストtoダイアログの同時実行数
テキストtoダイアログリクエストは、APIの呼び出し方法に応じて2つの方法で計測されます。
- HTTPエンドポイント(ダイアログを作成およびダイアログをストリーミング)は、他のテキスト読み上げリクエストと同様に、オーディオの生成中はプランの標準同時実行数の上限にカウントされます。
- テキストtoダイアログWebSocketなどのWebSocketエンドポイントは、ダイアログセッションとして計測されます。オーディオを生成しているかどうかにかかわらず、接続が開いている間はダイアログセッションが1つ使用されます。
セッションベースの計測により、キャパシティ計画をシンプルに保てます。1接続が1セッションとなるため、生成アクティビティによって使用量が変動しません。セッションはオーディオ生成中だけでなく接続全体で使用されるため、ダイアログセッションの上限はこの新しい同時実行方式に合わせて設定されています。
ワークスペースのすべてのダイアログセッションが使用中の状態で接続を開こうとすると、新しい接続は too_many_concurrent_requests エラーで拒否されます。セッションを解放するには、不要になった接続を閉じてください。keep_alive メッセージを送信しない限り、接続は20秒間の非アクティブ状態の後に自動的に閉じられます。
ダイアログセッションを監視するには、ダッシュボードのサイドバー下部にある開発者を開き、分析タブを選択して、使用状況ビューの同時リクエスト数指標を確認します。ダイアログセッションは、他の同時リクエストとは別に、TTD Websocket Sessionsという独自の系列として表示されます。
同時実行数の上限をスケールテストする
スケールテストは、クライアント側のスケーリングに関する問題の特定や、ユースケースに対して同時実行数の上限が正しく設定されているかの確認に役立ちます。
実際の利用状況にできるだけ近いエンドツーエンドのワークフローをテストすることを強くおすすめします。この目的を達成するには、サポート可能なユーザー数をシミュレーションして測定する方法が推奨されます。次の点が重要です。
- 生のリクエストではなく、ユーザーをシミュレートする
- リクエストを行う前に、オーディオ再生、ユーザーの発話、文字起こしの完了を待つなど、一般的なユーザー行動をシミュレートする
- 数分かけてユーザー数を徐々に増やす
- リクエストのタイミングやリクエストサイズにランダム性を加える
- レイテンシー指標と、APIから返されたエラーコードを記録する
たとえば、100件の同時会話をサポートするよう設計されたエージェントシステムをテストするには、会話をシミュレートする個別の「ユーザー」を最大100人作成します。会話は通常、約10秒間のユーザーの発話、約150文字に対するTTS API呼び出し、約10秒間のユーザーへのオーディオ再生という繰り返しサイクルで構成されます。そのため、各ユーザーは20秒ごとに150文字のテキストに対するWebSocketテキスト読み上げAPI呼び出しを行うパターンに従い、待機時間とリクエストする文字数には少量のランダム性を加える必要があります。テストでは、100人に達するまで1秒ごとに1ユーザーを追加し、その後、全体の安定性をテストするために合計10分間テストします。
スケールテストスクリプトの例
この例では、テストフレームワークとしてlocustを使用し、ElevenLabs APIを直接呼び出します。
上記の例に従い、各ユーザーが20秒ごとに1リクエストを送信する会話型エージェントシステムをテストします。