

मॉडल
प्रमुख मॉडल
टेक्स्ट टू स्पीच
स्पीच टू टेक्स्ट
वॉइस एजेंट
संगीत
मॉडल का अवलोकन
ElevenLabs API अलग-अलग उपयोग मामलों, क्वालिटी स्तरों और प्रदर्शन आवश्यकताओं के लिए ऑप्टिमाइज़ किए गए कई ऑडियो मॉडल देता है।
† एप्लिकेशन और नेटवर्क लेटेंसी शामिल नहीं है। लेटेंसी को समझना देखें।
अप्रचलित मॉडल
eleven_turbo_v2_5 और eleven_turbo_v2 मॉडल क्रमशः
eleven_flash_v2_5 और eleven_flash_v2 मॉडल के कार्यात्मक रूप से समकक्ष हैं, सिवाय इसके कि Flash
मॉडल की औसत लेटेंसी कम होती है। हम सभी उपयोग
मामलों में Turbo मॉडल के बजाय Flash मॉडल का उपयोग करने की सलाह देते हैं।
Eleven v4
Eleven v4 हमारा अत्याधुनिक स्पीच सिंथेसिस मॉडल है, जो बेहतरीन ऑडियो क्वालिटी, अभिव्यक्ति और वॉइस डिलीवरी पर नियंत्रण देता है। Eleven v4 लंबी टेक्स्ट जनरेशन में स्पीकर की विश्वसनीय पहचान बनाए रखते हुए हाई-फिडेलिटी वॉइस क्लोनिंग को सपोर्ट करता है।
यह मॉडल इन स्थितियों में अच्छा काम करता है:
- किरदारों के वॉइसओवर: अपनी भावनात्मक रेंज के कारण गेमिंग और एनीमेशन के लिए आदर्श।
- भावनात्मक संवाद: उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बनाएं।
- ऑडियोबुक प्रोडक्शन: जटिल भावनात्मक डिलीवरी वाले लंबे नैरेशन के लिए बेहतरीन।
- बहुभाषी प्रोजेक्ट्स: भाषा बदलने पर भी वॉइस क्वालिटी एक जैसी रखता है।
Eleven v4 टेक्स्ट टू डायलॉग API के ज़रिए उपलब्ध है।
समर्थित भाषाएं
Eleven v4 मॉडल परिवार 90+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), कोरियाई (ko), किर्गिज़ (ky), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Eleven v4 Turbo
Eleven v4 Turbo रीयल-टाइम स्पीच सिंथेसिस के लिए हमारा अत्याधुनिक मॉडल है, जो उच्च क्वालिटी का ऑडियो, अभिव्यक्ति और वॉइस डिलीवरी पर नियंत्रण देता है। Eleven v4 Turbo हाई-फिडेलिटी वॉइस क्लोनिंग को सपोर्ट करता है और ~100ms की औसत इन्फरेंस लेटेंसी में नतीजे देता है।
यह मॉडल इन स्थितियों में अच्छा काम करता है:
- सपोर्ट एजेंट्स: ऐसे वॉइस एजेंट्स को पावर दें जो रीयल-टाइम में ग्राहकों के सवाल हल करें।
- AI असिस्टेंट्स: उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बनाएं।
- इंटरैक्टिव किरदार: भावपूर्ण किरदारों वाले ऑडियो अनुभवों के लिए बेहतरीन।
Eleven v4 Turbo टेक्स्ट टू डायलॉग websocket के ज़रिए उपलब्ध है।
समर्थित भाषाएं
Eleven v4 मॉडल परिवार 90+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), कोरियाई (ko), किर्गिज़ (ky), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Eleven v3
Eleven v3 हमारा पिछली पीढ़ी का स्पीच सिंथेसिस मॉडल है, जो कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत स्पीच बनाता है।
Eleven v3 के साथ एक नया टेक्स्ट टू डायलॉग API आता है, जिससे आप कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं। Eleven v3 का इस्तेमाल टेक्स्ट टू स्पीच API के साथ भी किया जा सकता है, ताकि कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत स्पीच बनाई जा सके।
टेक्स्ट टू डायलॉग API के बारे में और यहां पढ़ें।
समर्थित भाषाएं
Eleven v3 मॉडल 70+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), चिचेवा (ny), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), किर्गिज़ (ky), कोरियाई (ko), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Eleven v3 Conversational
Eleven v3 Conversational रीयल-टाइम स्पीच सिंथेसिस के लिए हमारा पिछली पीढ़ी का मॉडल है। यह कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत स्पीच बनाता है।
Eleven v3 Conversational के साथ एक नया टेक्स्ट टू डायलॉग WebSocket आता है, जिससे आप कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं।
Eleven v3 Conversational के साथ एक नया टेक्स्ट टू डायलॉग WebSocket आता है, जिससे आप कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं।
टेक्स्ट टू डायलॉग WebSocket के बारे में और यहां पढ़ें।
समर्थित भाषाएं
Eleven v3 मॉडल 70+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), चिचेवा (ny), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), किर्गिज़ (ky), कोरियाई (ko), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Multilingual v2
Eleven Multilingual v2 पिछली पीढ़ी का भावनाओं को समझने वाला स्पीच सिंथेसिस मॉडल है। यह कई भाषाओं में उच्च भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत स्पीच बनाता है।
यह मॉडल सभी समर्थित भाषाओं में स्पीकर की खास विशेषताएं और एक्सेंट बनाए रखते हुए एक जैसी वॉइस क्वालिटी और व्यक्तित्व देता है।
यह मॉडल उच्च-क्वालिटी, भावनात्मक रूप से सूक्ष्म स्पीच की ज़रूरत वाली स्थितियों में बेहतरीन है:
- किरदारों के वॉइसओवर: अपनी भावनात्मक रेंज के कारण गेमिंग और एनीमेशन के लिए आदर्श।
- प्रोफेशनल कंटेंट: कॉर्पोरेट वीडियो और ई-लर्निंग सामग्री के लिए उपयुक्त।
- बहुभाषी प्रोजेक्ट्स: भाषा बदलने पर भी वॉइस क्वालिटी एक जैसी रखता है।
- स्थिर क्वालिटी: लगातार एक जैसा, उच्च-क्वालिटी ऑडियो आउटपुट देता है।
हालांकि इसकी प्रति कैरेक्टर लेटेंसी और लागत Flash मॉडल्स से अधिक है, लेकिन जिन प्रोजेक्ट्स में जीवंत स्पीच अहम है उनके लिए यह बेहतर क्वालिटी देता है।
हमारे multilingual v2 मॉडल्स 29 भाषाओं को support करते हैं:
अंग्रेज़ी (USA, UK, ऑस्ट्रेलिया, कनाडा), जापानी, चीनी, जर्मन, हिंदी, फ़्रेंच (फ़्रांस, कनाडा), कोरियाई, पुर्तगाली (ब्राज़ील, पुर्तगाल), इतालवी, स्पेनिश (स्पेन, मेक्सिको), इंडोनेशियाई, डच, तुर्की, फ़िलिपीनो, पोलिश, स्वीडिश, बल्गेरियाई, रोमानियाई, अरबी (सऊदी अरब, UAE), चेक, यूनानी, फ़िनिश, क्रोएशियाई, मलय, स्लोवाक, डेनिश, तमिल, यूक्रेनी और रूसी।
Flash v2.5
Eleven Flash v2.5 हमारा सबसे तेज़ स्पीच सिंथेसिस मॉडल है, जिसे रीयल-टाइम ऐप्लिकेशन और Agents Platform के लिए डिज़ाइन किया गया है। यह 32 भाषाओं में बेहद कम लेटेंसी (~75ms†) के साथ उच्च-क्वालिटी स्पीच देता है।
यह मॉडल स्पीड और क्वालिटी का संतुलन बनाता है, इसलिए इंटरैक्टिव ऐप्लिकेशन के लिए आदर्श है। साथ ही, यह स्वाभाविक लगने वाला आउटपुट और भाषाओं के बीच वॉइस की एक जैसी विशेषताएं बनाए रखता है।
यह मॉडल खास तौर पर इनके लिए उपयुक्त है:
- Agents Platform: रीयल-टाइम वॉइस एजेंट्स और चैटबॉट्स के लिए बेहतरीन।
- इंटरैक्टिव ऐप्लिकेशन: गेम्स और तुरंत प्रतिक्रिया वाले ऐप्लिकेशन के लिए आदर्श।
- बड़े स्तर की प्रोसेसिंग: बड़ी मात्रा में टेक्स्ट-टू-स्पीच कन्वर्ज़न के लिए कुशल।
API जनरेशन के लिए कम कीमत और 75ms लेटेंसी के साथ, Flash v2.5 कई भाषाओं में तेज़ और भरोसेमंद स्पीच सिंथेसिस चाहने वाले हर व्यक्ति के लिए किफायती विकल्प है।
Flash v2.5, v2 मॉडल्स की सभी भाषाओं के साथ-साथ 32 भाषाओं को support करता है:
हंगेरियन, नॉर्वेजियन और वियतनामी
† ऐप्लिकेशन और नेटवर्क लेटेंसी शामिल नहीं है। लेटेंसी को समझें ।
ध्यान देने योग्य बातें
संख्याओं के साथ टेक्स्ट नॉर्मलाइज़ेशन
Flash v2.5 का इस्तेमाल करते समय, संख्याएं डिफ़ॉल्ट रूप से उस तरह नॉर्मलाइज़ नहीं होतीं जैसी आप उम्मीद कर सकते हैं। उदाहरण के लिए, फोन नंबर ऐसे पढ़े जा सकते हैं जो यूज़र को स्पष्ट न लगें। तारीखें और मुद्राएं भी इसी तरह प्रभावित होती हैं।
कम लेटेंसी बनाए रखने के लिए Flash v2.5 में डिफ़ॉल्ट रूप से नॉर्मलाइज़ेशन बंद है। हालांकि, Enterprise ग्राहक अब अपने अनुरोध में apply_text_normalization पैरामीटर को “on” सेट करके v2.5 मॉडल्स के लिए टेक्स्ट नॉर्मलाइज़ेशन चालू कर सकते हैं।
Multilingual v2 मॉडल संख्याओं को नॉर्मलाइज़ करने में बेहतर है, इसलिए हम फोन नंबर और ऐसे अन्य मामलों के लिए इसका इस्तेमाल करने की सलाह देते हैं जहां संख्या नॉर्मलाइज़ेशन जरूरी हो।
कम-लेटेंसी या Agents Platform ऐप्लिकेशन के लिए, सबसे अच्छा तरीका है कि TTS मॉडल को टेक्स्ट भेजने से पहले आपका LLM टेक्स्ट को नॉर्मलाइज़ करे, या apply_text_normalization पैरामीटर का इस्तेमाल करें (v2.5 मॉडल्स के लिए केवल Enterprise प्लान)।
मॉडल चुनने की गाइड
आपकी ज़रूरतों और उपयोग के मामले के लिए कौन-सा मॉडल सबसे उपयुक्त है, इसकी जानकारी के लिए मॉडल चुनने की गाइड देखें।
ज़रूरतें
उपयोग का मामला
कैरेक्टर सीमाएं
एक टेक्स्ट-टू-स्पीच अनुरोध में समर्थित कैरेक्टर्स की अधिकतम संख्या मॉडल के अनुसार अलग होती है।
Scribe v2
Scribe v2 हमारा अत्याधुनिक स्पीच रिकग्निशन मॉडल है, जिसे 90+ भाषाओं में सटीक ट्रांसक्रिप्शन के लिए डिज़ाइन किया गया है। यह शब्द-स्तर के सटीक टाइमस्टैम्प और स्पीकर डायराइज़ेशन व डायनामिक ऑडियो टैगिंग जैसी उन्नत सुविधाएं देता है।
यह मॉडल सटीक स्पीच-टू-टेक्स्ट कन्वर्ज़न की ज़रूरत वाली स्थितियों में बेहतरीन है:
- ट्रांसक्रिप्शन सेवाएं: ऑडियो/वीडियो कंटेंट को टेक्स्ट में बदलने के लिए बेहतरीन
- मीटिंग डॉक्यूमेंटेशन: बातचीत को रिकॉर्ड और दस्तावेज़ करने के लिए आदर्श
- कंटेंट विश्लेषण: ऑडियो कंटेंट की प्रोसेसिंग और विश्लेषण के लिए उपयुक्त
- बहुभाषी रिकग्निशन: 90+ भाषाओं में सटीक ट्रांसक्रिप्शन को सपोर्ट करता है
मुख्य सुविधाएं:
- शब्द-स्तर के टाइमस्टैम्प के साथ सटीक ट्रांसक्रिप्शन
- कई स्पीकर्स वाले ऑडियो के लिए स्पीकर डायराइज़ेशन
- बेहतर संदर्भ के लिए डायनामिक ऑडियो टैगिंग
- 90+ भाषाओं के लिए सपोर्ट
- एंटिटी डिटेक्शन
- कीटर्म प्रॉम्प्टिंग
- ट्रांसक्रिप्ट एडिटिंग
Scribe v2 के बारे में और यहां पढ़ें।
Scribe v2 Realtime
Scribe v2 Realtime, हमारा सबसे तेज़ और सटीक लाइव स्पीच रिकग्निशन मॉडल, बेहद कम 150ms लेटेंसी के साथ 90 से अधिक भाषाओं में अत्याधुनिक सटीकता देता है।
यह मॉडल संवादात्मक उपयोग के मामलों में बेहतरीन है:
- लाइव मीटिंग ट्रांसक्रिप्शन: रीयल-टाइम ट्रांसक्रिप्शन के लिए बेहतरीन
- AI एजेंट्स: लाइव बातचीत के लिए आदर्श
- बहुभाषी रिकग्निशन: ऑटोमैटिक भाषा पहचान के साथ 90+ भाषाओं में सटीक ट्रांसक्रिप्शन को सपोर्ट करता है
मुख्य सुविधाएं:
- बेहद कम लेटेंसी: ~150 मिलीसेकंड में आंशिक ट्रांसक्रिप्शन पाएं
- स्ट्रीमिंग सपोर्ट: रीयल-टाइम में ट्रांसक्रिप्ट पाते हुए ऑडियो को हिस्सों में भेजें
- कई ऑडियो फॉर्मैट: PCM (8kHz से 48kHz) और μ-law एन्कोडिंग के लिए सपोर्ट
- वॉइस एक्टिविटी डिटेक्शन (VAD): साइलेंस डिटेक्शन के आधार पर ऑटोमैटिक स्पीच सेगमेंटेशन
- मैन्युअल कमिट कंट्रोल: ट्रांसक्रिप्ट सेगमेंट्स को कब अंतिम रूप देना है, इस पर पूरा नियंत्रण
- एंटिटी डिटेक्शन
- ट्रांसक्रिप्ट एडिटिंग
Scribe v2 Realtime के बारे में और यहां पढ़ें।
Scribe v2 Medical
Scribe v2 Medical मेडिकल और क्लिनिकल ऑडियो के लिए विशेषीकृत बैच स्पीच रिकग्निशन मॉडल है। यह Scribe v2 का एक फाइनट्यून है, जो रोज़मर्रा की स्पीच पर Scribe v2 की सटीकता बरकरार रखते हुए दवाओं के नाम, एनाटॉमी, पैथोलॉजी और क्लिनिकल डिक्टेशन की पहचान बेहतर बनाता है। यह Scribe v2 के समान स्पीच टू टेक्स्ट API का उपयोग करता है और इसकी बिलिंग भी उसी दर पर होती है। model_id के रूप में scribe_v2_medical पास करें।
इच्छित उद्देश्य
Scribe v2 Medical डेवलपर्स और संगठनों के लिए एक बैच स्पीच-टू-टेक्स्ट API मॉडल है, जिसे ऐसे ऐप्लिकेशन में इंटीग्रेट किया जा सकता है जो क्लिनिकल ऑडियो, जैसे चिकित्सक-रोगी बातचीत, डिक्टेशन, इंटेक और केयर-कोऑर्डिनेशन कॉल्स को दस्तावेज़ीकरण और संबंधित प्रशासनिक वर्कफ़्लो के लिए ड्राफ़्ट ट्रांसक्रिप्ट में बदलते हैं। तैयार टेक्स्ट का उपयोग करने से पहले किसी हेल्थकेयर प्रोफेशनल या अन्य अधिकृत यूज़र द्वारा उसकी समीक्षा और सुधार किया जाना चाहिए। Scribe v2 Medical का उद्देश्य क्लिनिकल जानकारी की व्याख्या करना या निदान, उपचार सुझाव, क्लिनिकल निर्णय या अन्य क्लिनिकल मार्गदर्शन देना नहीं है।
यह मॉडल इनके लिए उपयुक्त है:
- क्लिनिकल डॉक्यूमेंटेशन: परिवेशीय मुलाकातें और नोट्स, जिनमें बातचीत के बीच मेडिकल शब्द आते हैं
- डिक्टेशन: दवाओं, खुराकों और निष्कर्षों के घने क्रम
- इंटेक और कोऑर्डिनेशन कॉल्स: मरीज़ अपनी स्थितियां बताते हैं, अक्सर फोन पर
- कंप्लायंस वर्कफ़्लो: PHI श्रेणियों के लिए एंटिटी डिटेक्शन के साथ जोड़ें
मुख्य सुविधाएं:
- Scribe v2 जैसा ही अनुरोध स्वरूप (
keyterms,entity_detection,no_verbatim, डायराइज़ेशन, टाइमस्टैम्प) - दवाओं के नाम, एनाटॉमी और पैथोलॉजी शब्दों की बेहतर पहचान
- Scribe v2 की तुलना में रोज़मर्रा की स्पीच पर कोई गिरावट नहीं
- 90+ भाषाओं के लिए सपोर्ट
- कई स्पीकर्स वाले ऑडियो के लिए स्पीकर डायराइज़ेशन
- डायनामिक ऑडियो टैगिंग
- PHI श्रेणियों सहित एंटिटी डिटेक्शन
Scribe v2 Medical एक बैच मॉडल है। लाइव ट्रांसक्रिप्शन के लिए Scribe v2 Realtime का इस्तेमाल करें।
Scribe v2 Medical HIPAA के लिए योग्य है। Enterprise ग्राहकों के लिए Business Associate Agreements और Zero Retention Mode (ZRM) उपलब्ध हैं। ZRM चालू होने पर, हर अनुरोध पूरा होते ही ऑडियो इनपुट और टेक्स्ट आउटपुट तुरंत हटा दिए जाते हैं। ElevenLabs कुछ भी स्टोर नहीं करता और आपके ऐप्लिकेशन को पूरा API रिस्पॉन्स मिलता है तथा वह अपने नियंत्रण में ट्रांसक्रिप्ट रखता है।
HIPAA अनुपालन की ज़रूरत वाली कंपनियों को संरक्षित स्वास्थ्य जानकारी भेजने से पहले Business Associate Agreement (BAA) पर हस्ताक्षर करने के लिए ElevenLabs Sales से संपर्क करना होगा।
स्पीच टू टेक्स्ट के बारे में और यहां पढ़ें।
Eleven Realtime
Eleven Realtime स्वाभाविक वॉइस एजेंट्स बनाने के लिए स्पीच टू स्पीच मॉडल्स की एक नई श्रेणी है। हर Realtime मॉडल एक संपूर्ण वॉइस एजेंट है: स्पीच रिकग्निशन, वॉइस एक्टिविटी डिटेक्शन और टर्न-टेकिंग, LLM, और टेक्स्ट टू स्पीच—इन सभी को ElevenLabs एक सिस्टम के रूप में साथ काम करने के लिए चुनता और ट्यून करता है। Realtime मॉडल चुनें और एक ही विकल्प से अच्छा प्रदर्शन करने वाला एजेंट पाएं, जिसमें कॉन्फ़िगर करने के लिए कोई कंपोनेंट नहीं है।
दो Realtime मॉडल उपलब्ध हैं।
Eleven Realtime v1 Mini तेज़, स्वाभाविक बातचीत के लिए ऑप्टिमाइज़्ड है और इन स्थितियों में अच्छा काम करता है:
- AI असिस्टेंट्स: तेज़, भावपूर्ण संवाद, जहां बातचीत ही प्रोडक्ट है।
- शैक्षिक ट्यूटर्स: स्वाभाविक संवाद जो सीखने वाले की गति के साथ चलता है।
- इंटरैक्टिव किरदार: गेम्स और मनोरंजन के लिए भावपूर्ण किरदार।
Eleven Realtime v1 Max जटिल कार्यों के लिए ऑप्टिमाइज़्ड है और इन स्थितियों में अच्छा काम करता है:
- कस्टमर सपोर्ट: ऐसी क्वेरीज़ हल करना जिनमें प्रक्रिया का पालन और जानकारी ढूंढने की ज़रूरत हो।
- लीड क्वालिफिकेशन: जानकारी इकट्ठा करने और अगले कदम तय करने वाली संरचित बातचीत।
- मल्टी-स्टेप वर्कफ़्लो: ऐसे कार्य जो जानकारी ढूंढने या कार्रवाई करने के लिए टूल्स को कॉल करते हैं।
मुख्य सुविधाएं:
- एक मॉडल विकल्प में स्पीच रिकग्निशन, टर्न-टेकिंग, लैंग्वेज मॉडल और वॉइस
- स्वाभाविक टर्न-टेकिंग और इंटरप्शन हैंडलिंग
- टूल कॉलिंग
- ElevenLabs वॉइस लाइब्रेरी से कस्टमाइज़ की जा सकने वाली वॉइसेस
- 90+ भाषाओं के लिए सपोर्ट
- इंटीग्रेशन बदले बिना मॉडल चयन से v1 Mini और v1 Max के बीच स्विच करें
Eleven Realtime, ElevenAgents में उपलब्ध है, जहां आप मॉडल ड्रॉपडाउन से Realtime मॉडल चुनते हैं। यह Realtime API के ज़रिए भी उपलब्ध है, जिसे WebSocket पर OpenAI के Realtime API के साथ संगत रखने के लिए डिज़ाइन किया गया है। अगर आप पहले से OpenAI का Realtime API इस्तेमाल कर रहे हैं, तो माइग्रेशन गाइड देखें।
समर्थित भाषाएं
Realtime मॉडल 90+ भाषाओं को सपोर्ट करते हैं। Eleven v4 भाषा सूची देखें।
Eleven Realtime के बारे में और यहां पढ़ें।
Eleven Music
Eleven Music हमारा स्टूडियो-ग्रेड म्यूज़िक जनरेशन मॉडल है। यह आपको किसी भी स्टाइल में नेचुरल लैंग्वेज प्रॉम्प्ट्स के साथ संगीत बनाने देता है।
यह मॉडल इन स्थितियों के लिए बेहतरीन है:
- गेम साउंडट्रैक्स: गेम्स के लिए इमर्सिव साउंडट्रैक्स बनाएं
- पॉडकास्ट बैकग्राउंड्स: प्रोफेशनल संगीत के साथ पॉडकास्ट को बेहतर बनाएं
- मार्केटिंग: ऐड रील्स में बैकग्राउंड म्यूज़िक जोड़ें
मुख्य सुविधाएं:
- जॉनर, स्टाइल और स्ट्रक्चर पर पूरा नियंत्रण
- वोकल्स या केवल इंस्ट्रूमेंटल
- अंग्रेज़ी, स्पैनिश, जर्मन, जापानी और अन्य भाषाओं सहित बहुभाषी
- अलग-अलग सेक्शन्स या पूरे गाने की ध्वनि और लिरिक्स एडिट करें
Eleven Music के बारे में और यहां पढ़ें।
समवर्ती अनुरोध और प्राथमिकता
आपका सब्सक्रिप्शन प्लान तय करता है कि एक साथ कितने अनुरोध प्रोसेस किए जा सकते हैं और क्यू में आपके अनुरोधों का प्राथमिकता स्तर क्या होगा। स्पीच टू टेक्स्ट की समवर्ती अनुरोध सीमा अधिक होती है। समवर्ती अनुरोध सीमा पूरी होने के बाद, अगले अनुरोध कम-प्राथमिकता वाले अनुरोधों के साथ क्यू में प्रोसेस किए जाते हैं। व्यवहार में, इससे आमतौर पर केवल ~50ms की लेटेंसी बढ़ती है।
रिस्पॉन्स हेडर में current-concurrent-requests और maximum-concurrent-requests शामिल होते हैं, जिनका उपयोग करके आप अपने समवर्ती अनुरोधों की निगरानी कर सकते हैं।
प्रति मिनट API अनुरोध बनाम समवर्ती अनुरोध
यह समझना ज़रूरी है कि प्रति मिनट API अनुरोध और समवर्ती अनुरोध अलग-अलग मेट्रिक हैं, जो आपके उपयोग के पैटर्न पर निर्भर करते हैं।
प्रति मिनट API अनुरोध, समवर्ती अनुरोधों से अलग हो सकते हैं, क्योंकि यह हर अनुरोध में लगने वाले समय और अनुरोधों को बैच करने के तरीके पर निर्भर करता है।
उदाहरण 1: अंतराल वाले अनुरोध अगर आपके पास प्रति मिनट 180 अनुरोध हों, जिनमें से हर एक को पूरा होने में 1 सेकंड लगता हो और आप हर अनुरोध को 0.33 सेकंड के अंतराल पर भेजें, तो अधिकतम समवर्ती अनुरोध 3 होंगे और औसत भी 3 होगा, क्योंकि हमेशा 3 अनुरोध प्रोसेस में होंगे।
उदाहरण 2: बैच किए गए अनुरोध हालाँकि, अगर आपका उपयोग पैटर्न अलग हो, जैसे प्रति मिनट 180 अनुरोध हों, जिनमें से हर एक को पूरा होने में 3 सेकंड लगते हों लेकिन वे सभी एक साथ भेजे जाएँ, तो अधिकतम समवर्ती अनुरोध 180 होंगे और औसत 9 होगा (मिनट के पहले 3 सेकंड में एक साथ 180 अनुरोध थे, जबकि अंतिम 57 सेकंड में 0 अनुरोध थे)।
क्योंकि हमारा सिस्टम समवर्ती अनुरोधों को ध्यान में रखता है, इसलिए प्रति मिनट अनुरोधों की संख्या से ज़्यादा मायने यह रखता है कि हर अनुरोध को पूरा होने में कितना समय लगता है और उन्हें किस पैटर्न में भेजा जाता है।
एंडपॉइंट अनुरोध करने का तरीका समवर्ती अनुरोध सीमाओं को प्रभावित करता है:
- HTTP के साथ, हर अनुरोध आपकी समवर्ती अनुरोध सीमा में अलग-अलग गिना जाता है।
- टेक्स्ट टू स्पीच WebSocket के साथ, केवल वह समय आपकी समवर्ती अनुरोध सीमा में गिना जाता है जब हमारा मॉडल ऑडियो जनरेट कर रहा होता है। इसका मतलब है कि अधिकतर समय खुला हुआ websocket आपकी समवर्ती अनुरोध सीमा में बिल्कुल नहीं गिना जाता।
- टेक्स्ट टू डायलॉग WebSockets अलग तरह से काम करते हैं: हर खुला कनेक्शन, खुले रहने तक, एक अलग पूल से एक डायलॉग सेशन आरक्षित रखता है और कनेक्शन के ज़रिए जनरेट किया गया ऑडियो आपकी मानक समवर्ती अनुरोध सीमा में नहीं गिना जाता। इसे समझना आसान बनाने के लिए डिज़ाइन किया गया है: एक कनेक्शन एक सेशन है, और आपकी डायलॉग सेशन सीमाएँ इस नई समवर्ती अनुरोध पद्धति के अनुसार तय की जाती हैं। देखें टेक्स्ट टू डायलॉग समवर्ती अनुरोध।
समवर्ती अनुरोध सीमाओं को समझना
आपके प्लान से जुड़ी समवर्ती अनुरोध सीमा को एक साथ संभाली जा सकने वाली बातचीत, फ़ोन कॉल, कैरेक्टर वॉइसओवर आदि की अधिकतम संख्या नहीं समझना चाहिए। वास्तविक संख्या कई कारकों पर निर्भर करती है, जिनमें इस्तेमाल की गई खास AI वॉइस और उपयोग के मामले की विशेषताएँ शामिल हैं।
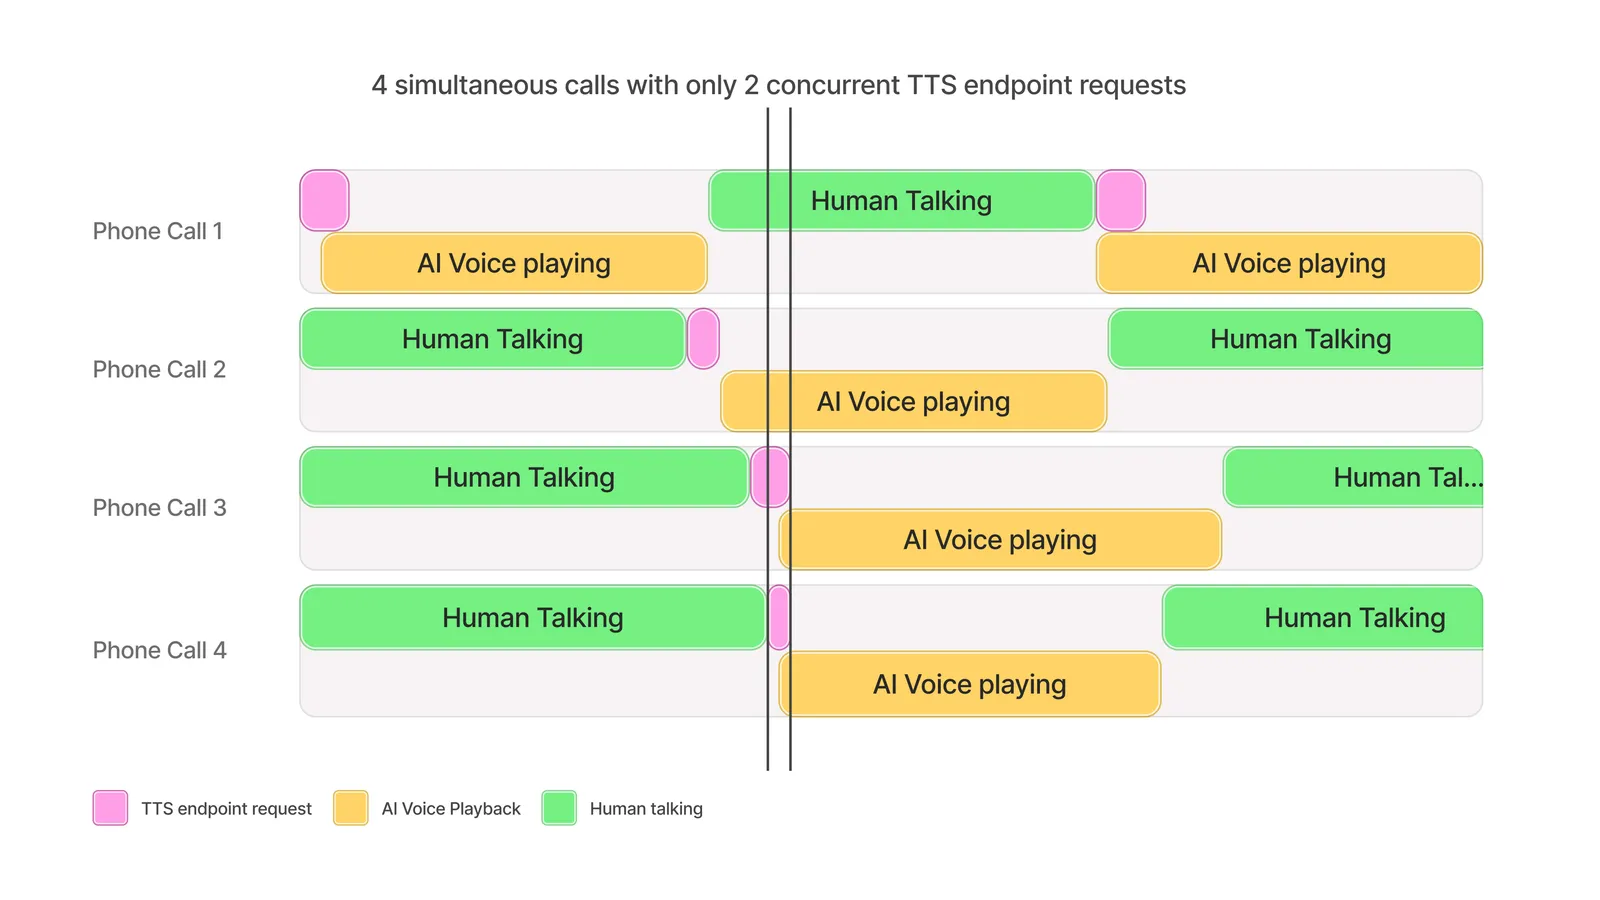
सामान्य तौर पर, 5 की समवर्ती अनुरोध सीमा आमतौर पर लगभग 100 एक-साथ ऑडियो ब्रॉडकास्ट को सपोर्ट कर सकती है।
ऐसा इसलिए है क्योंकि ऑडियो जनरेट होने की गति, TTS अनुरोध को प्रोसेस होने में लगने वाले समय की तुलना में तेज़ होती है। नीचे दिया गया डायग्राम दिखाता है कि अलग-अलग यूज़र्स के साथ 4 समवर्ती कॉल कैसे केवल 2 समवर्ती अनुरोधों तक पहुँचते हुए संभाली जा सकती हैं।
AI वॉइस एजेंट बनाना
जहाँ TTS का इस्तेमाल डायलॉग के लिए किया जाता है, वहाँ 5 की समवर्ती अनुरोध सीमा AI एजेंट और मानव प्रतिभागियों के बीच संतुलित बातचीत के लिए लगभग 100 ब्रॉडकास्ट को सपोर्ट कर सकती है।
ऐसे उपयोग के मामलों में, जहाँ AI एजेंट मानव की तुलना में कम बोलता है, जैसे कस्टमर सपोर्ट इंटरैक्शन, 100 से ज़्यादा एक-साथ बातचीत को सपोर्ट किया जा सकता है।
कैरेक्टर वॉइसओवर
आम तौर पर, 5 की समवर्ती अनुरोध सीमा के साथ 100 से ज़्यादा एक-साथ कैरेक्टर वॉइसओवर को सपोर्ट किया जा सकता है।
संख्या कैरेक्टर के डायलॉग की आवृत्ति, विराम की अवधि और लाइनों के बीच इन-गेम ऐक्शन के आधार पर अलग हो सकती है।
लाइव डबिंग
समवर्ती डबिंग स्ट्रीम आम तौर पर दिए गए अनुमान का पालन करती हैं।
अगर ब्रॉडकास्ट में बातचीत के विराम होते हैं (जैसे साउंडट्रैक, विज़ुअल सीन आदि के कारण), तो सुझाई गई संख्या से ज़्यादा एक-साथ डबिंग स्ट्रीम संभव हो सकती हैं।
अगर आप किसी भी समय अपने प्लान की समवर्ती अनुरोध सीमाओं से आगे बढ़ जाते हैं और आप Enterprise प्लान पर हैं, तो उपलब्ध क्षमता के आधार पर मॉडल अनुरोध best efforts के आधार पर धीमे होने पर भी सफल हो सकते हैं।
अपनी समवर्ती अनुरोध सीमा और क्यू प्राथमिकता बढ़ाने के लिए, अपना सब्सक्रिप्शन प्लान अपग्रेड करें।
Enterprise ग्राहक अपने अकाउंट मैनेजर से संपर्क करके अधिक समवर्ती अनुरोध सीमा का अनुरोध कर सकते हैं।
टेक्स्ट टू डायलॉग समवर्ती अनुरोध
टेक्स्ट टू डायलॉग अनुरोधों की मीटरिंग API को कॉल करने के तरीके के आधार पर दो अलग तरीकों से होती है:
- HTTP एंडपॉइंट (डायलॉग बनाएं और डायलॉग स्ट्रीम करें) ऑडियो जनरेट होते समय आपके प्लान की मानक समवर्ती अनुरोध सीमा में गिने जाते हैं, ठीक किसी अन्य टेक्स्ट टू स्पीच अनुरोध की तरह।
- WebSocket एंडपॉइंट, जैसे टेक्स्ट टू डायलॉग WebSocket, की मीटरिंग डायलॉग सेशन के रूप में होती है। कनेक्शन खुला रहने तक वह एक डायलॉग सेशन रखता है, चाहे उस समय ऑडियो जनरेट हो रहा हो या नहीं।
सेशन-आधारित मीटरिंग क्षमता की योजना को आसान बनाती है: एक कनेक्शन एक सेशन है, इसलिए आपका उपयोग जनरेशन गतिविधि के साथ बदलता नहीं है। चूँकि सेशन केवल ऑडियो जनरेट होने के दौरान नहीं, बल्कि पूरे कनेक्शन के लिए रखा जाता है, इसलिए आपकी डायलॉग सेशन सीमाएँ इस नई समवर्ती अनुरोध पद्धति के अनुसार तय की जाती हैं।
अगर आप तब कनेक्शन खोलते हैं, जब आपके वर्कस्पेस के सभी डायलॉग सेशन उपयोग में हों, तो नए कनेक्शन को too_many_concurrent_requests त्रुटि के साथ अस्वीकार कर दिया जाता है। सेशन खाली करने के लिए जिन कनेक्शन की अब ज़रूरत नहीं है उन्हें बंद करें — यदि आप keep_alive मैसेज नहीं भेजते हैं, तो निष्क्रियता के 20 सेकंड बाद कनेक्शन अपने-आप भी बंद हो जाता है।
डायलॉग सेशन की निगरानी के लिए, डैशबोर्ड साइडबार के नीचे डेवलपर्स खोलें, एनालिटिक्स टैब चुनें और Usage व्यू में समवर्ती अनुरोध मेट्रिक देखें। डायलॉग सेशन आपके अन्य समवर्ती अनुरोधों से अलग, अपनी अलग सीरीज़ TTD Websocket Sessions के रूप में रिपोर्ट होते हैं।
समवर्ती अनुरोध सीमाओं की स्केल टेस्टिंग
स्केल टेस्टिंग, क्लाइंट-साइड स्केलिंग समस्याओं की पहचान करने और यह सत्यापित करने के लिए उपयोगी हो सकती है कि आपके उपयोग के मामले के लिए समवर्ती अनुरोध सीमाएँ सही तरीके से तय की गई हैं।
असल उपयोग के जितना संभव हो उतना करीब एंड-टू-एंड वर्कफ़्लो टेस्ट करने की पुरज़ोर सलाह दी जाती है। इसे हासिल करने के लिए, कितने यूज़र्स को सपोर्ट किया जा सकता है इसका सिमुलेशन और मापन करना सुझाया गया तरीका है। यह ज़रूरी है कि आप:
- रॉ अनुरोधों का नहीं, यूज़र्स का सिमुलेशन करें
- सामान्य यूज़र व्यवहार का सिमुलेशन करें, जैसे अनुरोध करने से पहले ऑडियो प्लेबैक, यूज़र के बोलने या ट्रांसक्रिप्शन पूरा होने का इंतज़ार करना
- कुछ मिनटों की अवधि में यूज़र्स की संख्या धीरे-धीरे बढ़ाएँ
- अनुरोधों के समय और आकार में रैंडमनेस जोड़ें
- API से लौटे लेटेंसी मेट्रिक और किसी भी त्रुटि कोड को कैप्चर करें
उदाहरण के लिए, 100 एक-साथ बातचीत को सपोर्ट करने के लिए डिज़ाइन किए गए एजेंट सिस्टम का टेस्ट करने के लिए, आप अधिकतम 100 अलग-अलग “यूज़र्स” बनाएँगे, जिनमें से हर एक बातचीत का सिमुलेशन करेगा। बातचीत में आमतौर पर यूज़र के लगभग 10 सेकंड बोलने का दोहराव वाला चक्र होता है, उसके बाद ~150 कैरेक्टर के लिए TTS API कॉल होती है, फिर यूज़र को लगभग 10 सेकंड का ऑडियो प्लेबैक होता है। इसलिए, हर यूज़र को हर 20 सेकंड में 150 कैरेक्टर के टेक्स्ट के लिए एक websocket टेक्स्ट-टू-स्पीच API कॉल करने के पैटर्न का पालन करना चाहिए, जिसमें इंतज़ार की अवधि और अनुरोधित कैरेक्टर की संख्या में थोड़ा रैंडमनेस जोड़ा जाए। टेस्ट में हर सेकंड एक यूज़र शुरू करना शामिल होगा, जब तक कि 100 यूज़र मौजूद न हो जाएँ, और फिर कुल स्थिरता जाँचने के लिए 10 मिनट तक टेस्ट करना होगा।
स्केल टेस्टिंग स्क्रिप्ट उदाहरण
यह उदाहरण ElevenLabs API को सीधे API कॉल के साथ टेस्टिंग फ़्रेमवर्क के रूप में locust का उपयोग करता है।
यह ऊपर दिए गए उदाहरण का पालन करता है और एक संवादात्मक एजेंट सिस्टम का टेस्ट करता है, जिसमें हर यूज़र हर 20 सेकंड में 1 अनुरोध भेजता है।