

Modelos
Modelos principais
Text to Speech
Speech to Text
Agentes de voz
Música
Visão geral dos modelos
A API da ElevenLabs oferece uma variedade de modelos de áudio otimizados para diferentes casos de uso, níveis de qualidade e requisitos de desempenho.
† Exclui a latência da aplicação e da rede. Consulte Entendendo a latência.
Modelos descontinuados
Os modelos eleven_turbo_v2_5 e eleven_turbo_v2 são funcionalmente equivalentes aos
modelos eleven_flash_v2_5 e eleven_flash_v2, respectivamente, exceto que a latência dos modelos Flash
é menor, em média. Recomendamos usar os modelos Flash em vez dos modelos Turbo em todos os casos
de uso.
Eleven v4
Eleven v4 é nosso modelo de síntese de fala de última geração, que oferece áudio da mais alta qualidade, expressividade e controle sobre a interpretação das vozes. O Eleven v4 oferece suporte à clonagem de voz de alta fidelidade, com preservação confiável do locutor em gerações de textos longos.
Este modelo funciona bem nos seguintes cenários:
- Locuções de personagens: Ideal para jogos e animações devido à sua variedade emocional.
- Diálogos emocionais: Gere diálogos naturais e realistas com ampla variedade emocional e compreensão contextual.
- Produção de audiolivros: Perfeito para narrações longas com interpretação emocional complexa.
- Projetos multilíngues: Mantém a qualidade consistente da voz ao alternar entre idiomas.
O Eleven v4 está disponível pela API Text to Dialogue.
Idiomas compatíveis
A família de modelos Eleven v4 oferece suporte a mais de 90 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), coreano (ko), quirguiz (ky), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Eleven v4 Turbo
Eleven v4 Turbo é nosso modelo de última geração para síntese de fala em tempo real, oferecendo áudio de alta qualidade, expressividade e controle sobre a interpretação das vozes. O Eleven v4 Turbo oferece suporte à clonagem de voz de alta fidelidade e entrega resultados com latência mediana de inferência de ~100 ms.
Este modelo funciona bem nos seguintes cenários:
- Agentes de suporte: Capacite agentes de voz que resolvem dúvidas de clientes em tempo real.
- Assistentes de IA: Gere diálogos naturais e realistas com ampla variedade emocional e compreensão contextual.
- Personagens interativos: Excelente para experiências de áudio com personagens expressivos.
O Eleven v4 Turbo está disponível pelo WebSocket Text to Dialogue.
Idiomas compatíveis
A família de modelos Eleven v4 oferece suporte a mais de 90 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), coreano (ko), quirguiz (ky), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Eleven v3
Eleven v3 é nosso modelo de síntese de fala da geração anterior, que produz fala natural e realista com ampla variedade emocional e compreensão contextual em vários idiomas.
Com o Eleven v3, vem uma nova API Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla variedade emocional e compreensão contextual em vários idiomas. O Eleven v3 também pode ser usado com a API Text to Speech para gerar fala natural e realista com ampla variedade emocional e compreensão contextual em vários idiomas.
Leia mais sobre a API Text to Dialogue aqui.
Idiomas compatíveis
O modelo Eleven v3 oferece suporte a mais de 70 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), chichewa (ny), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), quirguiz (ky), coreano (ko), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Eleven v3 Conversational
Eleven v3 Conversational é nosso modelo da geração anterior para síntese de fala em tempo real. Ele produz fala natural e realista com ampla variedade emocional e compreensão contextual em vários idiomas.
Com o Eleven v3 Conversational, vem um novo WebSocket Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla variedade emocional e compreensão contextual em vários idiomas.
Com o Eleven v3 Conversational, vem um novo WebSocket Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla variedade emocional e compreensão contextual em vários idiomas.
Leia mais sobre o WebSocket Text to Dialogue aqui.
Idiomas compatíveis
O modelo Eleven v3 oferece suporte a mais de 70 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), chichewa (ny), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), quirguiz (ky), coreano (ko), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Multilingual v2
Eleven Multilingual v2 é um modelo de síntese de fala da geração anterior com percepção emocional. Ele produz fala natural e realista com ampla variedade emocional e compreensão contextual em vários idiomas.
O modelo oferece qualidade e personalidade de voz consistentes em todos os idiomas compatíveis, preservando as características únicas e o sotaque do locutor.
Este modelo se destaca em cenários que exigem fala de alta qualidade e nuances emocionais:
- Locuções de personagens: Ideal para jogos e animações devido à sua variedade emocional.
- Conteúdo profissional: Muito indicado para vídeos corporativos e materiais de e-learning.
- Projetos multilíngues: Mantém a qualidade consistente da voz ao alternar entre idiomas.
- Qualidade estável: Produz áudio consistente e de alta qualidade.
Embora tenha maior latência e custo por caractere do que os modelos Flash, ele oferece qualidade superior para projetos em que uma fala realista é importante.
Nossos modelos multilíngues v2 oferecem suporte a 29 idiomas:
Inglês (EUA, Reino Unido, Austrália, Canadá), Japonês, Chinês, Alemão, Hindi, Francês (França, Canadá), Coreano, Português (Brasil, Portugal), Italiano, Espanhol (Espanha, México), Indonésio, Holandês, Turco, Filipino, Polonês, Sueco, Búlgaro, Romeno, Árabe (Arábia Saudita, Emirados Árabes Unidos), Tcheco, Grego, Finlandês, Croata, Malaio, Eslovaco, Dinamarquês, Tâmil, Ucraniano e Russo.
Flash v2.5
Eleven Flash v2.5 é nosso modelo de síntese de fala mais rápido, desenvolvido para aplicações em tempo real e a Agents Platform. Ele oferece fala de alta qualidade com latência ultrabaixa (~75 ms†) em 32 idiomas.
O modelo equilibra velocidade e qualidade, sendo ideal para aplicações interativas e mantendo resultados naturais e características de voz consistentes entre idiomas.
Este modelo é especialmente indicado para:
- Agents Platform: Perfeito para agentes de voz e chatbots em tempo real.
- Aplicações interativas: Ideal para jogos e aplicações que exigem resposta imediata.
- Processamento em grande escala: Eficiente para conversão em massa de texto em fala.
Com menor preço para gerações pela API e latência de 75 ms, o Flash v2.5 é a opção econômica para quem precisa de síntese de fala rápida e confiável em vários idiomas.
O Flash v2.5 oferece suporte a 32 idiomas — todos os idiomas dos modelos v2, além de:
Húngaro, Norueguês e Vietnamita
† Exclui a latência da aplicação e da rede. Consulte Entenda a latência.
Considerações
Normalização de texto com números
Ao usar o Flash v2.5, os números não são normalizados por padrão da forma que você talvez espere. Por exemplo, números de telefone podem ser lidos de uma maneira que não seja clara para o usuário. Datas e moedas são afetadas de modo semelhante.
Por padrão, a normalização é desativada no Flash v2.5 para manter a baixa latência. No entanto, clientes Enterprise agora podem ativar a normalização de texto para os modelos v2.5 definindo o parâmetro apply_text_normalization como “on” na solicitação.
O modelo Multilingual v2 faz um trabalho melhor na normalização de números, por isso recomendamos usá-lo para números de telefone e outros casos em que a normalização de números seja importante.
Para aplicações de baixa latência ou da Agents Platform, a prática recomendada é fazer com que seu LLM normalize o texto antes de enviá-lo ao modelo TTS, ou usar o parâmetro apply_text_normalization (somente planos Enterprise para modelos v2.5).
Guia de seleção de modelos
Para saber qual modelo atende melhor aos seus requisitos e caso de uso, consulte o guia de seleção de modelos.
Requisitos
Caso de uso
Limites de caracteres
O número máximo de caracteres compatível em uma única solicitação de texto em fala varia conforme o modelo.
Scribe v2
Scribe v2 é nosso modelo de reconhecimento de fala de última geração, desenvolvido para transcrições precisas em mais de 90 idiomas. Ele fornece timestamps precisos no nível de palavra e recursos avançados, como diarização de locutores e marcação dinâmica de áudio.
Este modelo se destaca em cenários que exigem conversão precisa de fala em texto:
- Serviços de transcrição: Perfeito para converter conteúdo de áudio/vídeo em texto
- Documentação de reuniões: Ideal para registrar e documentar conversas
- Análise de conteúdo: Muito indicado para processamento e análise de conteúdo de áudio
- Reconhecimento multilíngue: Compatível com transcrição precisa em mais de 90 idiomas
Principais recursos:
- Transcrição precisa com timestamps no nível de palavra
- Diarização de locutores para áudios com vários locutores
- Marcação dinâmica de áudio para mais contexto
- Compatível com mais de 90 idiomas
- Detecção de entidades
- Prompt de termos-chave
- Edição de transcrições
Leia mais sobre o Scribe v2 aqui.
Scribe v2 Realtime
Scribe v2 Realtime, nosso modelo de reconhecimento de fala ao vivo mais rápido e preciso, oferece precisão de última geração em mais de 90 idiomas, com latência ultrabaixa de 150 ms.
Este modelo se destaca em casos de uso conversacionais:
- Transcrição de reuniões ao vivo: Perfeito para transcrição em tempo real
- Agentes de IA: Ideal para conversas ao vivo
- Reconhecimento multilíngue: Compatível com transcrição precisa em mais de 90 idiomas e reconhecimento automático de idioma
Principais recursos:
- Latência ultrabaixa: receba transcrições parciais em ~150 milissegundos
- Suporte a streaming: envie áudio em blocos enquanto recebe transcrições em tempo real
- Vários formatos de áudio: compatível com PCM (de 8 kHz a 48 kHz) e codificação μ-law
- Detecção de atividade de voz (VAD): segmentação automática da fala com base na detecção de silêncio
- Controle de confirmação manual: controle total sobre quando finalizar segmentos da transcrição
- Detecção de entidades
- Edição de transcrições
Leia mais sobre o Scribe v2 Realtime aqui.
Scribe v2 Medical
Scribe v2 Medical é um modelo de reconhecimento de fala em lote especializado em áudio médico e clínico. É um finetune do Scribe v2 que melhora o reconhecimento de nomes de medicamentos, anatomia, patologia e ditado clínico, mantendo a precisão do Scribe v2 em fala cotidiana. Ele usa a mesma API Speech to Text do Scribe v2 e é cobrado pela mesma tarifa. Passe scribe_v2_medical como model_id.
Uso pretendido
Scribe v2 Medical é um modelo de API Speech-to-Text em lote para desenvolvedores e organizações integrarem a aplicações que convertem áudio clínico, incluindo conversas entre profissionais de saúde e pacientes, ditados, chamadas de admissão e coordenação de cuidados, em rascunhos de transcrições para documentação e fluxos de trabalho administrativos relacionados. O texto resultante é destinado à revisão e correção por um profissional de saúde ou outro usuário autorizado antes do uso. O Scribe v2 Medical não se destina a interpretar informações clínicas nem fornecer diagnósticos, recomendações de tratamento, decisões clínicas ou outras orientações clínicas.
Este modelo é muito indicado para:
- Documentação clínica: Consultas ambientais e anotações em que termos médicos surgem durante a conversa
- Ditado: Sequências densas de medicamentos, dosagens e achados
- Chamadas de admissão e coordenação: Pacientes descrevendo suas próprias condições, geralmente por telefone
- Fluxos de trabalho de conformidade: Combine com a detecção de entidades para categorias de PHI
Principais recursos:
- Mesmo formato de solicitação do Scribe v2 (
keyterms,entity_detection,no_verbatim, diarização, timestamps) - Melhor reconhecimento de nomes de medicamentos e termos de anatomia e patologia
- Sem perda de desempenho na fala cotidiana em comparação ao Scribe v2
- Compatível com mais de 90 idiomas
- Diarização de locutores para áudios com vários locutores
- Marcação dinâmica de áudio
- Detecção de entidades, incluindo categorias de PHI
Scribe v2 Medical é um modelo em lote. Para transcrição ao vivo, use o Scribe v2 Realtime.
Scribe v2 Medical é elegível para HIPAA, com Acordos de Associado Comercial disponíveis para clientes Enterprise, além do Modo de Retenção Zero (ZRM). Com o ZRM ativado, a entrada de áudio e a saída de texto são excluídas imediatamente após a conclusão de cada solicitação. A ElevenLabs não retém nada, e sua aplicação recebe a resposta completa da API e mantém as transcrições sob seus próprios controles.
Empresas que exigem conformidade com a HIPAA devem entrar em contato com as Vendas da ElevenLabs para assinar um Acordo de Associado Comercial (BAA) antes de enviar informações de saúde protegidas.
Leia mais sobre Speech to Text aqui.
Eleven Realtime
Eleven Realtime é uma nova classe de modelos Speech to Speech para criar agentes de voz naturais. Cada modelo Realtime é um agente de voz completo: reconhecimento de fala, detecção de atividade de voz e alternância de turnos, LLM e texto em fala, selecionados e ajustados pela ElevenLabs para funcionar juntos como um único sistema. Selecione um modelo Realtime e você terá um agente de bom desempenho a partir de uma única escolha, sem componentes para configurar.
Há dois modelos Realtime disponíveis.
Eleven Realtime v1 Mini é otimizado para conversas rápidas e naturais e funciona bem nos seguintes cenários:
- Assistentes de IA: Diálogos rápidos e expressivos em que a própria conversa é o produto.
- Tutores educacionais: Interações naturais que acompanham o ritmo de aprendizagem.
- Personagens interativos: Personagens expressivos para jogos e entretenimento.
Eleven Realtime v1 Max é otimizado para tarefas complexas e funciona bem nos seguintes cenários:
- Suporte ao cliente: Resolução de dúvidas que exigem seguir um processo e buscar informações.
- Qualificação de leads: Conversas estruturadas que coletam informações e definem os próximos passos.
- Fluxos de trabalho com várias etapas: Tarefas que chamam ferramentas para buscar informações ou executar ações.
Principais recursos:
- Reconhecimento de fala, alternância de turnos, modelo de linguagem e voz em uma única escolha de modelo
- Alternância de turnos e tratamento de interrupções naturais
- Chamada de ferramentas
- Vozes personalizáveis da Voice Library da ElevenLabs
- Compatível com mais de 90 idiomas
- Alterne entre v1 Mini e v1 Max com uma seleção de modelo, sem mudar a integração
Eleven Realtime está disponível no ElevenAgents, onde você seleciona um modelo Realtime no menu suspenso de modelos, e pela API Realtime, desenvolvida para ser compatível com a API Realtime da OpenAI via WebSocket. Se você já usa a API Realtime da OpenAI, consulte o guia de migração.
Idiomas compatíveis
Os modelos Realtime são compatíveis com mais de 90 idiomas. Consulte a lista de idiomas do Eleven v4.
Leia mais sobre o Eleven Realtime aqui.
Eleven Music
Eleven Music é nosso modelo de geração de música com qualidade de estúdio. Ele permite gerar música em qualquer estilo usando prompts em linguagem natural.
Este modelo é excelente para os seguintes cenários:
- Trilhas sonoras para jogos: Crie trilhas envolventes para jogos
- Músicas de fundo para podcasts: Aprimore podcasts com música profissional
- Marketing: Adicione música de fundo a vídeos de anúncios
Principais recursos:
- Controle completo sobre gênero, estilo e estrutura
- Vocais ou apenas instrumental
- Multilíngue, incluindo inglês, espanhol, alemão, japonês e mais
- Edite o som e a letra de seções individuais ou da música inteira
Leia mais sobre o Eleven Music aqui.
Simultaneidade e prioridade
Seu plano de assinatura determina quantas solicitações podem ser processadas simultaneamente e o nível de prioridade das suas solicitações na fila. O Speech to Text tem um limite de simultaneidade maior. Quando o limite de simultaneidade é atingido, as solicitações subsequentes são processadas em uma fila junto com solicitações de menor prioridade. Na prática, isso normalmente adiciona apenas cerca de 50 ms de latência.
Os cabeçalhos de resposta incluem current-concurrent-requests e maximum-concurrent-requests, que você pode usar para monitorar sua simultaneidade.
Solicitações de API por minuto vs. solicitações simultâneas
É importante entender que solicitações de API por minuto e solicitações simultâneas são métricas diferentes que dependem dos seus padrões de uso.
As solicitações de API por minuto podem ser diferentes das solicitações simultâneas, pois dependem da duração de cada solicitação e de como elas são agrupadas.
Exemplo 1: Solicitações espaçadas Se você tivesse 180 solicitações por minuto, cada uma levando 1 segundo para ser concluída, e as enviasse com um intervalo de 0,33 segundo, o máximo de solicitações simultâneas seria 3 e a média também seria 3, pois sempre haveria 3 em andamento.
Exemplo 2: Solicitações em lote No entanto, se você tivesse um padrão de uso diferente, como 180 solicitações por minuto, cada uma levando 3 segundos para ser concluída, mas todas disparadas de uma vez, o máximo de solicitações simultâneas seria 180 e a média seria 9 (nos primeiros 3 segundos do minuto, houve 180 solicitações de uma vez; nos 57 segundos finais, houve 0 solicitações).
Como nosso sistema considera a simultaneidade, as solicitações por minuto são menos importantes do que a duração de cada solicitação e o padrão de quando elas são enviadas.
A forma como as solicitações aos endpoints são feitas afeta os limites de simultaneidade:
- Com HTTP, cada solicitação conta individualmente para o seu limite de simultaneidade.
- Com o WebSocket de Text to Speech, apenas o período em que nosso modelo está gerando áudio conta para o seu limite de simultaneidade. Isso significa que, na maior parte do tempo, um websocket aberto não conta para o seu limite de simultaneidade.
- Os WebSockets de Texto para Diálogo funcionam de forma diferente: cada conexão aberta reserva uma sessão de diálogo de um pool separado enquanto permanecer aberta, e o áudio gerado pela conexão não conta para seu limite padrão de simultaneidade. Isso foi projetado para ser mais simples de entender: uma conexão equivale a uma sessão, e seus limites de sessão de diálogo são dimensionados para se adaptar a essa nova metodologia de simultaneidade. Consulte simultaneidade de Texto para Diálogo.
Entendendo os limites de simultaneidade
O limite de simultaneidade associado ao seu plano não deve ser interpretado como o número máximo de conversas, chamadas telefônicas, locuções de personagens etc. que podem ser processadas ao mesmo tempo. O número real depende de vários fatores, incluindo as vozes IA específicas usadas e as características do caso de uso.
Como regra geral, um limite de simultaneidade de 5 normalmente pode comportar até aproximadamente 100 transmissões de áudio simultâneas.
Isso se deve à velocidade de geração do áudio em relação ao tempo necessário para processar a solicitação de TTS. O diagrama abaixo mostra um exemplo de como 4 chamadas simultâneas com usuários diferentes podem ser atendidas usando apenas 2 solicitações simultâneas.
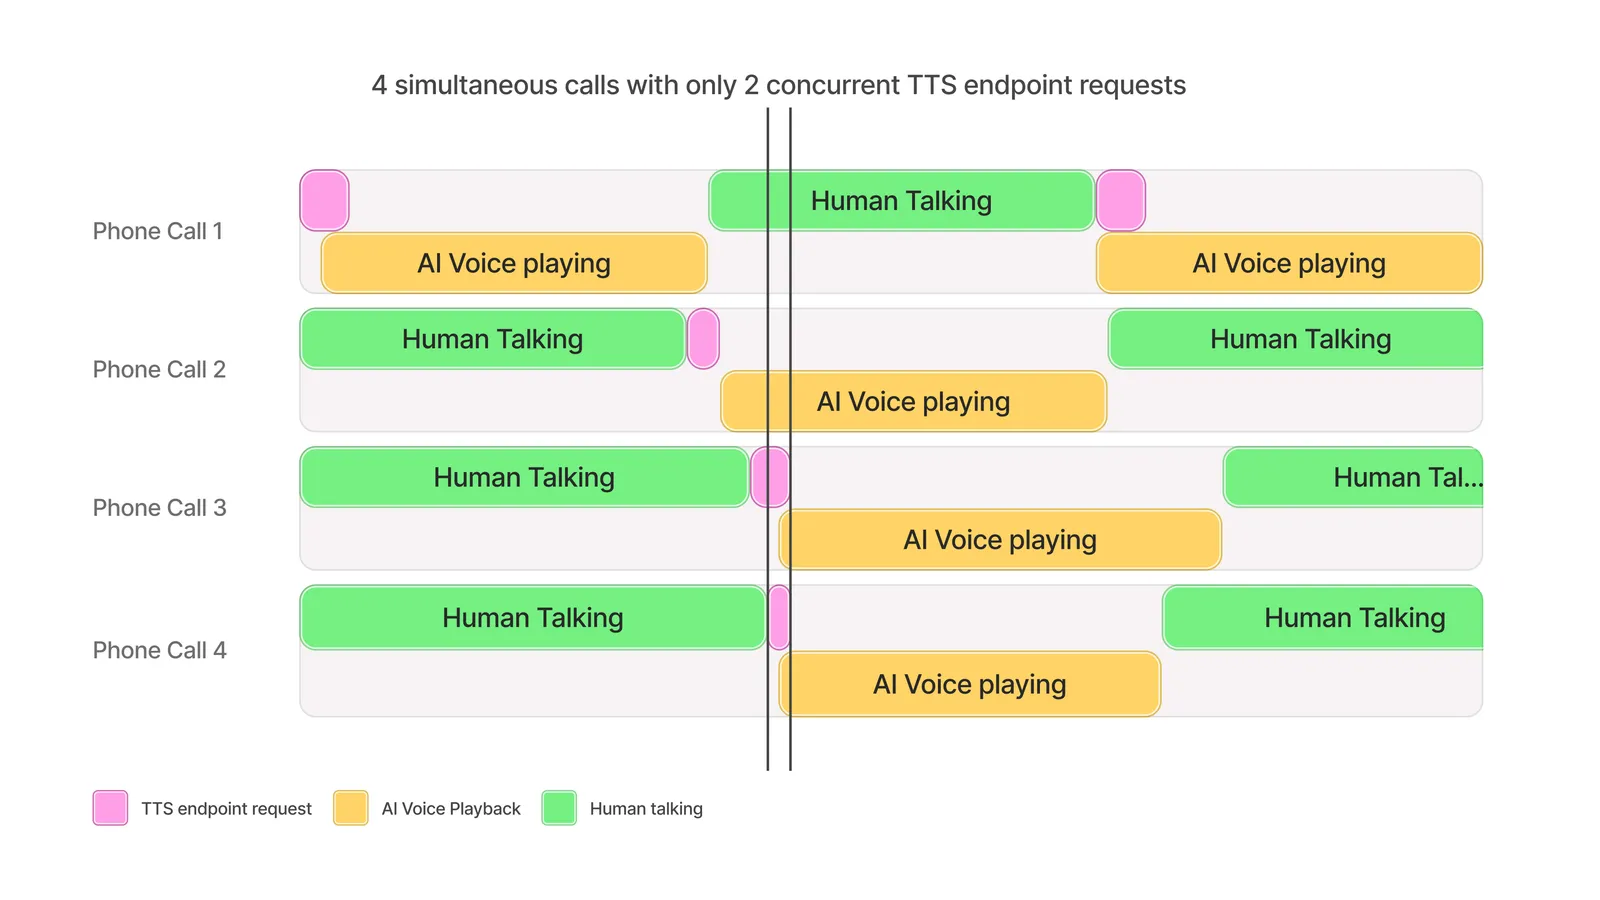
Criando agentes de voz com IA
Quando o TTS é usado para facilitar diálogos, um limite de simultaneidade de 5 pode comportar cerca de 100 transmissões em conversas equilibradas entre agentes de IA e participantes humanos.
Para casos de uso em que o agente de IA fala com menos frequência do que o humano, como interações de suporte ao cliente, é possível comportar mais de 100 conversas simultâneas.
Locuções de personagens
Em geral, mais de 100 locuções simultâneas de personagens podem ser processadas com um limite de simultaneidade de 5.
O número pode variar dependendo da frequência das falas do personagem, da duração das pausas e das ações no jogo entre as falas.
Dublagem ao vivo
Os fluxos de dublagem simultâneos geralmente seguem a estimativa fornecida.
Se a transmissão incluir períodos de pausa na conversa (por exemplo, por causa de uma trilha sonora, cenas visuais etc.), pode ser possível ter mais fluxos de dublagem simultâneos do que o sugerido.
Se você exceder os limites de simultaneidade do seu plano em algum momento e estiver no plano Enterprise, as solicitações do modelo ainda poderão ser concluídas, embora mais lentamente, dependendo da capacidade disponível e sem garantia.
Para aumentar seu limite de simultaneidade e a prioridade na fila, faça upgrade do seu plano de assinatura.
Clientes Enterprise podem solicitar um limite de simultaneidade maior entrando em contato com seu gerente de conta.
Simultaneidade de Texto para Diálogo
As solicitações de Texto para Diálogo são medidas de duas formas diferentes, dependendo de como você chama a API:
- Os endpoints HTTP (Criar diálogo e Transmitir diálogo) contam para o limite padrão de simultaneidade do seu plano enquanto o áudio está sendo gerado, como qualquer outra solicitação de Text to Speech.
- Os endpoints WebSocket, como o WebSocket de Texto para Diálogo, são medidos como sessões de diálogo. Uma conexão aberta mantém uma sessão de diálogo enquanto permanecer aberta, independentemente de o áudio estar sendo gerado no momento.
A medição baseada em sessões simplifica o planejamento de capacidade: uma conexão equivale a uma sessão, para que seu uso não varie com a atividade de geração. Como uma sessão é mantida durante toda a conexão, e não apenas enquanto o áudio está sendo gerado, seus limites de sessão de diálogo são dimensionados para se adaptar a essa nova metodologia de simultaneidade.
Se você abrir uma conexão enquanto todas as sessões de diálogo do seu espaço de trabalho estiverem em uso, a nova conexão será rejeitada com um erro too_many_concurrent_requests. Para liberar sessões, feche as conexões de que você não precisa mais — uma conexão também é fechada automaticamente após 20 segundos de inatividade, a menos que você envie mensagens keep_alive.
Para monitorar as sessões de diálogo, abra Desenvolvedores na parte inferior da barra lateral do painel, selecione a aba Analytics e veja a métrica Solicitações simultâneas na visualização de uso. As sessões de diálogo são informadas como sua própria série, Sessões Websocket de TTD, separadas das suas outras solicitações simultâneas.
Teste de carga dos limites de simultaneidade
O teste de carga pode ser útil para identificar problemas de escalabilidade no cliente e verificar se os limites de simultaneidade estão configurados corretamente para seu caso de uso.
É altamente recomendável testar fluxos de trabalho completos o mais próximo possível do uso real. Simular e medir quantos usuários podem ser atendidos é a metodologia recomendada para isso. É importante:
- Simular usuários, não solicitações brutas
- Simular comportamentos típicos dos usuários, como aguardar a reprodução de áudio, a fala do usuário ou a conclusão da transcrição antes de fazer solicitações
- Aumentar lentamente o número de usuários ao longo de alguns minutos
- Introduzir aleatoriedade nos tempos e tamanhos das solicitações
- Capturar métricas de latência e quaisquer códigos de erro retornados pela API
Por exemplo, para testar um sistema de agentes projetado para atender 100 conversas simultâneas, você criaria até 100 “usuários” individuais, cada um simulando uma conversa. As conversas normalmente consistem em um ciclo repetido de cerca de 10 segundos de fala do usuário, seguido de uma chamada à API de TTS para cerca de 150 caracteres, seguida de cerca de 10 segundos de reprodução de áudio para o usuário. Portanto, cada usuário deve seguir o padrão de fazer uma chamada à API de Text to Speech por websocket para 150 caracteres de texto a cada 20 segundos, com uma pequena aleatoriedade introduzida no período de espera e no número de caracteres solicitados. O teste consistiria em iniciar um usuário por segundo até chegar a 100 e, em seguida, testar por 10 minutos no total para avaliar a estabilidade geral.
Exemplo de script de teste de carga
Este exemplo usa locust como framework de teste com chamadas diretas à API da ElevenLabs.
Ele segue o exemplo listado acima, testando um sistema de agente conversacional com cada usuário enviando 1 solicitação a cada 20 segundos.