Testa Conversational AI-agenter
- Skriven av
- Anna Neely
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
När konversationsbaserade röstassistenter tas i drift, hur övervakar du dem i stor skala? Hur upptäcker du när de inte fungerar som avsett? Och när du har gjort ändringar, hur testar du dem?
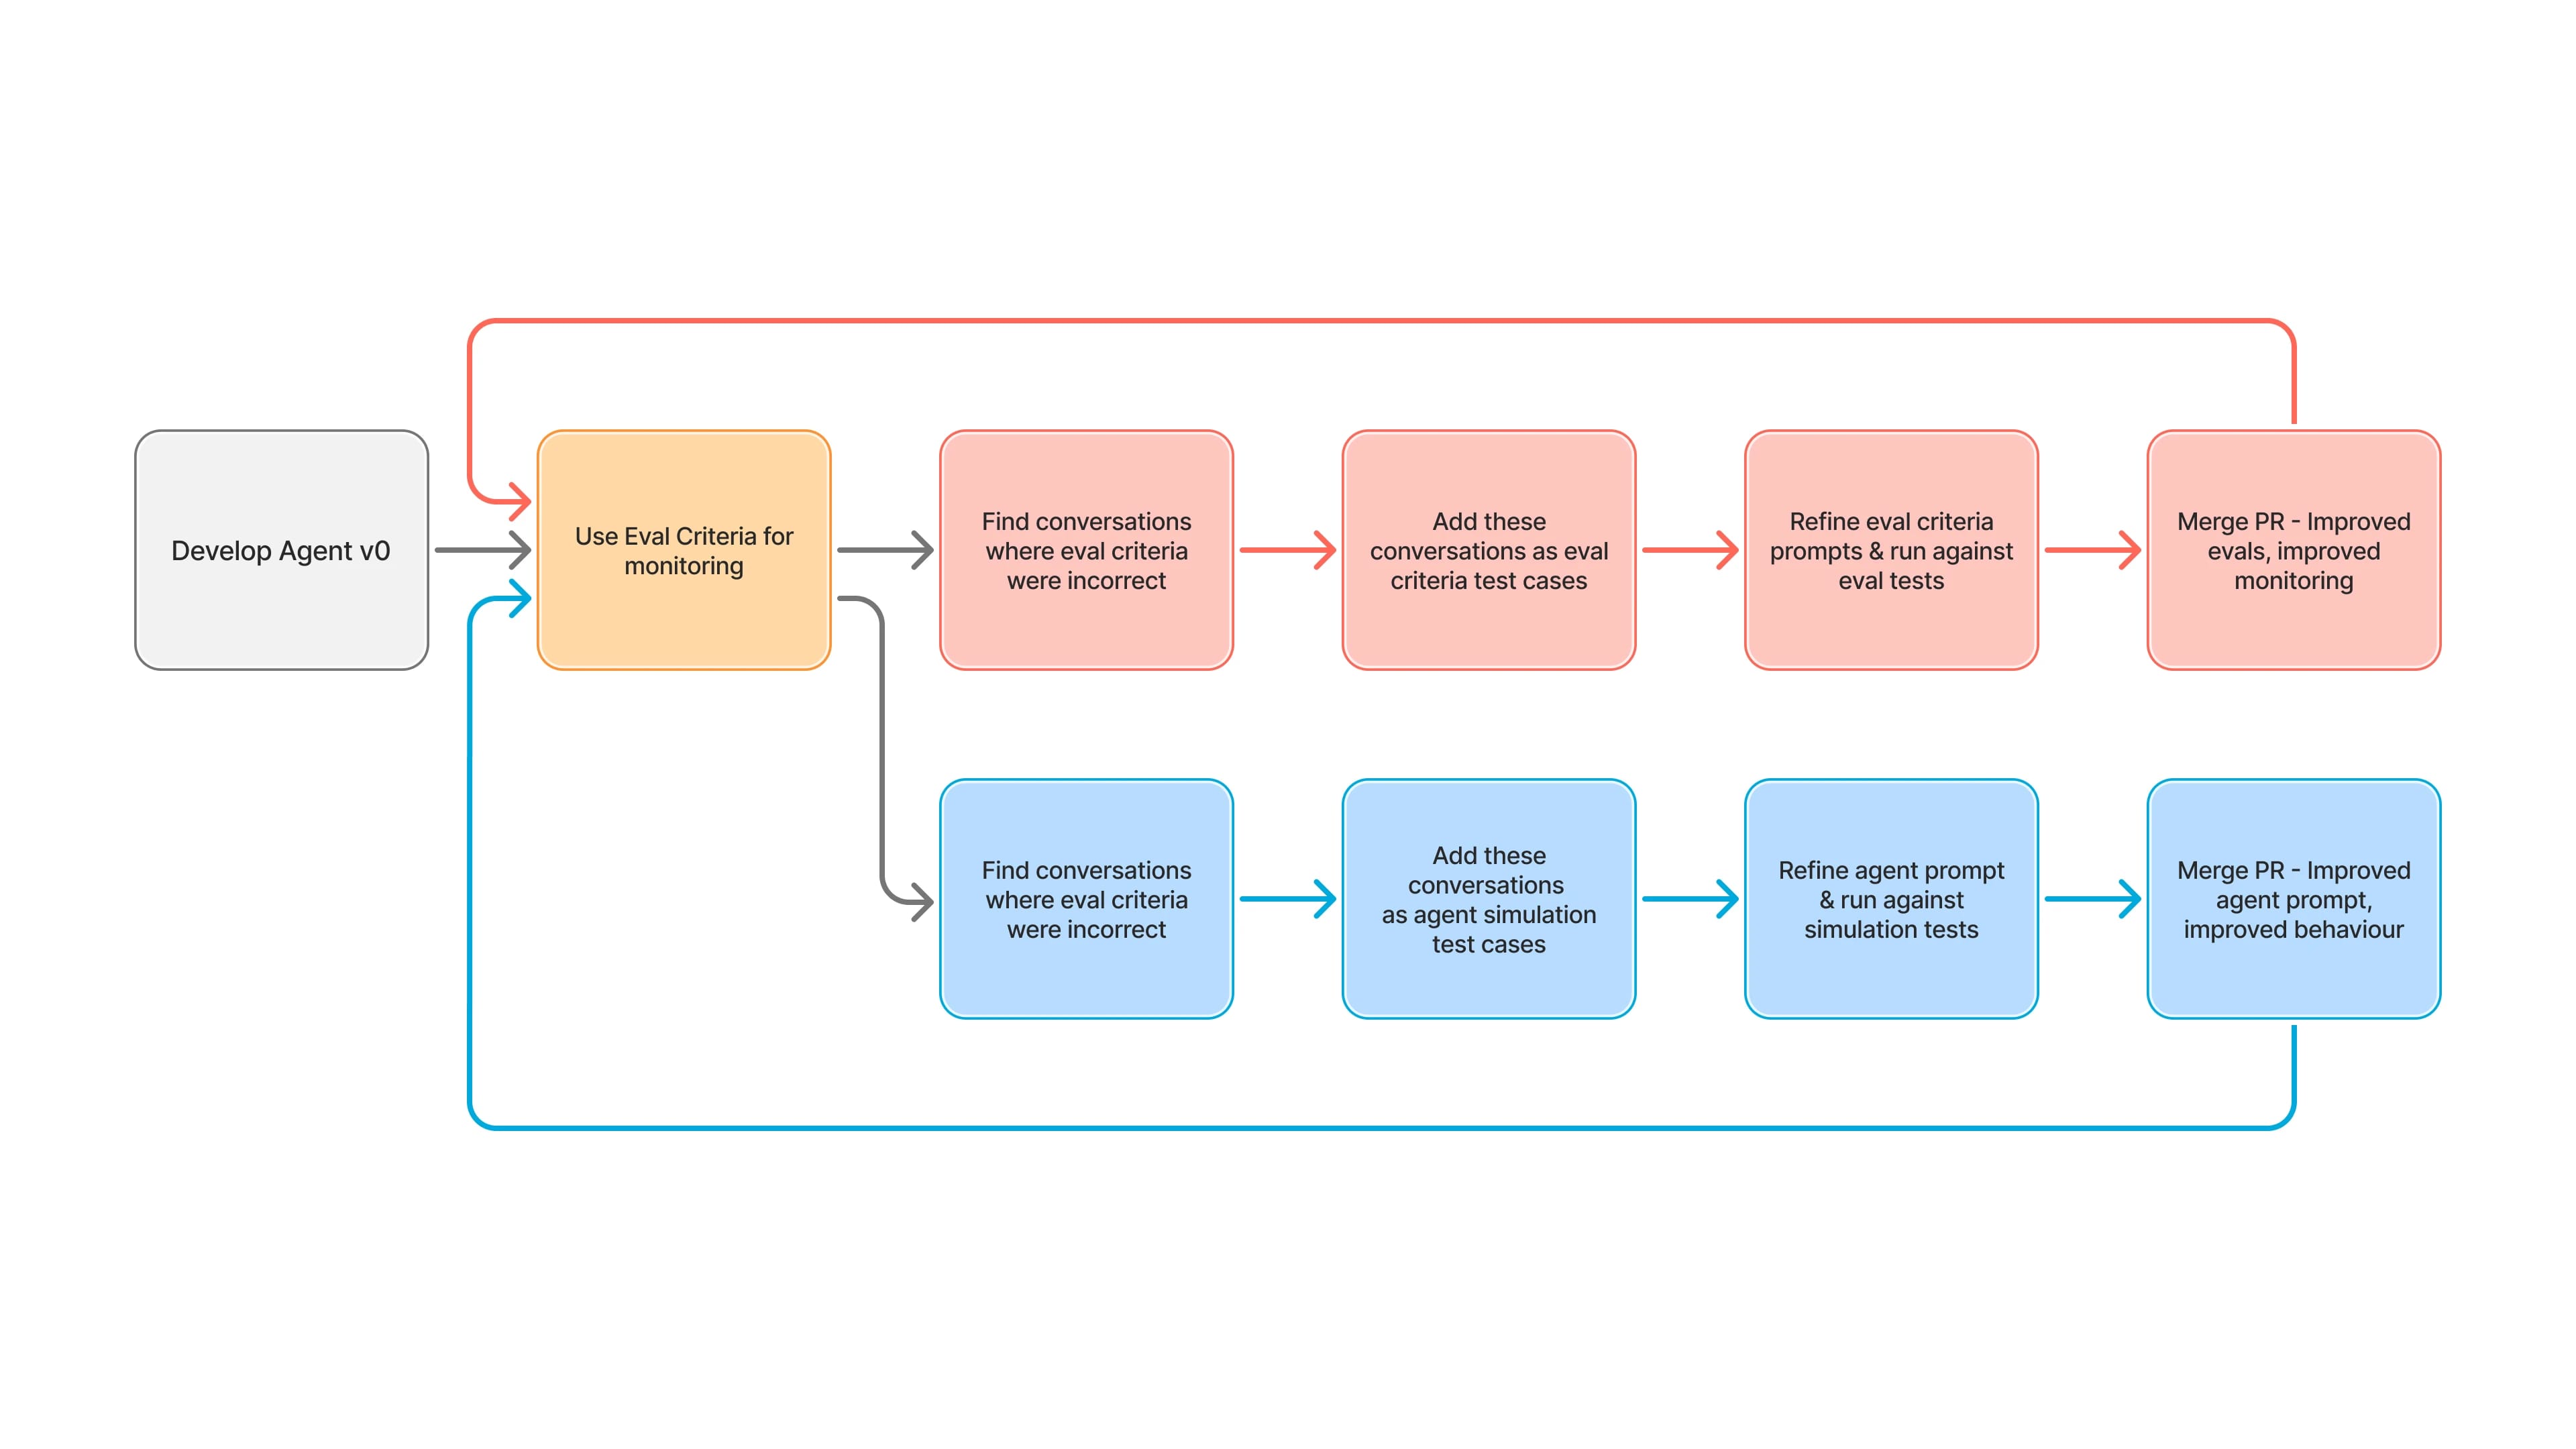
De här frågorna formade vårt arbete med El, vår dokumentationsassistent som drivs av Conversational AI. I takt med att El utvecklades byggde vi ett system för att övervaka, utvärdera och testa agenter, baserat på utvärderingskriterier och konversationssimuleringar.
Lägg grunden: Tillförlitliga utvärderingskriterier
För att förbättra en agent måste du först förstå hur den fungerar i verkliga situationer. Det innebar att förfina våra utvärderingskriterier och se till att de var tillräckligt korrekta och tillförlitliga för att övervaka agenternas prestanda. Vi definierar en misslyckad konversation som en där agenten antingen ger felaktig information eller inte hjälper användaren att nå sitt mål.
Vi tog fram följande utvärderingskriterier:
- Interaktion: är detta en giltig konversation, ställde användaren relevanta frågor och var konversationen rimlig?
- Positiv interaktion: var användaren nöjd när konversationen avslutades, eller var hen förvirrad eller frustrerad?
- Förstå grundorsaken: identifierade agenten användarens underliggande problem korrekt?
- Lösa användarens fråga: löste agenten användarens problem eller erbjöd den ett alternativt sätt att få hjälp?
- Hallucination: hittade agenten på information som inte finns i kunskapsbasen?
Om Interaktion misslyckas är själva konversationen inte giltig. Om något annat kriterium misslyckas undersöker vi det närmare. Undersökningen vägleder hur vi förbättrar agenten. Ibland handlar det om att förfina användningen av verktyg eller tidpunkter. Andra gånger handlar det om att lägga till skyddsåtgärder för att förhindra åtgärder som inte stöds.
Iterera med trygghet: Conversation Simulation API
När vi har identifierat vad som behöver förbättras är nästa steg att testa. Det är där vårt Conversation Simulation API kommer in. Det simulerar realistiska användarscenarier – både från början till slut och i riktade segment – och utvärderar automatiskt resultaten med samma kriterier som vi använder i produktion. Det har stöd för mockning av verktyg och anpassad utvärdering, vilket gör det flexibelt nog för att testa specifika beteenden.
Vi använder två metoder:
- Fullständiga simuleringar: Testa hela konversationer från början till slut.
- Partiella simuleringar: Börja mitt i konversationen för att validera beslutspunkter eller delflöden. Det är vår vanligaste metod för enhetstestning, eftersom den möjliggör snabb iteration och riktad felsökning.
Tydliga, fokuserade scenarier låter oss styra vad LLM:en testas på och säkerställer täckning för gränsfall, användning av verktyg och fallback-logik.
Automatisera i stor skala: Bädda in tester i CI/CD
Den sista delen är automatisering. Vi använde ElevenLabs öppna API:er för att koppla ihop dem med vårt GitHub DevOps-flöde genom att bädda in utvärdering och simulering i vår CI/CD-pipeline. Varje uppdatering testas automatiskt före driftsättning. Det förhindrar regressioner och ger oss snabb feedback om prestanda i verkliga situationer.
Resultat: En starkare, smartare El
Den här processen förändrade hur vi bygger och underhåller El. Vi har skapat en feedbackloop som kopplar verklig användning till strukturerad utvärdering, riktad testning och automatiserad validering. Det gör att vi kan leverera förbättringar snabbare och med större trygghet.
Och det är ett ramverk som vi nu kan använda för varje agent vi bygger.