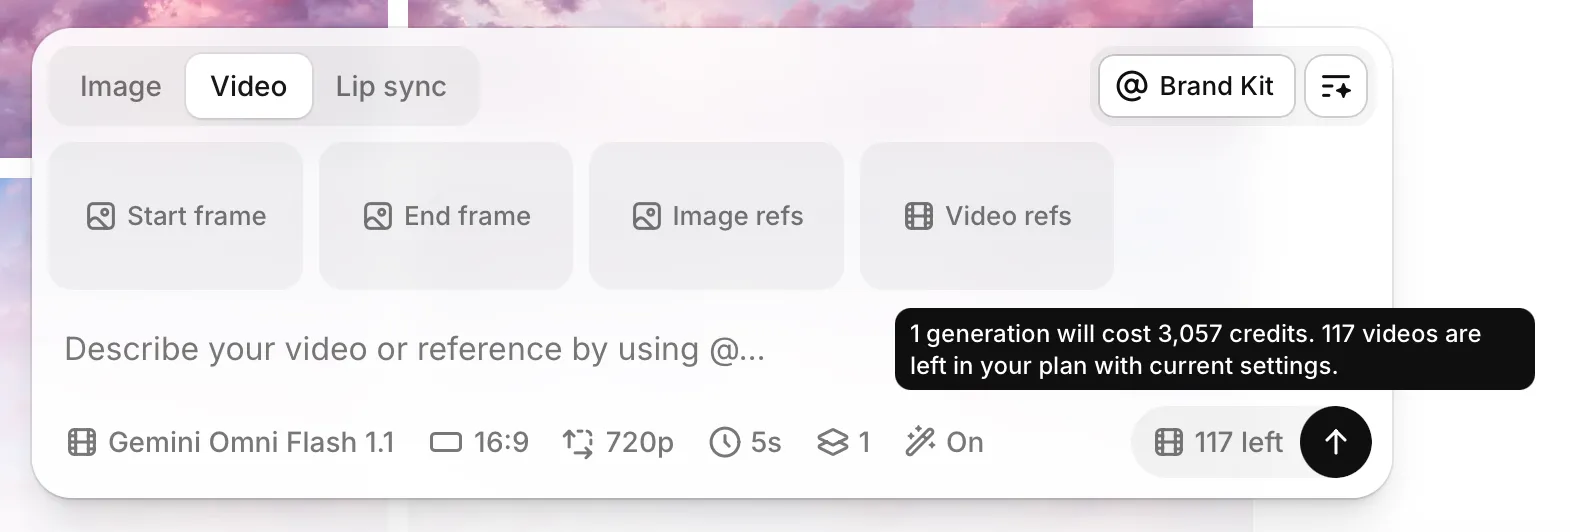
Imagem e Vídeo
Guia completo para criar e editar imagens e vídeos na ElevenLabs.
Visão geral
Imagem e Vídeo permite criar conteúdo visual de alta qualidade a partir de descrições simples em texto ou imagens de referência. Gere imagens estáticas ou vídeos dinâmicos em qualquer estilo, refine-os de forma iterativa com prompts adicionais, faça upscale para obter resultados em alta resolução e até adicione sincronização labial com áudio. Exporte os arquivos finalizados separadamente ou importe-os diretamente para projetos no ElevenCreative Studio.
Alguns modelos de Imagem e Vídeo e recursos de upload de arquivos são restritos nos Estados Unidos devido a requisitos regulatórios ou dos provedores. Consulte as descrições de cada modelo para verificar a disponibilidade específica.
Usuários do plano gratuito só podem gerar imagens e estão limitados a três solicitações de imagem por dia. A geração de vídeos requer um plano pago.
Guia
Siga estas etapas para criar seu primeiro arquivo visual:
Selecione o modo
Use o seletor no canto superior direito da caixa de prompt para escolher entre gerar Imagem ou Vídeo.
Forneça um prompt ou referência
Descreva o resultado desejado usando linguagem natural na caixa de prompt. Para ter mais controle, arraste imagens ou vídeos existentes das abas Explorar ou Histórico para os espaços de referência, ou faça upload das suas próprias imagens de referência em diversos formatos, incluindo JPG, PNG, WEBP e outros.
Escolha um modelo e as configurações
Selecione o modelo generativo ideal para seu objetivo (por exemplo, Google Veo 3.1, Kling 2.5, Flux 1 Kontext Pro). Consulte a seção Modelos para informações detalhadas sobre cada modelo. Ajuste configurações como proporção, resolução, duração (para vídeo) e o número de variações a gerar.
Gere seu arquivo
Clique no botão Gerar. Seus arquivos serão criados e exibidos na aba Histórico para revisão.
Melhore e refine
Use ferramentas de aprimoramento para aperfeiçoar sua mídia. Faça Upscale da resolução, aplique LipSync realista com áudio ou clique em Recriar para gerar uma nova variação com as mesmas configurações.
Fluxo de trabalho
O processo de criação leva você da inspiração ao arquivo finalizado em quatro etapas:
Explorar
Descubra criações da comunidade para encontrar inspiração, estudar prompts eficazes ou usar referências diretamente no seu trabalho.
Gerar
Use a caixa de prompt para descrever o que você quer criar, selecione um modelo, ajuste suas configurações e dê vida à sua ideia.
Histórico
Revise suas gerações na aba Histórico para iterar e aprimorar. Recrie variações, reutilize prompts e aplique melhorias como upscale e sincronização labial.
Exportar
Baixe arquivos finalizados em vários formatos ou envie-os diretamente para o ElevenCreative Studio para usá-los em seus projetos.
Explorar
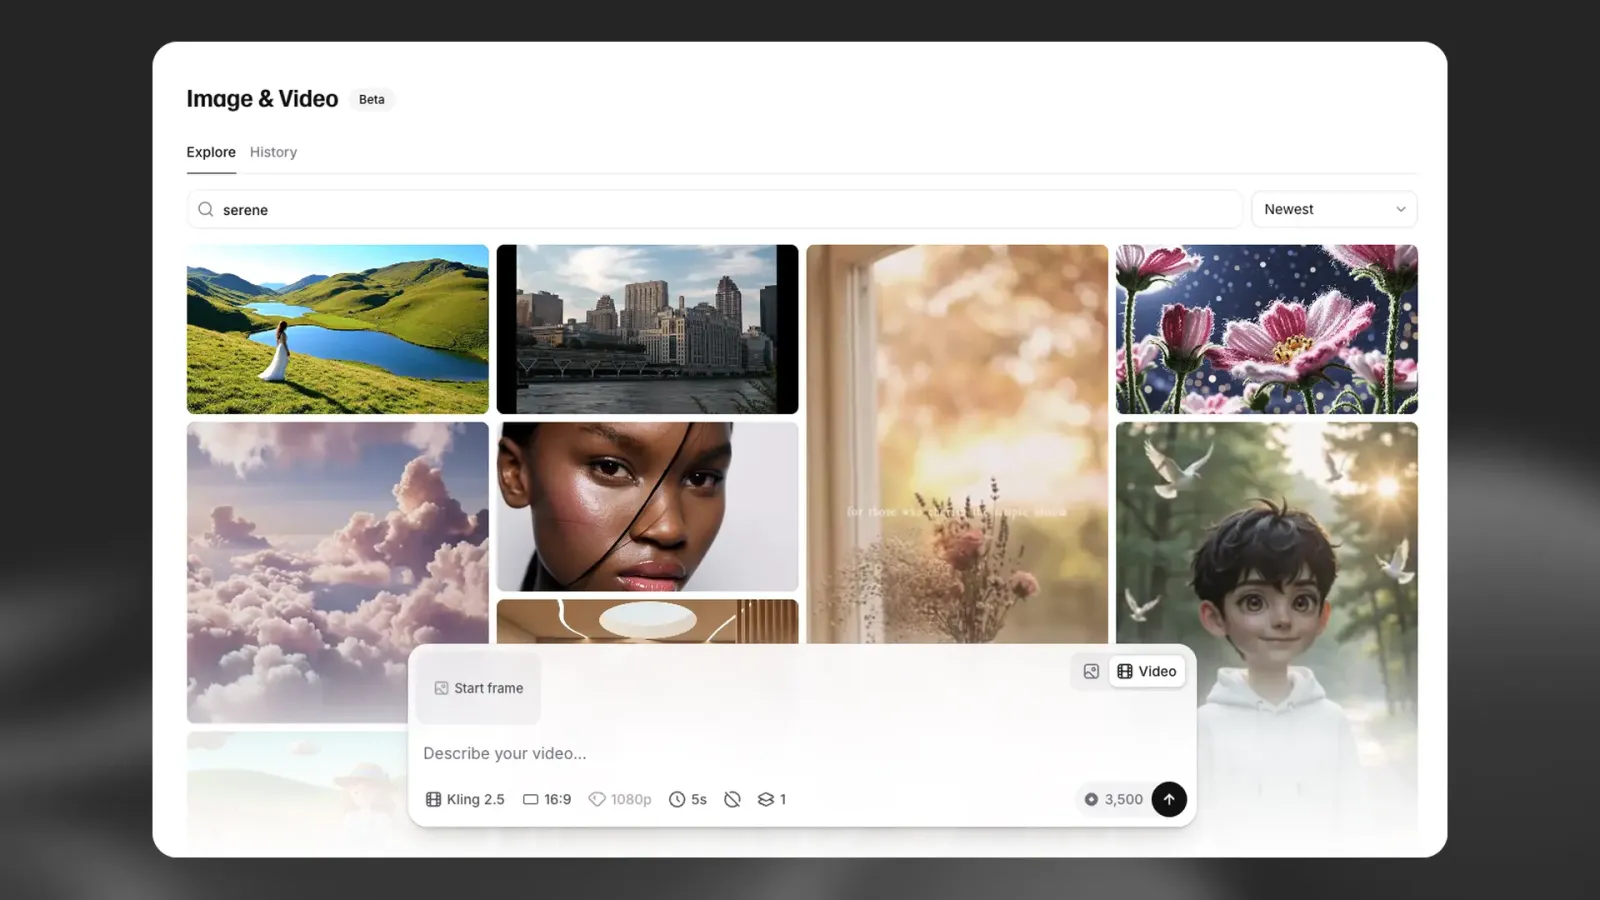
A aba Explorar exibe uma galeria de criações da comunidade para você encontrar inspiração e visuais para usar como referências.
Pesquisar: Use a barra de pesquisa para encontrar imagens e vídeos com base em palavras-chave.
Ordenar: Alterne entre Em alta e Mais recentes para ver o que é popular ou foi adicionado recentemente.
Arrastar e soltar: Arraste qualquer resultado da grade diretamente para a caixa de prompt para usá-lo como quadro inicial, quadro final ou referência de estilo.
Ver detalhes: Clique em qualquer item para ver o prompt completo e as configurações usadas para criá-lo.
Gerar
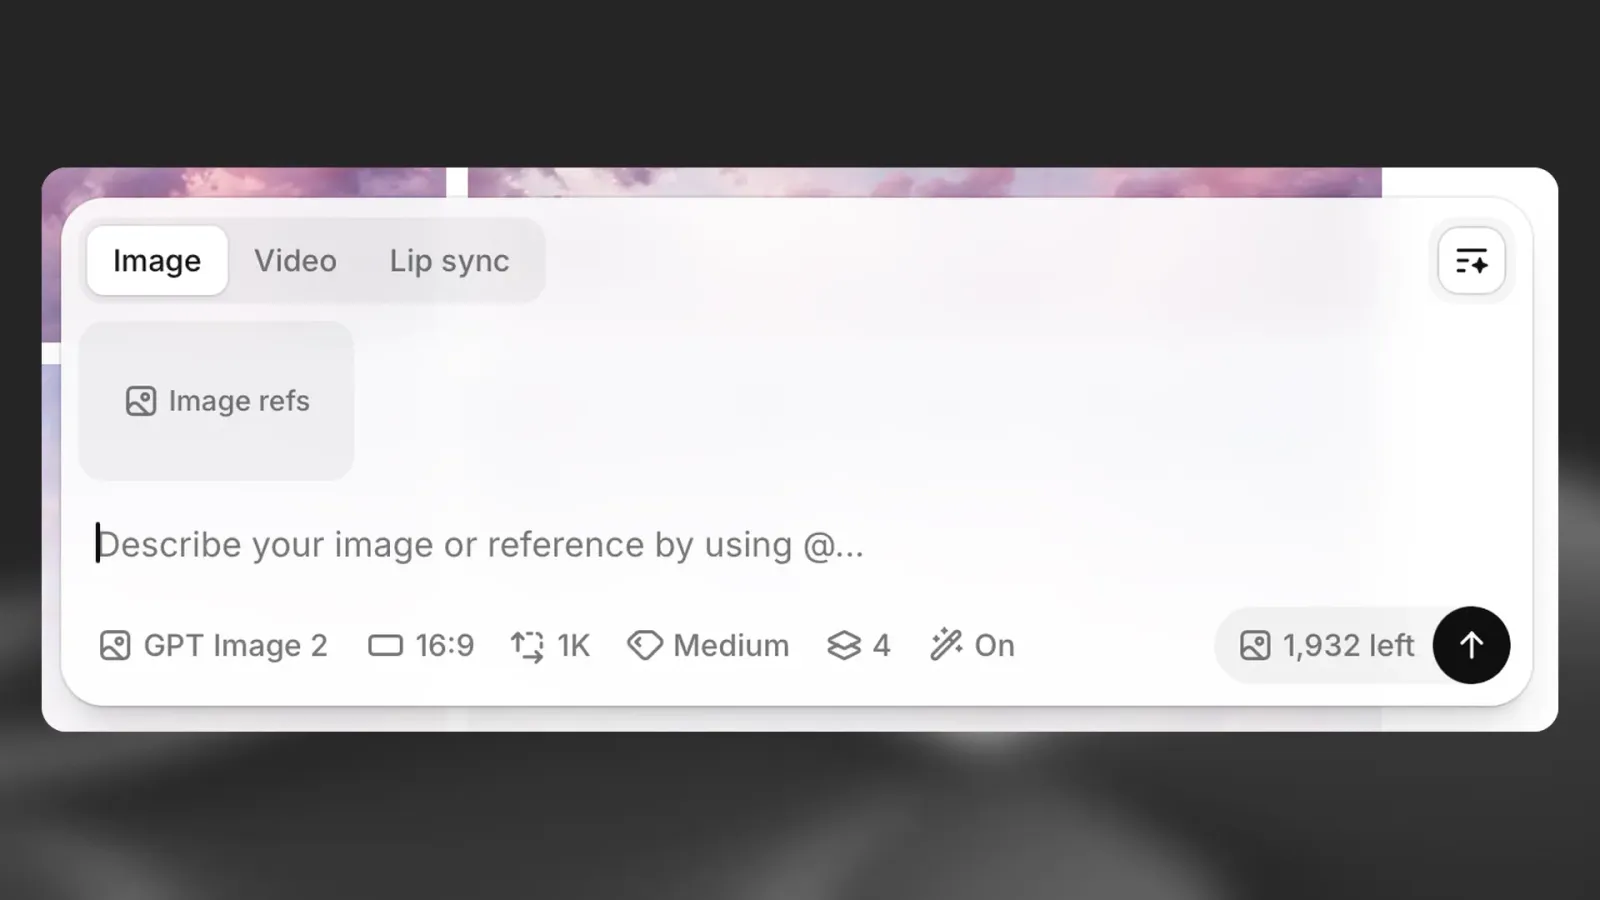
A caixa de prompt fica na parte inferior da página e oferece todos os controles para criar conteúdo visual.
Defina o modo e o prompt
Selecione o modo: Use o seletor no canto superior direito para alternar entre a geração de Imagem e Vídeo.
Escreva seu prompt: No campo principal, descreva o que você quer gerar usando linguagem natural. Seja claro e descritivo para obter os melhores resultados.
Escolha modelos e configurações
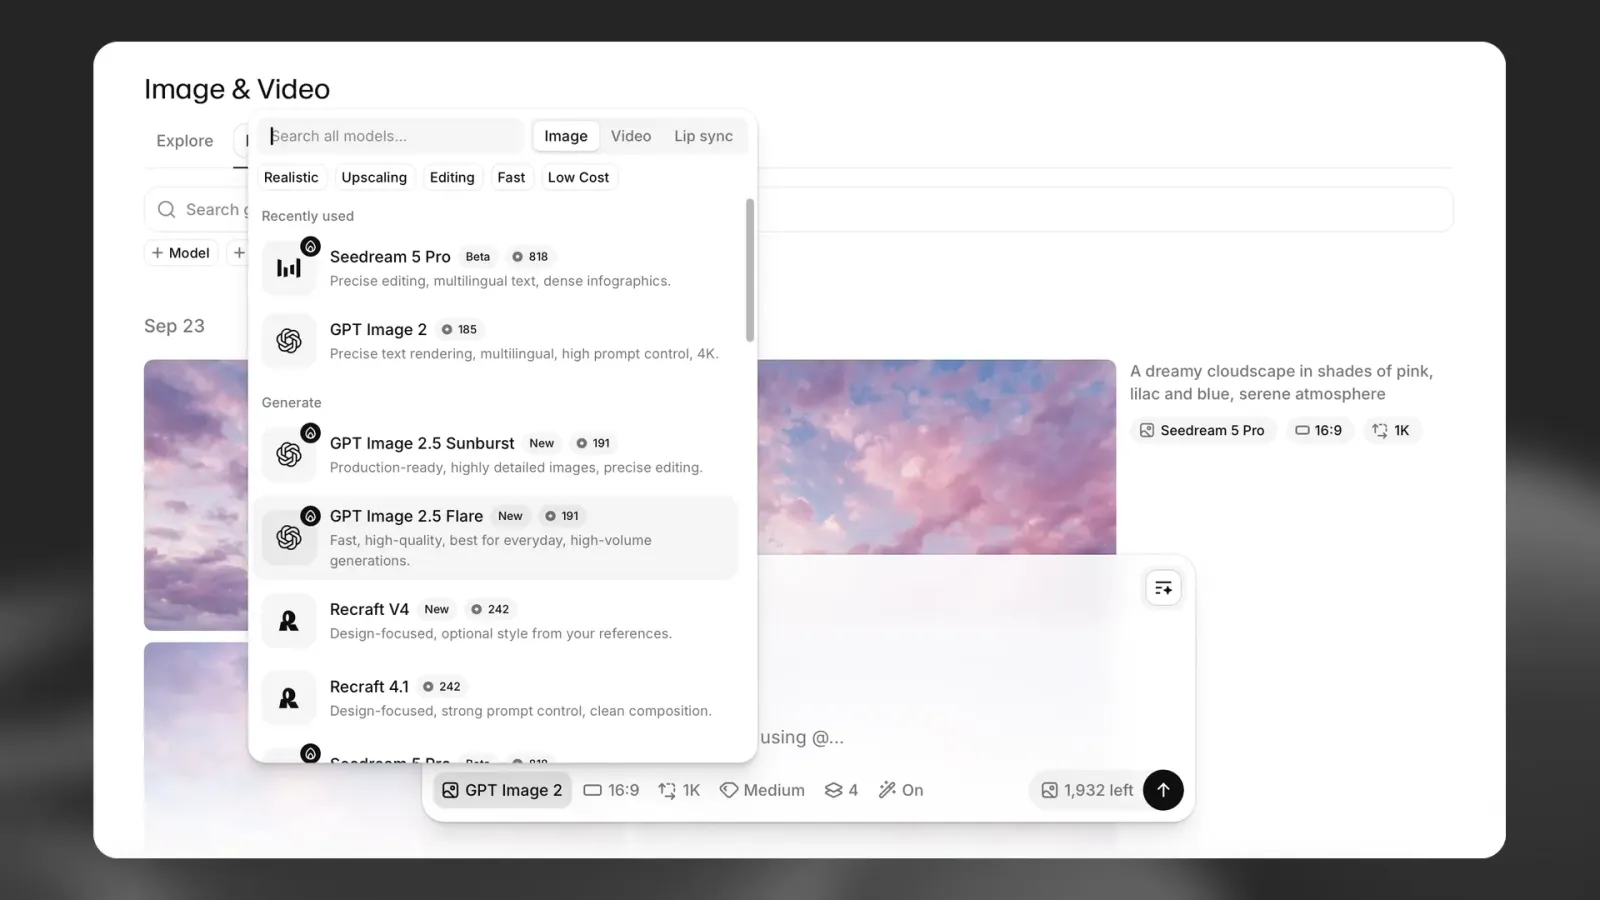
Selecione o modelo: Abra o menu de modelos para explorar opções disponíveis, como Google Veo 3.1, Kling 2.5 ou Flux 1 Kontext Pro. Cada modelo tem pontos fortes e recursos exclusivos listados para facilitar a comparação. Consulte a seção Modelos para informações detalhadas.
Ajuste as configurações: Personalize sua geração com as configurações exibidas abaixo do prompt. Elas variam conforme o modelo, mas geralmente incluem:
- Proporção: Controle as dimensões do resultado
- Resolução: Defina o nível de qualidade
- Duração: Especifique a duração do vídeo (no modo vídeo)
- Número de gerações: Crie até 4 variações de uma vez
Use os controles: Em modelos compatíveis, ative o Áudio, adicione um Prompt negativo para excluir elementos indesejados ou ajuste o Controle de som.
Adicione referências
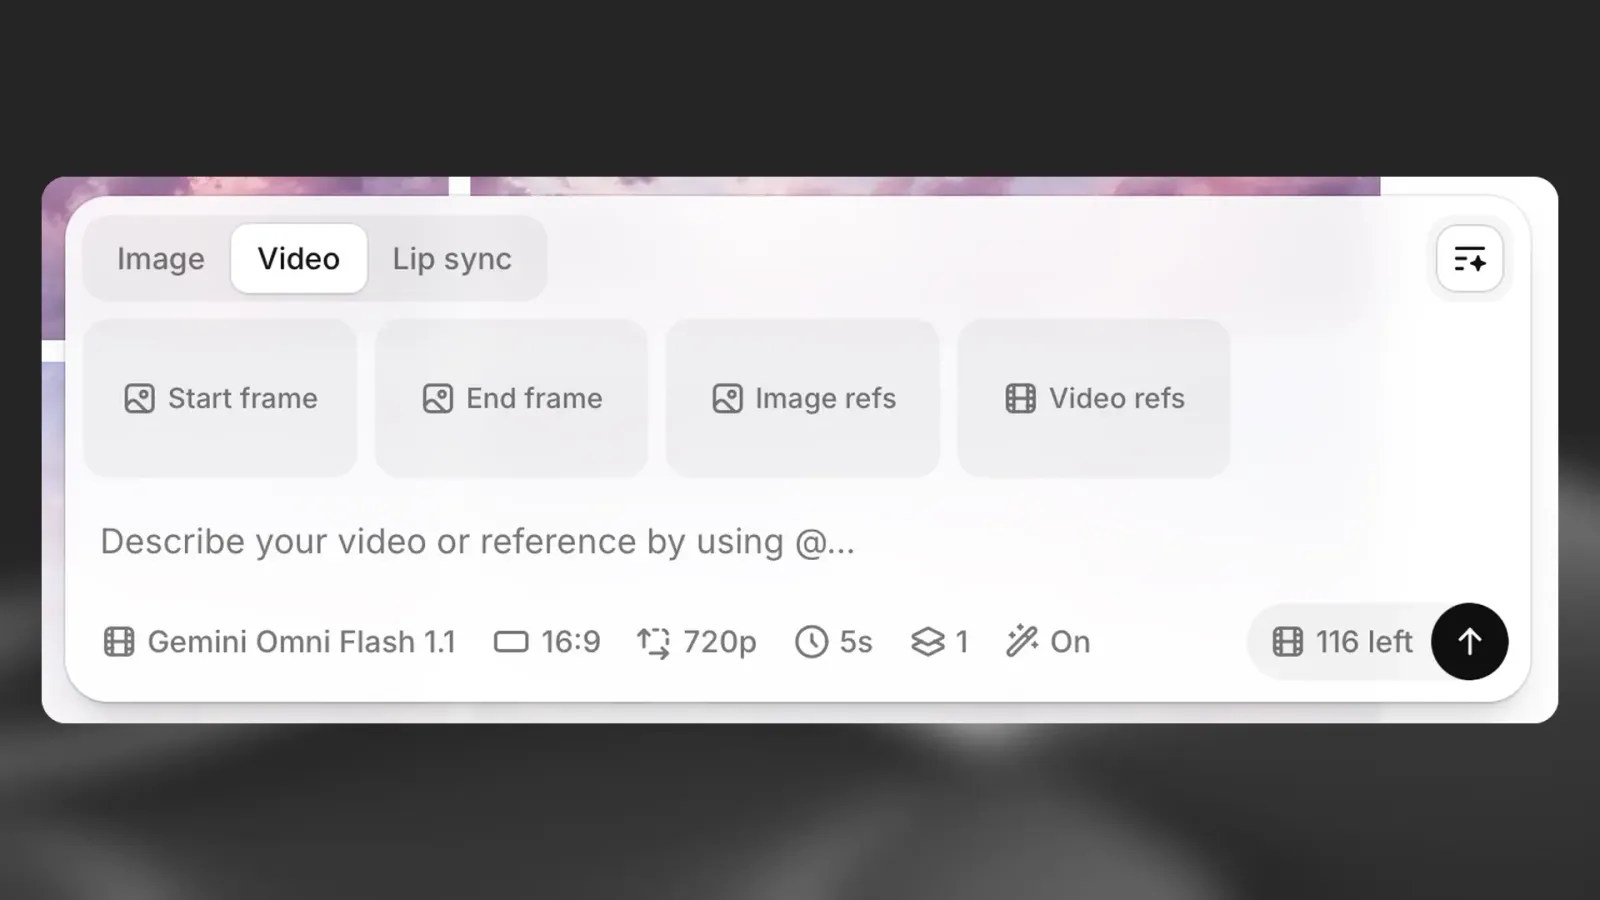
Para ter mais controle sobre o resultado, adicione referências visuais para orientar a geração. A disponibilidade depende do modelo selecionado. Aceitamos diversos formatos de imagem, incluindo JPG, PNG, WEBP e outros.
Quadro inicial (Vídeo): Define a imagem de abertura do seu vídeo.
Quadro final (Vídeo): Define a imagem final, influenciando a transição.
Referências de imagem (Imagem ou Vídeo): Forneça uma ou mais imagens para orientar o estilo e a aparência geral.
Arraste e solte itens diretamente das abas Explorar ou Histórico nos espaços de referência para um fluxo de trabalho mais rápido.
Gerar
Antes de gerar, um indicador de custo mostra o custo total da quantidade de arquivos que você escolheu criar. Quando estiver tudo pronto, clique em Gerar. Suas novas criações aparecerão na aba Histórico.
Histórico
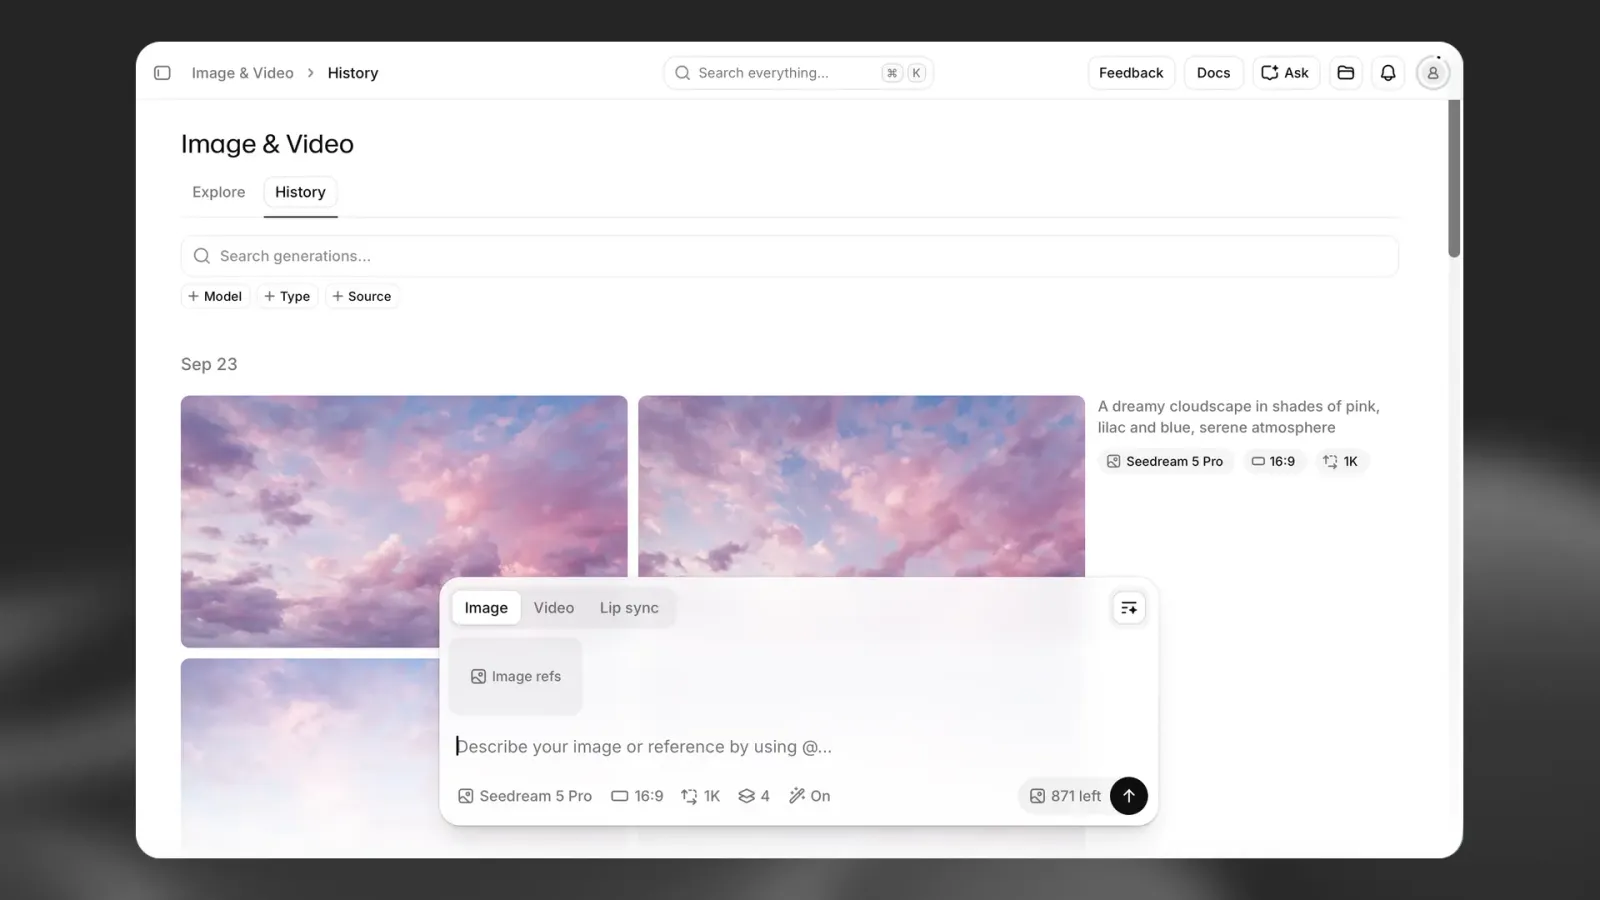
A aba Histórico fornece um registro cronológico de tudo o que você gerou e funciona como um espaço de trabalho para refinar criações anteriores.
Navegar: Veja todas as imagens e vídeos anteriores.
Inspecionar: Clique em qualquer arquivo para ver o prompt original, o modelo e as configurações usados para criá-lo.
Reutilizar: Arraste itens do Histórico de volta para a caixa de prompt para usá-los como referências em novas gerações.
Iterar: Clique em Recriar para executar o mesmo prompt e as mesmas configurações novamente e obter uma nova variação, ou ajuste as configurações para orientar a geração em uma nova direção.
Compartilhar: Clique em Compartilhar para gerar um link exclusivo do seu arquivo. Envie-o para colegas e colaboradores receberem feedback.
Exportar: Baixe seu arquivo separadamente ou clique em Editar no Studio para importá-lo diretamente para o ElevenCreative Studio.
Exportar
Quando tiver uma geração com a qual esteja satisfeito, use as ferramentas de aprimoramento integradas antes de exportar.
Aprimorando suas criações
Upscale: Use o Topaz Upscale para aumentar a resolução em até 4x, preservando detalhes nítidos.
LipSync: Aplique sincronização labial realista aos seus visuais:
- Omnihuman 1.5: Anime uma imagem estática com uma faixa de áudio
- Veed LipSync: Duble um vídeo existente com novo áudio
Exportando seus arquivos
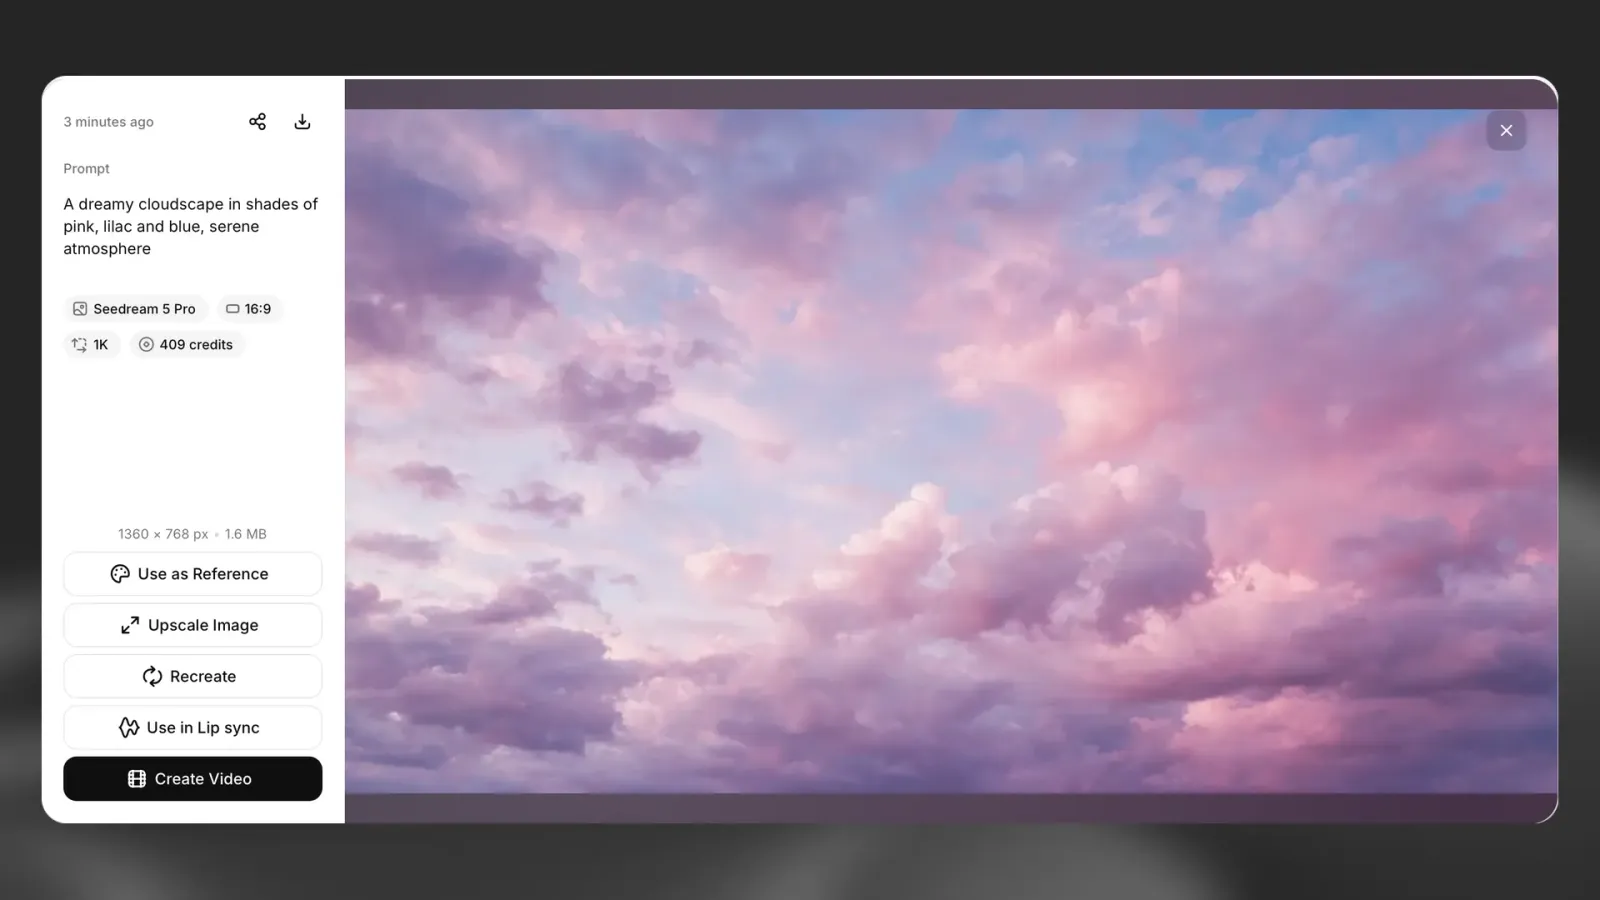
Exporte arquivos finalizados baixando-os localmente ou enviando-os diretamente para o ElevenCreative Studio.
Editar no Studio: Importe o arquivo diretamente para um projeto do ElevenCreative Studio.
Baixar: Salve o arquivo no seu computador.
Formatos de download compatíveis
Vídeo:
- MP4: codecs H.264, H.265. Qualidade de até 4K (com upscaling)
Imagem:
- PNG: saída sem perdas e em alta resolução
Modelos
Imagem e Vídeo oferece acesso a modelos especializados otimizados para diferentes casos de uso. Cada modelo oferece recursos únicos, desde iterações rápidas até qualidade pronta para produção.
Os modelos de pós-processamento exigem uma geração existente, mas você também pode enviar seu próprio arquivo de imagem ou vídeo.
Administradores de espaços de trabalho Enterprise podem controlar quais modelos de geração de imagens e vídeos estão disponíveis para membros do espaço de trabalho. Por padrão, todos os modelos ficam desativados para espaços de trabalho Enterprise e precisam ser ativados explicitamente pelos administradores. Saiba mais sobre Aprovações de modelos.
Para solicitações de API, os modelos da ByteDance ficam desativados por padrão e exigem aprovação explícita antes do uso. Clientes Enterprise podem entrar em contato com o suporte para solicitar acesso.
Modelos generativos de vídeo
Seedance 2.0
Um modelo de vídeo multimodal unificado com geração conjunta de áudio e vídeo, que oferece controle de nível profissional sobre atuação, iluminação, sombra e movimento de câmera para resultados ultrarrealistas e cinematográficos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem
- Referências de vídeo
- Referências de áudio
Recursos:
- Arquitetura multimodal unificada que gera áudio e vídeo sincronizados em uma única etapa
- Recursos líderes do setor de referência multimodal e edição, aceitando simultaneamente entradas de texto, imagem, áudio e vídeo
- Estabilidade de movimento excepcional com realismo de qualidade cinematográfica alinhado aos padrões do setor
- Controle criativo de nível profissional sobre atuação, iluminação, sombra e movimento de câmera
- Durações de geração flexíveis, de 4s a 15s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p, 1080p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas cinematográficas que exigem áudio e imagens sincronizados
- Conteúdo orientado por referências que exige fidelidade rigorosa a imagens, vídeos ou áudios de origem
- Produções profissionais que exigem controle detalhado sobre iluminação e trabalho de câmera
Custo: varia conforme as configurações e a duração selecionadas
Seedance 2.0 Fast
Uma variante mais rápida e de menor custo do Seedance 2.0, com as mesmas entradas de referência multimodal e saída limitada a 720p.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 9)
- Referências de vídeo (até 3, 15s no total)
- Referências de áudio (até 3, 15s no total)
Recursos:
- Mesmo tratamento de referências do Seedance 2.0, com limite combinado de 12 referências por geração
- Quadros e referências são mutuamente exclusivos: use um quadro inicial ou final, ou referências, não ambos
- Durações de geração flexíveis, de 4s a 15s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Iterar prompts do Seedance 2.0 antes de uma renderização em resolução máxima
- Clipes orientados por referências em que a saída de 720p é suficiente
Custo: varia conforme as configurações e a duração selecionadas
API: bytedance-seedance-v2-fast
O Seedance 2.0 Fast não está disponível nos Estados Unidos.
Seedance 2.0 Mini
A menor variante do Seedance 2.0: aproximadamente duas vezes mais rápida que o Seedance 2.0, por cerca da metade do custo, com as mesmas entradas e saída em 720p.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 9)
- Referências de vídeo (até 3, 15s no total)
- Referências de áudio (até 3, 15s no total)
Recursos:
- Mesmo tratamento de referências do Seedance 2.0, com limite combinado de 12 referências por geração
- Quadros e referências são mutuamente exclusivos: use um quadro inicial ou final, ou referências, não ambos
- Durações de geração flexíveis, de 4s a 15s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Rascunhos e prévias em alto volume
- Fluxos de trabalho sensíveis a custo que ainda precisam de entradas de áudio e referências
Custo: varia conforme as configurações e a duração selecionadas
API: bytedance-seedance-v2-mini
O Seedance 2.0 Mini não está disponível nos Estados Unidos.
Seedance 2.5
O sucessor do Seedance 2.0, com realismo mais nítido, até 50 referências combinadas de imagem, vídeo e áudio, e gerações de até 30 segundos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 30)
- Referências de vídeo (até 10, 30s no total)
- Referências de áudio (até 10, 30s no total)
Recursos:
- Sem limite combinado entre tipos de referência; referências apenas de áudio são aceitas sem imagem ou vídeo
- Quadros e referências são mutuamente exclusivos
- Durações de geração flexíveis, de 4s a 30s
- A proporção é definida pelo quadro inicial ou vídeo de referência quando um deles é fornecido
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Clipes longos que precisam manter consistência com muitas referências
- Cenas de diálogo e atuação guiadas por áudio de referência
Custo: varia conforme as configurações e a duração selecionadas
O Seedance 2.5 não oferece controle de seed.
Seedance 2.5 Video Edit
Edita um vídeo existente descrevendo as alterações. A duração e a proporção da saída seguem o vídeo de entrada.
Entradas de geração:
- Vídeo a editar (obrigatório, até 30s)
- Prompt de texto descrevendo as edições
- Referências de imagem (até 30)
- Referências adicionais de vídeo (até 10, 30s no total)
- Referências de áudio (até 10, 30s no total)
Recursos:
- Sem controle de duração: a saída corresponde à duração do vídeo de entrada
- A proporção é definida pelo vídeo de entrada
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p
Ideal para:
- Alterar roupas, objetos, iluminação ou cenário em filmagens existentes
- Transferência de estilo que preserva o movimento original
Custo: varia conforme as configurações e a duração selecionadas
Seedance 2.5 Video Extend
Continua um vídeo existente de onde ele termina, guiado por um prompt e referências opcionais.
Entradas de geração:
- Vídeo a estender (obrigatório, até 30s)
- Prompt de texto descrevendo a continuação
- Referências de imagem (até 30)
- Referências adicionais de vídeo (até 10, 30s no total)
- Referências de áudio (até 10, 30s no total)
Recursos:
- Duração da extensão de 4s a 30s
- A proporção é definida pelo vídeo de entrada
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p
Ideal para:
- Alongar uma tomada que termina cedo demais
- Encadear várias gerações em uma sequência mais longa
Custo: varia conforme as configurações e a duração selecionadas
Kling 3.0
Um modelo de vídeo avançado que funciona como um diretor de IA, mantendo alta consistência de personagens, itens e cenas em movimentos de câmera complexos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
Recursos:
- Preservação de alta fidelidade de personagens e cenas usando referências de imagem ou vídeo em vários ângulos
- Cogeração nativa de áudio e vídeo com sincronização labial multilíngue e som ambiente
- Durações de geração flexíveis, de 3s a 15s
- Gere até 4 variações simultaneamente
- Melhor processamento de texto, dinâmica de fluidos e interações físicas complexas
Opções de saída:
- Resoluções: apenas 1080p
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Narrativas centradas em personagens que exigem continuidade visual
- Comerciais e recursos visuais com necessidades específicas de renderização de texto
Custo: varia conforme as configurações e a duração selecionadas
Compatível com prompts negativos para controle detalhado. O som pode ser ativado ou desativado em cada geração.
O Kling 3.0 não está disponível nos Estados Unidos.
Kling O3
Um modelo de vídeo de alta consistência que funciona como um diretor de IA, preservando a identidade de personagens, itens e cenas em movimentos de câmera complexos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referência de vídeo
- Referência de imagem
Recursos:
- Mantém a identidade visual precisa de personagens e itens principais usando referências em vários ângulos
- Compatível com durações de geração contínuas, de 3s a 15s
- Gere até 4 variações por vez
- Modelagem precisa de interações entre elementos e coerência de movimento
- Compatibilidade nativa com áudio ativado ou desativado em cada geração
Opções de saída:
- Resoluções: apenas 1080p
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Narrativas centradas em personagens que exigem continuidade visual rigorosa
- Materiais profissionais de marketing e marca com renderização consistente de itens
Custo: varia conforme as configurações e a duração selecionadas
O Kling O3 não está disponível nos Estados Unidos.
Kling O3 Edit
Um modelo de edição de vídeo para vídeo orientado por linguagem natural, baseado na arquitetura O3, que permite transformações visuais complexas — como substituição de personagens e mudanças de ambiente — sem a necessidade de máscaras manuais ou ajustes quadro a quadro.
Entradas de geração:
- Vídeo de origem
- Referências de imagem (até 4 elementos/ângulos distintos)
- Descrição de texto (instruções em linguagem natural)
Recursos:
- Interpreta prompts conversacionais para substituir assuntos ou cenários, respeitando a estrutura de movimento original
- Mantém os ângulos de câmera, padrões de movimento e relações espaciais originais durante toda a edição
- Combina até 4 elementos no total (incluindo imagens frontais e de vários ângulos) para garantir consistência de personagens em alta fidelidade
- Opção de preservar o áudio original ou gerar saída silenciosa em cada geração
- Gere até 4 variações editadas por vez
Opções de saída:
- Resoluções: dependem do vídeo de origem
- Proporções: correspondem ao vídeo de origem
Ideal para:
- Substituição de personagens em alta fidelidade em filmagens existentes, mantendo os movimentos originais
- Transformações completas do ambiente da cena (por exemplo, mudar uma cidade diurna para uma paisagem noturna futurista)
- Aplicar transferências de estilo que exigem fidelidade rigorosa à dinâmica de câmera existente
Custo: varia conforme a duração do vídeo e as configurações selecionadas
O Kling O3 Edit não está disponível nos Estados Unidos.
Google Veo 3.1
Um modelo de nível profissional para geração de vídeos cinematográficos de alta qualidade.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem
Recursos:
- Excelente qualidade e controle criativo com prompts negativos
- Áudio totalmente integrado e sincronizado
- Diálogos, sincronização labial e efeitos sonoros realistas
- Durações fixas: 4s, 6s e 8s
- Criação em lote com até 4 gerações por vez
- Controle de som dedicado
Opções de saída:
- Resoluções: 720p, 1080p
- Proporções: 16:9, 9:16
Ideal para:
- Geração de vídeos cinematográficos de alta qualidade com controle criativo total
Custo: varia conforme as configurações e a duração selecionadas
API: veo-3.1-generate-001
Ativar ou desativar o som altera os créditos de geração.
Google Veo 3.1 Fast
Um modelo de alta velocidade otimizado para prévias e gerações rápidas, que oferece imagens mais nítidas com menor latência.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
Recursos:
- Controle criativo avançado com prompts negativos e controle de som dedicado
- Durações fixas: 4s, 6s e 8s
- Criação em lote com até 4 gerações por vez
- Modela com precisão a física do mundo real para movimentos e interações realistas
Opções de saída:
- Resoluções: 720p, 1080p
- Proporções: 16:9, 9:16
Ideal para:
- Iteração rápida e testes visuais A/B
- Criação ágil de conteúdo para redes sociais
Custo: varia conforme as configurações e a duração selecionadas
Google Veo 3.1 Lite
Uma variante do Veo 3.1 econômica e de alta velocidade, otimizada para geração rápida com menor uso de processamento.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
Recursos:
- Controle criativo detalhado com prompts negativos e controle de som dedicado
- Durações fixas: 4s, 6s e 8s
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 720p
- Proporções: 16:9, 9:16
Ideal para:
- Criação de conteúdo em alto volume, quando velocidade e eficiência de custo são prioridade
- Exploração rápida de conceitos e prévias
Custo: varia conforme as configurações e a duração selecionadas
Gemini Omni Flash 1.1
O modelo de vídeo do Google com compreensão de física, áudio nativo, saída de até 4K e geração tanto por interpolação de quadros quanto guiada por referências.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 10)
- Referências de vídeo (até 3, cada uma com até 10s)
Recursos:
- Quadros e referências são mutuamente exclusivos: interpole entre quadros ou use referências como guia
- Durações fixas de 3s a 10s; a duração segue o vídeo de referência quando um é anexado
- Boa renderização de textos e rótulos curtos na tela
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 360p, 720p, 1080p, 4K
- Proporções: 16:9, 9:16
Ideal para:
- Vídeos explicativos e tipografia cinética com texto legível
- Movimento baseado na física, com assuntos consistentes entre referências
Custo: varia conforme as configurações e a duração selecionadas
Gemini Omni Flash 1.1 Extend
Continua um vídeo existente de onde ele termina usando o Gemini Omni Flash 1.1, para uma duração combinada de até 40 segundos.
Entradas de geração:
- Vídeo a estender (obrigatório, até 30s)
- Prompt de texto descrevendo a continuação
Recursos:
- Duração da extensão de 3s a 10s
- A proporção segue o vídeo de entrada
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 360p, 720p, 1080p, 4K
Ideal para:
- Alongar gerações do Gemini Omni Flash sem um corte visível
- Criar sequências mais longas do que uma única geração permite
Custo: varia conforme as configurações e a duração selecionadas
Gemini Omni Flash
O primeiro modelo de vídeo Gemini Omni: movimento com compreensão de física, áudio nativo e a melhor renderização de texto na tela entre os modelos de vídeo disponíveis, em 720p.
Entradas de geração:
- Texto para vídeo
- Referências de imagem (até 8)
- Referência de vídeo (1, até 10s)
Recursos:
- Durações fixas de 3s a 10s; a duração segue o vídeo de referência quando um é anexado
- Sem quadro inicial ou final; use referências de imagem para fixar um assunto
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 720p
- Proporções: 16:9, 9:16
Ideal para:
- Legendas curtas, títulos e vídeos explicativos com rótulos
- Consistência entre várias imagens em 720p
Custo: varia conforme as configurações e a duração selecionadas
Seedance 1.5 Pro
Um modelo especializado aprimorado para criar sequências dinâmicas e de alta fidelidade, com maior estabilidade temporal e controle preciso das transições entre quadros-chave.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
Recursos:
- Conecta perfeitamente os quadros inicial e final para criar sequências coerentes com vários takes
- Modelagem de alta fidelidade de ações complexas e consistência ambiental
- Compatível com durações fixas de geração de 4 s a 12 s
- Gere até 4 variações por vez
- Compatível nativamente com áudio ativado ou desativado em cada geração
Opções de saída:
- Resoluções: 420p, 720p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas e cenas de ação que exigem física estável entre referências visuais específicas
- Transições cinematográficas e recursos de vídeo profissionais com requisitos rigorosos de início e fim
Custo: Varia conforme as configurações e a duração selecionadas
O Seedance 1.5 Pro foi descontinuado. A ByteDance desativará o modelo em 11 de novembro de 2026, e ele não é mais oferecido para novas gerações. Use um modelo Seedance 2.0. O Seedance 1.5 Pro não está disponível nos Estados Unidos.
FLUX 3
Modelo de vídeo da Black Forest Labs com movimento natural, cenas com vários takes, áudio gerado e extensão de vídeo.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Vídeo para estender (1, até 15 s)
Recursos:
- A extensão de vídeo é mutuamente exclusiva com os quadros inicial e final
- Durações flexíveis de geração de 5 s a 20 s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 720p, 1080p
- Proporções: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Cenas com vários takes a partir de um único prompt
- Estender um clipe existente com movimento e áudio correspondentes
Custo: Varia conforme as configurações e a duração selecionadas
FLUX 3 Edit
Edita um vídeo existente a partir de um prompt de texto. A duração e o enquadramento da saída seguem o vídeo de origem, de até 15 s.
Entradas de geração:
- Vídeo para editar (obrigatório, até 15 s)
- Prompt de texto descrevendo as edições
Opções de saída:
- A resolução e a proporção correspondem ao vídeo de origem
Ideal para:
- Alterações baseadas em prompt em filmagens existentes
Custo: Varia conforme as configurações e a duração selecionadas
MiniMax H3
Modelo de vídeo principal da MiniMax com referências multimodais, áudio gerado e saída de até 4K.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 9)
- Referências de vídeo (até 3, cada uma de 2 s a 15 s, 15 s no total)
- Referências de áudio (até 3, cada uma de 2 s a 15 s, 15 s no total)
Recursos:
- Limite combinado de 12 referências por geração; as referências de áudio exigem pelo menos uma referência de imagem ou vídeo
- Quadros e referências são mutuamente exclusivos
- Durações flexíveis de geração de 5 s a 15 s
- Gera áudio sincronizado
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 768p, 2K, 4K (2K e 4K são ampliadas a partir de 768p)
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Cenas guiadas por referências que precisam de entrega em alta resolução
- Clipes de diálogo guiados por áudio de referência
Custo: Varia conforme as configurações e a duração selecionadas
O MiniMax H3 não está disponível nos Estados Unidos.
MiniMax H3 Max
Uma variante quase instantânea do MiniMax H3, com as mesmas entradas e estética marcante, renderizada nativamente em até 768p.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 9)
- Referências de vídeo (até 3, cada uma de 2 s a 15 s, 15 s no total)
- Referências de áudio (até 3, cada uma de 2 s a 15 s, 15 s no total)
Recursos:
- Limite combinado de 12 referências por geração; as referências de áudio exigem pelo menos uma referência de imagem ou vídeo
- Quadros e referências são mutuamente exclusivos
- Durações flexíveis de geração de 5 s a 15 s
- Gera áudio sincronizado
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 768p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Iteração rápida em prompts e referências
- Pré-visualizações antes de renderizar com o MiniMax H3
Custo: Varia conforme as configurações e a duração selecionadas
O MiniMax H3 Max não está disponível nos Estados Unidos.
MiniMax H3 Max Recast
Substitui pessoas em um vídeo de origem usando de 1 a 4 fotos. A duração segue a do material de origem, de até 30 s, e o áudio original é mantido.
Entradas de geração:
- Vídeo de origem (até 30 s)
- Fotos das pessoas a serem substituídas (de 1 a 4)
Recursos:
- A duração da saída segue o vídeo de origem
- Mantém o áudio de origem
Opções de saída:
- Resoluções: até 1080p
- A proporção segue o vídeo de origem
Ideal para:
- Substituir pessoas em filmagens existentes por pessoas de fotos de referência
Custo: Varia conforme as configurações e a duração selecionadas
Kling O1
Um modelo de vídeo de raciocínio de última geração, desenvolvido para oferecer aderência superior ao prompt e simulação complexa do mundo físico, usando processamento lógico avançado para interpretar e executar instruções detalhadas.
Entradas de geração:
- Texto para vídeo (descrição)
- Quadro inicial e quadro final
- Referência de vídeo
- Referência de imagem
Recursos:
- Capacidade excepcional de interpretar prompts com várias camadas e executar ações cronológicas complexas
- Usa imagens e vídeos como âncoras visuais para manter alta consistência de personagens e cenas
- Modelagem superior de interações físicas, causa e efeito e dinâmica de fluidos
- Compatível com geração de alta qualidade para clipes de 5 s e 10 s
- Gere até 4 variações por vez
Opções de saída:
- Resoluções: dependem da entrada
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Conceitos criativos muito específicos que exigem aderência precisa a descrições longas e detalhadas
- Narrativas profissionais em que o realismo físico e a consistência entre várias referências são essenciais
Custo: Varia conforme as configurações e a duração selecionadas
O Kling O1 não está disponível nos Estados Unidos.
Kling O1 Edit
Um modelo de edição de vídeo para vídeo orientado por linguagem natural, que permite transformações visuais complexas — como substituição de personagens e troca de ambientes — sem mascaramento manual ou ajustes quadro a quadro.
Entradas de geração:
- Vídeo de origem
- Referências de imagem (até 4 elementos/ângulos distintos)
- Descrição de texto (instruções em linguagem natural)
Recursos:
- Interpreta prompts conversacionais para substituir pessoas ou cenários, respeitando a estrutura de movimento original
- Mantém os ângulos de câmera, os padrões de movimento e as relações espaciais originais durante toda a edição
- Combina até 4 elementos no total, incluindo imagens frontais e de vários ângulos, para garantir alta consistência dos personagens
- Opção de preservar o áudio original ou gerar saída silenciosa em cada geração
- Gere até 4 variações editadas por vez
Opções de saída:
- Resoluções: dependem do vídeo de origem
- Proporções: correspondem ao vídeo de origem
Ideal para:
- Substituição de personagens em alta fidelidade em filmagens existentes, mantendo os movimentos originais
- Transformações completas do ambiente da cena (por exemplo, transformar uma cidade diurna em uma paisagem noturna futurista)
- Aplicar transferências de estilo que exigem aderência rigorosa à dinâmica de câmera existente
Custo: Varia conforme a duração do vídeo e as configurações selecionadas
O Kling O1 Edit não está disponível nos Estados Unidos.
Kling 2.6 Motion Control
Um modelo especializado para transferência precisa de movimento, que permite animar uma imagem de personagem com um vídeo de referência para reproduzir movimentos, gestos e ângulos de câmera específicos.
Entradas de geração:
- Imagem de personagem (origem)
- Vídeo de movimento (referência)
- Descrição de texto (opcional)
Recursos:
- Escolha “Match Video” para reprodução exata de movimento ou “Match Image” para adicionar novos movimentos criativos a um personagem
- Compatível com até 30 s no modo Match Video e 10 s no modo Match Image
- Mapeamento de alta fidelidade do movimento humano de filmagens de referência para um personagem estático
- Compatível nativamente com ativação ou desativação de áudio em cada geração
- Gere até 4 variações por vez
Opções de saída:
- Resoluções: dependem da origem
- Proporções: dependem da origem
Ideal para:
- Reproduzir coreografias complexas ou movimentos específicos em um personagem personalizado
- Animação de personagens em formato longo que exige alta fidelidade de movimento
- Conteúdo para redes sociais guiado por movimentos de vídeo em alta
Custo: Varia conforme as configurações e a duração selecionadas
O Kling 2.6 Motion Control não está disponível nos Estados Unidos.
Kling 3.0 Motion Control
Um modelo especializado para transferência precisa de movimento, desenvolvido com a arquitetura Kling 3.0, que permite animar uma imagem de personagem com um vídeo de referência para reproduzir movimentos, gestos e ângulos de câmera específicos com maior fidelidade.
Entradas de geração:
- Imagem de personagem (origem)
- Vídeo de movimento (referência)
- Descrição de texto (opcional)
Recursos:
- Escolha “Match Video” para reprodução exata de movimento ou “Match Image” para adicionar novos movimentos criativos a um personagem
- Compatível com até 30 s no modo Match Video e 10 s no modo Match Image
- Mapeamento de alta fidelidade do movimento humano de filmagens de referência para um personagem estático
- Compatível nativamente com ativação ou desativação de áudio em cada geração
- Gere até 4 variações por vez
Opções de saída:
- Resoluções: dependem da origem
- Proporções: dependem da origem
Ideal para:
- Reproduzir coreografias complexas ou movimentos específicos em um personagem personalizado
- Animação de personagens em formato longo que exige alta fidelidade de movimento
- Conteúdo para redes sociais guiado por movimentos de vídeo em alta
Custo: Varia conforme as configurações e a duração selecionadas
O Kling 3.0 Motion Control não está disponível nos Estados Unidos.
Kling 2.6
Um modelo generativo otimizado, desenvolvido para maior fidelidade de movimento e transições mais suaves, equilibrando iteração em alta velocidade e saída visual com qualidade de produção.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Dinâmica de movimento aprimorada: melhorias significativas na fluidez do movimento e em interações físicas realistas
- Controle de som flexível: suporte nativo para ativar ou desativar o áudio em cada geração
- Criação em lote: gere até 4 variações simultaneamente
- Refinamento detalhado: controle criativo avançado com suporte a prompt negativo
- Durações fixas: compatível com gerações de 5 s e 10 s
Opções de saída:
- Resoluções: dependem da entrada
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Clipes de muita ação que exigem movimentos fluidos dos personagens
- Conteúdo profissional para redes sociais com forte aderência ao prompt
Custo: Varia conforme as configurações e a duração selecionadas
O Kling 2.6 não está disponível nos Estados Unidos.
Kling 2.5
Um modelo equilibrado e versátil para geração de vídeos Full HD de alta qualidade.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
Recursos:
- Excelente para simular movimentos complexos e física realista
- Modela com precisão a dinâmica de fluidos e expressões
- Durações fixas: 5 s e 10 s
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1080p
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Simulações de física realista e movimentos complexos
Custo: Varia conforme as configurações e a duração selecionadas
O quadro final não é compatível no momento. Não é possível fornecer referências de imagem. O controle de som não está disponível.
O Kling 2.5 não está disponível nos Estados Unidos.
Runway Gen-4.5
Qualidade de movimento, aderência ao prompt e fidelidade visual de última geração para vídeos cinematográficos e altamente realistas.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Qualidade de movimento excepcional, com realismo e simulação de física líderes do setor
- Aderência superior ao prompt para controle criativo preciso sobre cenas complexas
- Alta fidelidade visual para resultados de nível cinematográfico
- Gere até 4 variações simultaneamente
Opções de saída:
- Resoluções: 720p
- Proporções: 16:9, 9:16
Ideal para:
- Conteúdo cinematográfico que exige a mais alta qualidade de movimento e realismo
- Produções profissionais que exigem aderência precisa ao prompt
- Narrativas visuais de alta fidelidade
Custo: Varia conforme as configurações e a duração selecionadas
Runway Gen-4 Turbo
Um modelo de vídeo avançado desenvolvido para iteração rápida e criação econômica, capaz de produzir vídeos de alta qualidade.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Otimizado para geração ultrarrápida, entregando resultados até quatro vezes mais rápido que as iterações anteriores
- Permite direcionar com precisão os movimentos dos personagens, os ângulos de câmera e as composições de cena
- Excelente para manter coerência visual e estabilidade em cenas dinâmicas
- Compatível com durações de geração de 2 s a 10 s
- Gere até 4 variações simultaneamente
Opções de saída:
- Resoluções: 720p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Prototipagem rápida e experimentação criativa que exigem feedback quase instantâneo
- Projetos profissionais que precisam de entregas rápidas de recursos de marketing em alta resolução
- Conteúdo cinematográfico com requisitos específicos de movimento de câmera
Custo: Varia conforme as configurações e a duração selecionadas
Runway Gen-4 Aleph
Um modelo de vídeo de última geração com contexto, desenvolvido para geração visual multitarefa, capaz de realizar edições complexas preservando a estrutura subjacente das filmagens de origem.
Entradas de geração:
- Vídeo de origem
- Imagem de referência
- Descrição de texto
Recursos:
- Adicione, remova ou transforme objetos e pessoas em uma cena sem interrupções, com iluminação, sombras e perspectiva naturais
- Altere locais, estações e horários do dia (por exemplo, transformando filmagens nubladas em um pôr do sol dramático) com atualizações realistas de temperatura de cor
- Modifique a idade e a aparência de atores ou altere as texturas de roupas e pessoas usando prompts simples em linguagem natural
- Aplique o movimento específico e o percurso de câmera de um vídeo de referência a uma imagem estática para controle preciso da animação
- Gere ângulos de câmera completamente novos, como planos reversos ou ângulos baixos, a partir de uma única sequência de vídeo existente
- Inclui chroma key preciso (isolamento com detecção de bordas), geração do próximo take para continuidade da história e transferência de estilo estético
- Gere até 4 variações simultaneamente
Opções de saída:
- Resoluções: 720p
- Proporções: automática
Ideal para:
- Tarefas profissionais de efeitos visuais, como rejuvenescimento digital, nova iluminação e remoção de objetos
- Prototipagem cinematográfica rápida e geração de cobertura alternativa de câmera a partir de um único take
- Conteúdo criativo de marketing que exige transformações ambientais ou estilísticas drásticas
Custo: Varia conforme as configurações e a duração selecionadas
Runway Aleph 2.0
Modelo de edição de vídeo da Runway: transforma um vídeo existente para um visual de destino, preservando o movimento e a consistência.
Entradas:
- Vídeo de origem (obrigatório, de 2 s a 30 s)
- Imagem do visual de destino (obrigatória)
- Prompt de texto descrevendo as edições
Recursos:
- A duração e o enquadramento da saída seguem o vídeo de origem
- Transferência de estilo guiada pela imagem do visual de destino
- Criação em lote com até 4 gerações por vez
Ideal para:
- Alterar a iluminação, o estilo ou o cenário de filmagens existentes
- Aplicar o visual de uma imagem de referência a um clipe inteiro
Custo: Varia conforme as configurações e a duração selecionadas
Runway Act-Two
Um modelo especializado de transferência de performance que anima personagens mapeando o movimento, a fala e as expressões faciais de um vídeo de referência de performance para uma imagem ou vídeo de referência do personagem.
Entradas de geração:
- Performance de referência (vídeo)
- Entrada do personagem (imagem ou vídeo)
Recursos:
- Transfere expressões faciais sutis, sincronização labial e áudio sincronizado diretamente de um ator de origem para qualquer personagem
- Adiciona automaticamente movimento secundário e leves tremores de câmera a imagens estáticas de personagens para um visual mais natural
- Alternância precisa para ativar ou desativar movimentos do corpo e das mãos ao usar uma imagem de personagem
- Configurações ajustáveis para equilibrar uma performance emocional intensa e a consistência visual do personagem
- Possibilidade de alterar a voz do personagem após a geração, mantendo o alinhamento perfeito com a performance de referência
Opções de saída:
- Resoluções: 720p
- Proporções: Automático
Ideal para:
- Dar vida a retratos estáticos de personagens com movimento e fala humanos realistas
- Animar personagens não humanos ou avatares estilizados com expressões de alta fidelidade
- Produzir rapidamente conteúdo de pessoas falando para a câmera com gestos corporais integrados
Custo: Varia conforme as configurações e a duração selecionadas
Seedance 1 Pro
Um modelo especializado para criar sequências dinâmicas com vários planos, muito movimento e ação.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
Recursos:
- Física altamente estável e transições fluidas entre planos
- Durações fixas: 3s, 4s, 5s, 6s, 7s, 8s, 9s, 10s, 11s e 12s
- Criação em lote com até 4 gerações por vez
- Máxima flexibilidade criativa com várias opções de proporção
Opções de saída:
- Resoluções: 480p, 720p, 1080p
- Proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas e cenas de ação que exigem física estável
Custo: Varia conforme as configurações e a duração selecionadas
A proporção e a resolução não afetam os créditos de geração, mas a duração afeta.
Seedance 1 Pro não está disponível nos Estados Unidos.
LTX Audio-to-Video
Um modelo fundamental baseado em DiT, projetado para gerar vídeo e áudio sincronizados em uma única etapa, garantindo fala coerente e movimento realista.
Entradas de geração:
- Texto para vídeo
- Imagem para vídeo
- Áudio para vídeo
- Profundidade para vídeo
Recursos:
- Gera diálogo, movimento labial e áudio ambiente simultaneamente para um alinhamento perfeito sem ferramentas externas
- Cenas dinâmicas com movimento estável, identidade consistente e forte coerência entre quadros
- Suporta geração sincronizada de alta fidelidade por até 20 segundos
- Direção criativa avançada com suporte detalhado a prompts negativos
- Gere até 4 variações por vez
Opções de saída:
- Resoluções: 720p, 1080p
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Fala coerente e performances expressivas de personagens
- Conteúdo narrativo que exige áudio ambiente integrado e timing consistente
- Cenas dinâmicas com lógica complexa de movimento adaptada à câmera
Custo: Varia conforme as configurações e a duração selecionadas
LTX 2 Pro
Um modelo generativo de alta fidelidade otimizado para o máximo de detalhes visuais e estabilidade estrutural, capaz de produzir resultados em 4K prontos para produção com movimento fluido.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Prioriza qualidade visual e consistência em vez de velocidade, garantindo resultados estáveis em sequências mais longas
- Suporta 25 FPS e 50 FPS para movimentos excepcionalmente fluidos e profissionais
- Geração audiovisual integrada com uma opção para ativar ou desativar o som
- Desenvolvido para lidar com saídas nativas em 1080p, 2k e 4k sem perda de detalhes
- Gere até 4 variações por vez
Opções de saída:
- Resoluções: 1080p, 2k, 4k
- Taxas de quadros: 25 FPS, 50 FPS
- Proporção: 16:9 (padrão)
- Durações: 6s, 8s, 10s
Ideal para:
- Produção cinematográfica em alta resolução que exige clareza em 4K
- Conteúdo profissional que requer movimento fluido em 50 FPS
- Sequências detalhadas em que estabilidade visual e integridade estrutural são essenciais
Custo: Varia conforme as configurações e a duração selecionadas
LTX 2 Retake
Uma ferramenta de direção precisa com IA que permite redirecionar seletivamente diálogos, emoções e ações em planos existentes sem quebrar a continuidade ou regenerar toda a sequência.
Entradas de geração:
- Vídeo de origem
- Descrição de texto
Recursos:
- Modifique segmentos específicos mantendo uma forte preservação de contexto dos quadros ao redor
- Reformule falas mantendo consistentes a voz, a performance e o ambiente do personagem
- Vários modos de edição: selecione entre “Áudio e vídeo”, “Somente áudio” ou “Somente vídeo” para isolar e regenerar elementos específicos do plano
- O novo conteúdo herda naturalmente o movimento, a iluminação e o tom originais para transições fluidas
- Experimente instantaneamente reações alternativas dos personagens, momentos emocionais ou movimentos de câmera em um único plano
- Gere até 4 variações simultaneamente para comparação criativa lado a lado
Opções de saída:
- Proporções: somente 16:9
Ideal para:
- Ajustar roteiros e refinar diálogos sem a necessidade de refilmagens ou novas gravações
- Corrigir momentos emocionais ou problemas de ritmo na pós-produção
- Testar várias mensagens de marca e chamadas para ação em uma única peça de marketing
Custo: Varia conforme as configurações e a duração selecionadas
LTX 2 Fast
Um modelo generativo otimizado para velocidade, criado para ciclos curtos de feedback e criação de conteúdo em alta velocidade, com visuais em alta resolução e tempos de renderização significativamente menores.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Projetado para velocidade e iteração rápida, permitindo experimentação visual ágil e prévias quase instantâneas
- Suporta saídas nativas em 1080p, 2k e 4k com menor demanda computacional que o modelo Pro
- Recursos para 25 FPS e 50 FPS, garantindo movimento fluido em alta velocidade
- Permite a geração rápida de conteúdo audiovisual sincronizado com duração de até 20 segundos
- Suporte nativo para ativar ou desativar o áudio em cada geração
- Gere até 4 variações simultaneamente
Opções de saída:
- Resoluções: 1080p, 2k, 4k
- Taxas de quadros: 25 FPS, 50 FPS
- Proporção: 16:9 (padrão)
- Durações: 6s, 8s, 10s, 12s, 14s, 16s, 18s, 20s
Ideal para:
- Prototipagem rápida e exploração criativa em que a velocidade é priorizada em relação ao máximo de detalhes
- Conteúdo de alto volume para redes sociais que exige entregas rápidas
- Testes A/B de diferentes conceitos visuais e estilos de movimento
Custo: Varia conforme as configurações e a duração selecionadas
Wan 3.0
Um modelo de vídeo cinematográfico com referências de imagem, vídeo e áudio, áudio gerado e gerações de até 30 segundos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 10)
- Referências de vídeo (até 5, 15s no total)
- Referências de áudio (até 5, 15s no total)
Recursos:
- Quadros e referências são mutuamente exclusivos
- Durações fixas: 5s, 10s, 15s, 20s e 30s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Aprimoramento de prompt opcional
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p, 1080p
- Proporções: Automático, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Planos cinematográficos mais longos com forte aderência ao prompt
- Cenas orientadas por referências com áudio
Custo: Varia conforme as configurações e a duração selecionadas
Wan 3.0 não está disponível nos Estados Unidos.
Wan 3.0 Prime
Uma variante mais rápida do Wan 3.0 com as mesmas entradas e opções de saída, adequada para a fase de ideação.
Entradas de geração:
- Texto para vídeo
- Quadro inicial
- Quadro final
- Referências de imagem (até 10)
- Referências de vídeo (até 5, 15s no total)
- Referências de áudio (até 5, 15s no total)
Recursos:
- Cerca de metade do tempo de geração do Wan 3.0
- Durações fixas: 5s, 10s, 15s, 20s e 30s
- Controle nativo de som, com áudio ativado ou desativado em cada geração
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p, 1080p
- Proporções: Automático, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Explorar ideias antes de uma renderização final no Wan 3.0
- Fluxos de trabalho sensíveis ao prazo de entrega
Custo: Varia conforme as configurações e a duração selecionadas
Wan 3.0 Prime não está disponível nos Estados Unidos.
Wan 2.6
Uma plataforma de vídeo cinematográfico de última geração que utiliza uma arquitetura multimodal unificada para oferecer conteúdo em 1080p pronto para produção, com sincronização nativa de áudio e sequenciamento inteligente de vários planos.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
- Referência de vídeo (vídeo para vídeo)
- Referência de áudio (áudio de fundo ou diálogo opcional)
Recursos:
- Sistema multimodal unificado: processa texto, imagens, vídeo e áudio em uma única estrutura integrada para garantir qualidade de saída consistente
- Sincronização nativa de áudio: gera e alinha automaticamente diálogos, narração e efeitos sonoros ambientais com os movimentos em tela
- Sequenciamento inteligente de vários planos: organiza automaticamente sequências de vídeo conectadas em arcos narrativos coerentes, mantendo a consistência dos personagens
- Durações estendidas: oferece geração estável e de alta qualidade em durações fixas de 5s, 10s e 15s
- Controle criativo avançado: oferece suporte a prompts negativos para gerenciamento detalhado e criação em lote de até 4 variações
Opções de saída:
- Resoluções: 720p, 1080p
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas profissionais e sequências cinematográficas complexas com vários planos
- Anúncios para redes sociais e conteúdo de marketing que exigem áudio integrado e de alta fidelidade
- Conteúdo orientado por personagens que exige rigorosa consistência visual e de movimento por meio de referências de vídeo
Custo: Varia conforme as configurações e a duração selecionadas
Wan 2.6 não está disponível nos Estados Unidos.
Wan 2.5 Video
Um modelo versátil que oferece movimento cinematográfico e alta fidelidade ao prompt a partir de texto ou de uma imagem inicial.
Entradas de geração:
- Texto para vídeo
- Quadro inicial (imagem para vídeo)
Recursos:
- Controle criativo detalhado com prompts negativos e controle de som dedicado
- Durações fixas: 5s e 10s
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 480p, 720p, 1080p
- Proporções: 16:9, 1:1, 9:16
Ideal para:
- Conteúdo cinematográfico com forte aderência ao prompt
Custo: Varia conforme as configurações e a duração selecionadas
O custo de geração varia conforme as configurações selecionadas.
Wan 2.5 Video não está disponível nos Estados Unidos.
Modelos generativos de imagem
GPT Image 2.5 Sunburst
Modelo de imagem da OpenAI pronto para produção, voltado a resultados altamente detalhados e edição precisa.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 10)
Recursos:
- Cinco níveis de qualidade, de Baixa a Máxima
- Resolução personalizada de até 3840px por lado, em proporções de até 3:1
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K, 2K, 4K ou personalizada
- Proporções: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideal para:
- Recursos finais em que detalhes e fidelidade são mais importantes
- Edições precisas em imagens existentes
Custo: Varia conforme as configurações e o número de variações selecionados
GPT Image 2.5 Flare
Uma variante rápida do GPT Image 2.5 com os mesmos controles do Sunburst, ajustada para geração cotidiana em alto volume.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 10)
Recursos:
- Cinco níveis de qualidade, de Baixa a Máxima
- Resolução personalizada de até 3840px por lado, em proporções de até 3:1
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K, 2K, 4K ou personalizada
- Proporções: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideal para:
- Geração de imagens em alto volume
- Iterações rápidas que ainda exigem 4K e tamanhos personalizados
Custo: Varia conforme as configurações e o número de variações selecionados
API: gpt-image-2.5-flare
GPT Image 2
Um modelo avançado de IA criado para geração precisa de imagens, com renderização de texto aprimorada e recursos de saída em alta resolução.
Recursos:
- Controle preciso de texto para criar imagens com tipografia e clareza exatas
- Saída PNG em alta resolução adequada para uso profissional e comercial
- Oferece suporte a várias referências de imagem para orientar o estilo e a composição
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 3:2, 1:1, 2:3
- Opções de qualidade: baixa, média, alta
Ideal para:
- Visuais de marketing e recursos de design que exigem posicionamento preciso de texto
- Conteúdo profissional com requisitos de alta resolução
- Projetos criativos que precisam de controle preciso de imagens baseadas em texto
Custo: Varia conforme as configurações e o número de variações selecionados
API: gpt-image-2
Nano Banana 2.1
Um modelo de imagem com saída nativa em 4K e até 14 referências de imagem.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 14)
Opções de saída:
- Resoluções: 4K
- Proporções: de 8:1 a 1:8 e automático
Ideal para:
- Imagens orientadas por referências que precisam de 4K nativo
Custo: Varia conforme as configurações e o número de variações selecionados
Nano Banana 2
Um modelo avançado de geração de imagens com IA que combina qualidade pronta para produção e processamento ultrarrápido, com conhecimento de mundo e consistência de assunto aprimorados.
Recursos:
- Saída em resolução 4K nativa, sem upscaling, para detalhes cristalinos
- Geração de imagens ultrarrápida em apenas 1 a 2 segundos
- Aderência superior ao prompt por meio de raciocínio avançado e acompanhamento de instruções
- Renderização nítida e precisa de texto em vários idiomas para mockups, sinalizações e infográficos
- Estilo consistente para vários assuntos que preserva a identidade entre diversos personagens e objetos
- Conhecimento de mundo aprimorado para geração de cenas mais precisa
- Oferece suporte a várias referências de imagem para orientar a geração
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Resoluções: até 4K
Ideal para:
- Fluxos de trabalho criativos rápidos que exigem iteração em tempo real
- Conteúdo de marca e narrativas com identidade consistente dos personagens
- Visuais profissionais com texto e tipografia precisos
Custo: Varia conforme as configurações e o número de variações selecionados
Nano Banana 2 Lite
Uma variante rápida e de baixo custo do Nano Banana 2 para geração e edição ágeis em 1K.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 14)
Recursos:
- Saída fixa em 1K para manter velocidade e custo consistentes
- Mesma capacidade de 14 referências de imagem do Nano Banana 2
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K
- Proporções: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Iteração rápida e rascunhos
- Edições em massa em que 1K é suficiente
Custo: Varia conforme as configurações e o número de variações selecionados
Krea 2 Medium
Um modelo versátil de geração de imagens da Krea AI, pronto para produção, que equilibra qualidade e velocidade para uma ampla variedade de fluxos de trabalho criativos.
Recursos:
- Geração de imagens de alta fidelidade com forte aderência ao prompt
- Oferece suporte a várias referências de imagem para orientar a geração
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Criação de conteúdo profissional que exige qualidade consistente
- Iteração rápida em diversos conceitos criativos
Custo: Varia conforme as configurações e o número de variações selecionados
Krea 2 Large
Modelo principal de geração de imagens da Krea AI, que oferece máxima fidelidade visual e controle criativo avançado para fluxos de produção profissionais.
Recursos:
- Detalhamento e realismo excepcionais para resultados de nível profissional
- Controle de estilo avançado com suporte a várias imagens de referência
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Produção comercial e editorial de imagens de alto padrão
- Composições criativas complexas que exigem máxima fidelidade
Custo: Varia conforme as configurações selecionadas e o número de variações
Recraft V4.1
Um modelo de texto para imagem focado em design, com ótimo controle de prompt e composição limpa.
Entradas de geração:
- Texto para imagem
Recursos:
- A saída em 2K usa a variante de modelo Pro
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K, 2K
- Proporções: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideal para:
- Elementos gráficos, ícones e pôsteres orientados por layout
- Composições limpas criadas apenas a partir de texto
Custo: Varia conforme as configurações selecionadas e o número de variações
Recraft V4.1 Flash
Um modelo rápido de texto para imagem focado em design.
Entradas de geração:
- Texto para imagem
Opções de saída:
- Proporções: 16 proporções
Ideal para:
- Elementos gráficos orientados por layout criados apenas a partir de texto
Custo: Varia conforme as configurações selecionadas e o número de variações
Recraft V4
Um modelo de imagem focado em design que pode reproduzir o estilo de imagens de referência.
Entradas de geração:
- Texto para imagem
- Referências de estilo (até 10)
Recursos:
- Controle de correspondência de estilo: Preciso segue de perto o estilo de referência, Flexível reproduz a aparência geral
- A saída em 2K usa a variante de modelo Pro
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K, 2K
- Proporções: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideal para:
- Elementos gráficos consistentes com a marca a partir de um conjunto de referências de estilo
- Trabalhos de ilustração e design
Custo: Varia conforme as configurações selecionadas e o número de variações
Seedream 5 Lite
Um modelo de imagem leve e de geração rápida da ByteDance, que oferece resultados de alta qualidade com menor exigência computacional.
Recursos:
- Geração rápida para iteração criativa ágil
- Compatível com várias imagens de referência para orientar a geração
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Fluxos de criação de imagens em alto volume que exigem velocidade
- Exploração rápida de conceitos e prévias
Custo: Varia conforme as configurações selecionadas e o número de variações
API: bytedance-seedream-5-lite
Seedream 5 Lite não está disponível nos Estados Unidos.
Seedream 5 Pro
A variante Seedream 5 de maior fidelidade para edição precisa, texto multilíngue e infográficos densos.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 10)
Recursos:
- Renderização precisa de texto multilíngue
- Processa layouts densos, como infográficos e pôsteres
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Resoluções: 1K, 2K
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Designs com muito texto em vários idiomas
- Edição de várias imagens com adesão rigorosa às referências
Custo: Varia conforme as configurações selecionadas e o número de variações
Seedream 5 Pro não está disponível nos Estados Unidos.
GPT Image 1.5
Um modelo principal de alta velocidade desenvolvido para geração precisa de imagens a partir de texto e edição de fotos complexa e não destrutiva, preservando os detalhes originais.
Recursos:
- Executa de forma confiável as alterações solicitadas, mantendo a integridade da iluminação, composição e aparência do sujeito nas imagens de origem
- Compatível com tarefas de edição complexas, incluindo adicionar, remover, combinar e mesclar elementos
- Oferece resultados até 4x mais rápidos do que iterações anteriores
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 3:2, 1:1, 2:3
- Opções de qualidade: baixa, média, alta
Ideal para:
- Ajustes práticos de fotos e provas virtuais realistas de roupas ou penteados
- Transformações conceituais e filtros estilísticos que preservam a essência da imagem de entrada
- Iteração rápida de conceitos de texto para imagem
Custo: Varia conforme as configurações selecionadas e o número de variações
API: gpt-image-1.5
GPT Image 1
Modelo de imagem de primeira geração da OpenAI, com boa adesão a prompts, texto legível e edição detalhada.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 5)
Recursos:
- Três níveis de qualidade: Baixa, Média, Alta
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Proporções: 3:2, 1:1, 2:3
Ideal para:
- Fluxos de trabalho já baseados na saída do GPT Image 1
- Edições simples e tarefas de texto em imagem em resolução padrão
Custo: Varia conforme as configurações selecionadas e o número de variações
API: gpt-image-1
Seedream 4.5
Um modelo de base multimodal de alto desempenho que unifica síntese de texto para imagem, edição precisa de imagens e composição complexa de várias imagens em uma única estrutura eficiente.
Recursos:
- Suporte nativo para geração rápida de imagens de alta fidelidade em resolução de até 4K
- Preservação excepcional de traços faciais, iluminação, tom de cor e detalhes finos durante tarefas de edição baseadas em referências
- Identifica e combina com precisão elementos-alvo entre várias imagens de entrada para resultados controláveis e consistentes
- Oferece recursos de composição de nível profissional, com renderização clara e precisa de textos pequenos para pôsteres e visuais de marca
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluções: 2K, 4K
Ideal para:
- Fluxos de design gráfico profissional que exigem layout e tipografia precisos
- Edição complexa de fotos que exige adesão rigorosa à identidade e à iluminação de referência
- Composição criativa em alta resolução usando várias fontes visuais
Custo: Varia conforme as configurações selecionadas e o número de variações
Seedream 4.5 não está disponível nos Estados Unidos.
Kling O1 Image
Um modelo de geração de imagens de alta fidelidade com recursos avançados de raciocínio, desenvolvido para excelente adesão a prompts e consistência visual precisa em composições complexas.
Recursos:
- Capacidade excepcional de interpretar e executar descrições textuais complexas e com várias camadas com alta precisão
- Usa referências de imagem para manter a identidade do sujeito, a iluminação e o estilo estético entre gerações
- Otimizado para texturas realistas, relações espaciais complexas e efeitos de iluminação de nível profissional
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: Auto, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Resoluções: 1K, 2K
Ideal para:
- Materiais criativos profissionais que exigem adesão rigorosa a prompts de texto detalhados e técnicos
- Edição de imagens e design de personagens com alta consistência usando referências visuais
Custo: Varia conforme as configurações selecionadas e o número de variações
Kling O1 Image não está disponível nos Estados Unidos.
FLUX.2 [Pro]
Um modelo de geração e edição de imagens de nível de produção, desenvolvido para fluxos profissionais e que oferece qualidade visual de ponta com foco em velocidade, precisão e consistência.
Recursos:
- Use várias imagens de referência simultaneamente para alcançar consistência de personagem e identidade líder do setor em centenas de materiais
- Oferece um avanço sem precedentes na qualidade dos detalhes, aproximando-se da fotografia real, de texturas de tecido a elementos arquitetônicos
- Entrega renderização de texto pronta para produção em tipografia complexa, mockups de UI e infográficos
- Compatível com especificação precisa de cores da marca via códigos hexadecimais, sem aproximações
- Garante posicionamento preciso de objetos, física realista, iluminação coerente e perspectiva adequada em cenas complexas
- Otimizado para maior precisão e capacidade de resposta a instruções estruturadas e complexas
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluções: 720p, 1080p, 2K
Ideal para:
- Criar campanhas com personagens consistentes e posicionar produtos com precisão em qualquer contexto
- Criar mockups de interface com texto legível e sistemas de design visual consistentes
- Gerar fotografia de produtos em escala e imagens contextuais de estilo de vida
Custo: Varia conforme as configurações selecionadas e o número de variações
Nano Banana Pro
Um modelo profissional de geração e edição de imagens baseado em raciocínio, desenvolvido para produção de materiais em alta fidelidade, controle criativo avançado e execução precisa de instruções.
Entradas:
- Referência de imagem
- Descrição de texto (compatível com prompts complexos e em várias camadas)
Recursos:
- Planeja cenas antes de renderizá-las para oferecer iluminação fisicamente precisa, relações precisas entre objetos e excelente adesão a prompts
- Gera texto multilíngue nítido e legível em vários estilos de fonte e caligrafia para pôsteres e mockups de produtos impactantes
- Mantém alta fidelidade e semelhança para até 5 pessoas e vários objetos em diversas criações
- Integra a Pesquisa Google para aprimorar visuais com dados reais, conhecimento do mundo real e informações em tempo real, como clima ou esportes
- Ajuste ângulos de câmera, pontos focais e iluminação da cena (por exemplo, transformando o dia em noite) com ferramentas avançadas de edição localizada
- A compreensão espacial superior permite gerar infográficos precisos, diagramas técnicos e slides de apresentação
- Gera até 4 variações por vez
Opções de saída:
- Resoluções: 1K, 2K, 4K
- Proporções: Auto, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Publicidade profissional, materiais de marca e fotografia de produtos de e-commerce de alto padrão
- Conteúdo educacional explicativo, infográficos orientados por dados e documentação técnica complexa
- Prototipagem rápida de designs visuais em alta resolução com identidade consistente de personagem ou marca
Custo: Varia conforme as configurações selecionadas e o número de variações
API: gemini-3-pro-image
Nano Banana
Um modelo de alta velocidade para geração e edição rápidas de imagens de alta qualidade diretamente a partir de prompts de texto.
Recursos:
- Compatível com várias imagens de referência para orientar a geração
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Criação e iteração rápidas de imagens
Custo: Varia conforme as configurações selecionadas e o número de variações
Runway Gen-4 Image
Um modelo de base avançado desenvolvido para geração de imagens de alta fidelidade, que oferece controle estilístico sem precedentes e memória visual para manter a consistência entre cenas.
Recursos:
- Fixe personagens, estilos ou objetos específicos usando imagens de entrada para manter consistência de nível profissional em vários resultados
- Otimizado para interpretar descrições complexas em linguagem natural, proporcionando controle preciso sobre detalhes visuais, iluminação e emoções
- Capaz de gerar visuais de alta qualidade para diversos casos de uso, de storyboards cinematográficos a fotografia profissional de produtos
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluções: 720p, 1080p
Ideal para:
- Garantir que protagonistas mantenham sua aparência em diferentes ambientes e tratamentos de iluminação
- Produzir rapidamente materiais de marca em alta resolução, provas virtuais e visualizações de produtos prontas para escala
- Explorar diferentes direções artísticas enquanto preserva a identidade visual principal por meio de referências de imagem
Custo: Varia conforme as configurações selecionadas e o número de variações
Runway Gen-4 Image Turbo
Um modelo otimizado de geração de imagens desenvolvido para velocidade, que entrega resultados 2,5x mais rápido que o Gen-4 Image padrão, mantendo a mesma qualidade de saída.
Recursos:
- O processamento otimizado permite exploração criativa rápida, gerando imagens de alta fidelidade em uma fração do tempo
- Envie até três imagens de referência para orientar a compreensão do modelo sobre personagens, ambientes e estilos artísticos específicos
- Resolve o desafio do desvio visual ao codificar características visuais específicas de imagens de referência para manter a identidade em várias gerações
- Aplique facilmente a estética, a iluminação e a textura de uma imagem de referência a sujeitos e cenas totalmente novos
- Use parâmetros de seed para explorar variações sistematicamente ou recriar resultados específicos com precisão
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluções: 720p, 1080p
Ideal para:
- Produzir rapidamente, em escala, visuais otimizados para plataformas, como Stories do Instagram (9:16) ou posts padrão (1:1)
- Manter uma identidade visual rigorosa entre campanhas usando guias de estilo da marca como imagens de referência
- Desenvolver poses e cenários consistentes para personagens, garantindo que o protagonista continue reconhecível
- Criar com precisão imagens diversas de produtos em contextos de estilo de vida e diferentes estações usando orientação baseada em referência
Custo: Varia conforme as configurações selecionadas e o número de variações
Seedream 4
Um modelo de imagem especializado em gerar sequências de vários planos ou cenas com muito movimento e ação.
Recursos:
- Destaca-se na criação de imagens com física estável e transições coerentes
- Compatível com várias imagens de referência para orientar a geração
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: auto, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Cenas de ação e composições dinâmicas
Custo: Varia conforme as configurações selecionadas e o número de variações
Seedream 4 não está disponível nos Estados Unidos.
Wan 2.5 Image
A variante de imagem do Wan 2.5, com alta fidelidade aos prompts e suporte a imagens de referência.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 2)
Recursos:
- Controles de prompt negativo e seed
- Criação em lote com até 4 gerações por vez
Opções de saída:
- Proporções: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Imagens estáticas que correspondem ao visual das gerações de vídeo do Wan
- Imagens conceituais fiéis ao prompt
Custo: Varia conforme as configurações selecionadas e o número de variações
Wan 2.5 Image não está disponível nos Estados Unidos.
FLUX 3 Image
Um modelo de imagem com até 10 referências de imagem e saída em 4K.
Entradas de geração:
- Texto para imagem
- Referências de imagem (até 10)
Opções de saída:
- Resoluções: 4K
- Proporções: 16 proporções
Ideal para:
- Imagens em 4K guiadas por referências
Custo: Varia conforme as configurações selecionadas e o número de variações
FLUX.1 Kontext [Pro]
Um modelo profissional para geração e edição avançadas de imagens, que oferece forte coerência de cena e controle de estilo.
Recursos:
- Controle de estilo baseado em imagem, que exige uma imagem de referência para orientar a estética visual
- Gera até 4 imagens por vez
Opções de saída:
- Proporções: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Ideal para:
- Conteúdo profissional com requisitos de estilo precisos
Custo: Varia conforme as configurações selecionadas e o número de variações
Modelos de sincronização labial
Creatify Aurora
Um modelo Transformer de difusão (DiT) de última geração, desenvolvido para renderizar avatares ultrarrealistas e reativos, guiados por áudio e texto.
Entradas de geração:
- Avatar (imagem de origem)
- Fala (arquivo de áudio)
- Descrição de texto (orientação)
Recursos:
- Vai além da sincronização labial básica, incluindo piscadas contextuais, respiração e expressões faciais naturais
- Sincroniza automaticamente os movimentos das mãos e de todo o corpo com base no tom e na inflexão da voz, para uma performance de nível profissional
- Interpreta com precisão a intensidade e o tom da voz para transmitir expressões emocionais fiéis à performance
- Mantém alta fidelidade do personagem e coerência comportamental mesmo em diálogos longos ou performances musicais
- Otimizado para várias configurações, incluindo apresentações em ângulo lateral, diálogos no estilo podcast e animações estilizadas
- Gere até 4 variações de uma vez
Opções de saída:
- Resoluções: 480p, 720p
Ideal para:
- Anúncios em vídeo profissionais com avatares e conteúdo de marketing
- Narrativas virtuais de alta fidelidade e performances musicais expressivas
- Vídeos educacionais ou de treinamento de longa duração que exigem presença consistente do personagem
Custo: varia conforme a entrada, as configurações e a duração
API: creatify-aurora
Veed Fabric
Um modelo rápido e preciso de sincronização labial de imagem para vídeo que anima uma imagem estática para corresponder ao áudio fornecido.
Entradas:
- Imagem de origem
- Arquivo de áudio de fala
Recursos:
- Anima a boca e as expressões faciais na imagem de origem para corresponder ao áudio fornecido
- Cria vídeos de pessoas “falando” com alta fidelidade a partir de imagens estáticas
- Ferramenta específica de sincronização labial, não um modelo completo de geração de vídeo
Ideal para:
- Criar avatares falantes a partir de imagens estáticas
- Adicionar diálogos a retratos de personagens
- Fluxos de trabalho profissionais de conteúdo com avatares
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, a imagem deve conter uma figura detectável.
HeyGen Avatar 4
O mais recente modelo de avatar da HeyGen para gerar vídeos de pessoas falando, altamente realistas e expressivos, a partir de uma única imagem e uma entrada de áudio.
Entradas:
- Imagem de origem
- Arquivo de áudio de fala
Recursos:
- Anima expressões faciais e movimentos labiais para corresponder ao áudio fornecido com alta fidelidade
- Produz movimentos naturais da cabeça e microexpressões sutis para resultados realistas
- Ferramenta específica de sincronização labial, não um modelo completo de geração de vídeo
Ideal para:
- Vídeos profissionais de porta-vozes e apresentadores
- Criar conteúdo personalizado com avatares em escala
- Vídeos de marketing e treinamento com presença consistente do personagem
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, a imagem deve conter um rosto claramente visível.
Sync 3
O modelo de sincronização labial para vídeo de última geração da Sync, que oferece sincronização com qualidade de estúdio em uma ampla variedade de tipos de conteúdo.
Entradas de geração:
- Vídeo de origem
- Áudio de fala
Recursos:
- Sincronização labial de alta precisão que preserva detalhes faciais únicos, dentes naturais e textura da pele
- Otimizado para todos os tipos de conteúdo, incluindo live-action, animação 3D e vídeos gerados por IA
- Ferramenta de sincronização labial de vídeo para vídeo, não um gerador de vídeo completo
Ideal para:
- Dublagem e localização profissionais para filmes e publicidade
- Aprimorar ou corrigir diálogos em qualquer formato de vídeo
- Fluxos de trabalho de tradução de conteúdo em alto volume
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, o vídeo deve conter uma figura detectável.
Sync Lipsync 2 Pro
Um modelo de edição de vídeo de última geração desenvolvido para sincronização labial com qualidade de estúdio, que preserva detalhes faciais únicos e oferece saídas em alta resolução.
Entradas de geração:
- Vídeo de origem
- Áudio de fala
Recursos:
- Incorpora aprimoramento de resolução avançado para oferecer saída em 4K e manter texturas nítidas e naturais
- Protege características faciais únicas, como dentes naturais, sardas, maquiagem e pelos faciais complexos, sem perda de clareza
- Otimizado para funcionar com todos os tipos de conteúdo, incluindo live-action, animação 3D e vídeos gerados por IA
- Oferece resultados expressivos e sincronizados imediatamente, sem exigir treinamento específico para cada locutor ou ajuste fino do modelo
- Gere até 4 variações simultaneamente
Ideal para:
- Dublagem de nível profissional e conteúdo localizado para filmes e publicidade de alto padrão
- Aprimorar ou corrigir diálogos em personagens animados em 3D e gerados por IA
- Projetos em alta resolução que exigem consistência e detalhes faciais perfeitos em nível de pixel
Custo: varia conforme a entrada, as configurações e a duração
OmniHuman 1.5
Um modelo utilitário dedicado para gerar sincronização labial excepcionalmente realista e semelhante à humana.
Entradas:
- Imagem de origem estática
- Arquivo de áudio de fala
Recursos:
- Anima a boca na imagem de origem para corresponder ao áudio fornecido
- Cria vídeos de pessoas “falando” com alta fidelidade a partir de imagens estáticas
- Ferramenta específica de sincronização labial, não um modelo completo de geração de vídeo
Ideal para:
- Criar avatares falantes
- Adicionar diálogos a imagens estáticas
- Fluxos de trabalho profissionais de dublagem
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, a imagem deve conter uma figura detectável.
O OmniHuman 1.5 não está disponível nos Estados Unidos.
MiniMax H3 Max Lip Sync
Anima uma imagem estática a partir de um trecho de fala, com saída de até 2K.
Entradas:
- Imagem de origem
- Áudio de fala (de 5 s a 14,8 s)
Recursos:
- Ferramenta específica de sincronização labial, não um modelo completo de geração de vídeo
Ideal para:
- Retratos falantes a partir de uma imagem estática e um trecho curto de áudio
Custo: varia conforme a entrada, as configurações e a duração
Veed Lipsync
Um modelo utilitário rápido, acessível e preciso para aplicar sincronização labial realista a vídeos.
Entradas:
- Vídeo de origem
- Novo arquivo de áudio de fala
Recursos:
- Reanima os movimentos da boca no vídeo de origem para corresponder ao novo áudio
- Ferramenta de sincronização labial de vídeo para vídeo, não um gerador de vídeo completo
Ideal para:
- Dublagem em alto volume e com bom custo-benefício
- Traduzir conteúdo
- Corrigir o áudio em clipes de vídeo com resultados realistas
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, o vídeo deve conter uma figura detectável.
Veed Lipsync 2.0
A versão sucessora de maior qualidade do Veed Lipsync para aplicar sincronização labial realista a vídeos existentes.
Entradas:
- Vídeo de origem
- Novo arquivo de áudio de fala
Recursos:
- Reanima os movimentos da boca no vídeo de origem para corresponder ao novo áudio
- Ferramenta de sincronização labial de vídeo para vídeo, não um gerador de vídeo completo
- Criação em lote com até 4 gerações de uma vez
Ideal para:
- Dublagem e tradução em que a qualidade da saída é mais importante que o custo
- Corrigir diálogos em clipes finalizados
Custo: varia conforme a entrada, as configurações e a duração
Para melhores resultados, o vídeo deve conter uma figura detectável.
Modelos utilitários
Topaz Image Upscale
Aumenta a resolução de uma imagem preservando os detalhes.
Entradas:
- Imagem de origem
Recursos:
- Fatores de ampliação: 1.25x, 1.5x, 2x, 3x, 4x
Ideal para:
- Preparar imagens para telas de alta resolução
Custo: varia conforme a entrada
Topaz Video Upscale
Aumenta a resolução de um vídeo preservando os detalhes.
Entradas:
- Vídeo de origem
Recursos:
- Fatores de ampliação: 1.25x, 1.5x, 2x, 3x, 4x
- Modos de processamento rápido e preciso
- Conversão opcional de taxa de quadros para 24, 25, 30, 48, 50 ou 60 fps
Ideal para:
- Preparar vídeos para telas de alta resolução
Custo: varia conforme a entrada
Remoção de fundo
Remove o fundo de uma imagem e a retorna com transparência alfa.
Entradas:
- Imagem de origem
Recursos:
- Não requer prompt
- Uma única saída por execução
Ideal para:
- Recortes de produtos e composição
- Preparar objetos para uso como referências em outras gerações
Custo: varia conforme a entrada
Remoção de fundo de vídeo
Remove o fundo de um vídeo.
Entradas:
- Vídeo de origem
Recursos:
- Não requer prompt
- O fundo de saída pode ser transparente, preto ou verde
Ideal para:
- Recortar um objeto de gravações existentes
- Preparar vídeos para composição
Custo: varia conforme a entrada
Runway Ruby
Converte vídeo em faixa dinâmica padrão para HDR.
Entradas:
- Vídeo de origem (até 30 s)
Recursos:
- Não requer prompt
- Uma única saída por execução; a duração e o enquadramento seguem a origem
Ideal para:
- Preparar gravações para telas HDR
- Reajustar as cores de vídeos gerados para entrega
Custo: varia conforme a duração do vídeo
Perguntas frequentes
|
|