Imagen y vídeo
Guía completa para crear y editar imágenes y vídeos en ElevenLabs.
Resumen
Imagen y Video te permite crear contenido visual de alta calidad a partir de sencillas descripciones de texto o imágenes de referencia. Genera imágenes estáticas o vídeos dinámicos en cualquier estilo, perfecciónalos de forma iterativa con prompts adicionales, aumenta la resolución para obtener resultados en alta resolución e incluso añade sincronización labial con audio. Exporta los recursos terminados como archivos independientes o impórtalos directamente en proyectos de ElevenCreative Studio.
Algunos modelos de Imagen y Video y funciones de subida de contenido están restringidos en Estados Unidos debido a requisitos normativos o de los proveedores. Consulta las descripciones de cada modelo para conocer su disponibilidad específica.
Los usuarios del plan gratuito solo pueden generar imágenes y tienen un límite de tres solicitudes de imagen al día. La generación de vídeo requiere un plan de pago.
Guía
Sigue estos pasos para crear tu primer recurso visual:
Selecciona el modo
Usa el selector situado en la esquina superior derecha del cuadro de prompt para elegir entre generar Imagen o Vídeo.
Escribe un prompt o añade una referencia
Describe el resultado que quieres con lenguaje natural en el cuadro de prompt. Para tener más control, arrastra imágenes o vídeos existentes desde las pestañas Explorar o Historial a los espacios de referencia, o sube tus propias imágenes de referencia en una amplia variedad de formatos, como JPG, PNG, WEBP y más.
Elige un modelo y sus ajustes
Selecciona el modelo generativo ideal para tu objetivo (por ejemplo, Google Veo 3.1, Kling 2.5 o Flux 1 Kontext Pro). Consulta la sección Modelos para obtener información detallada sobre cada modelo. Ajusta parámetros como la relación de aspecto, la resolución, la duración (para vídeo) y el número de variaciones que quieres generar.
Genera tu recurso
Haz clic en el botón Generar. Tus recursos se crearán y se mostrarán en la pestaña Historial para que los revises.
Mejora y perfecciona
Usa las herramientas de mejora para perfeccionar tu contenido. Aumenta la resolución, aplica LipSync realista con audio o haz clic en Recrear para generar una nueva variación con los mismos ajustes.
Workflow
El proceso de creación te lleva de la inspiración al recurso terminado en cuatro fases:
Explorar
Descubre creaciones de la comunidad para inspirarte, estudiar prompts eficaces o incorporar referencias directamente a tu trabajo.
Generar
Usa el cuadro de prompt para describir lo que quieres crear, selecciona un modelo, ajusta tus parámetros y da vida a tu idea.
Historial
Revisa tus generaciones en la pestaña Historial para iterar y mejorar. Recrea variaciones, reutiliza prompts y aplica mejoras como el aumento de resolución y la sincronización labial.
Exportar
Descarga los recursos terminados en varios formatos o envíalos directamente a ElevenCreative Studio para usarlos en tus proyectos.
Explorar
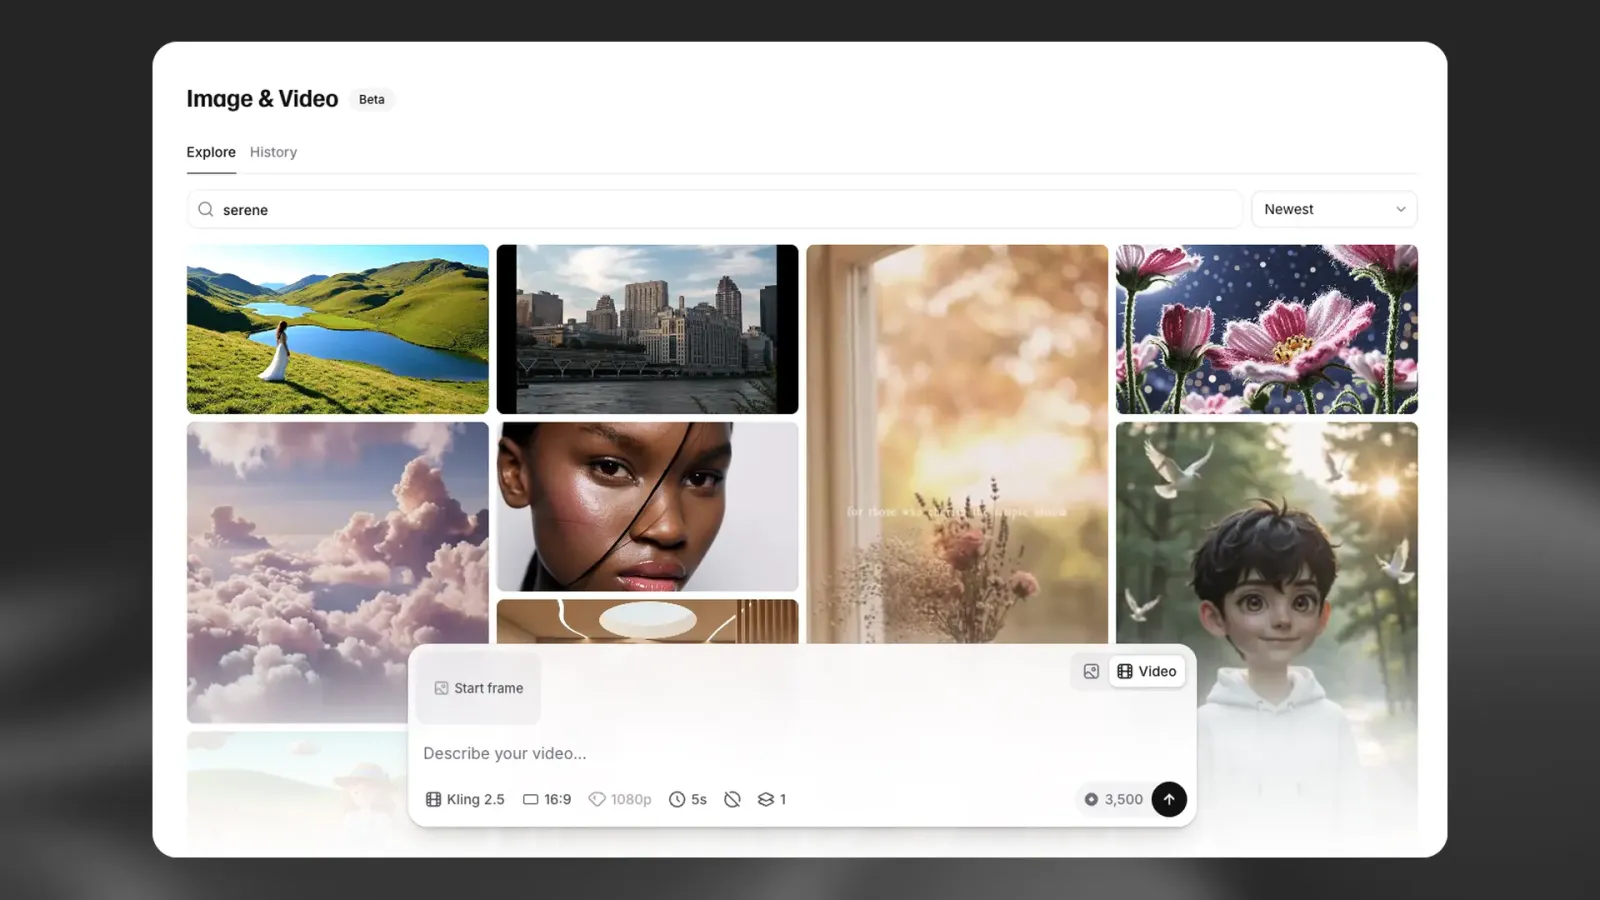
La pestaña Explorar muestra una galería de creaciones de la comunidad para inspirarte y encontrar elementos visuales que usar como referencias.
Buscar: Usa la barra de búsqueda para encontrar imágenes y vídeos según palabras clave.
Ordenar: Alterna entre Tendencias y Más recientes para ver lo más popular o lo añadido recientemente.
Arrastrar y soltar: Arrastra cualquier resultado de la cuadrícula directamente al cuadro de prompt para usarlo como fotograma inicial, fotograma final o referencia de estilo.
Ver detalles: Haz clic en cualquier tarjeta para ver el prompt completo y los ajustes usados para crearla.
Generar
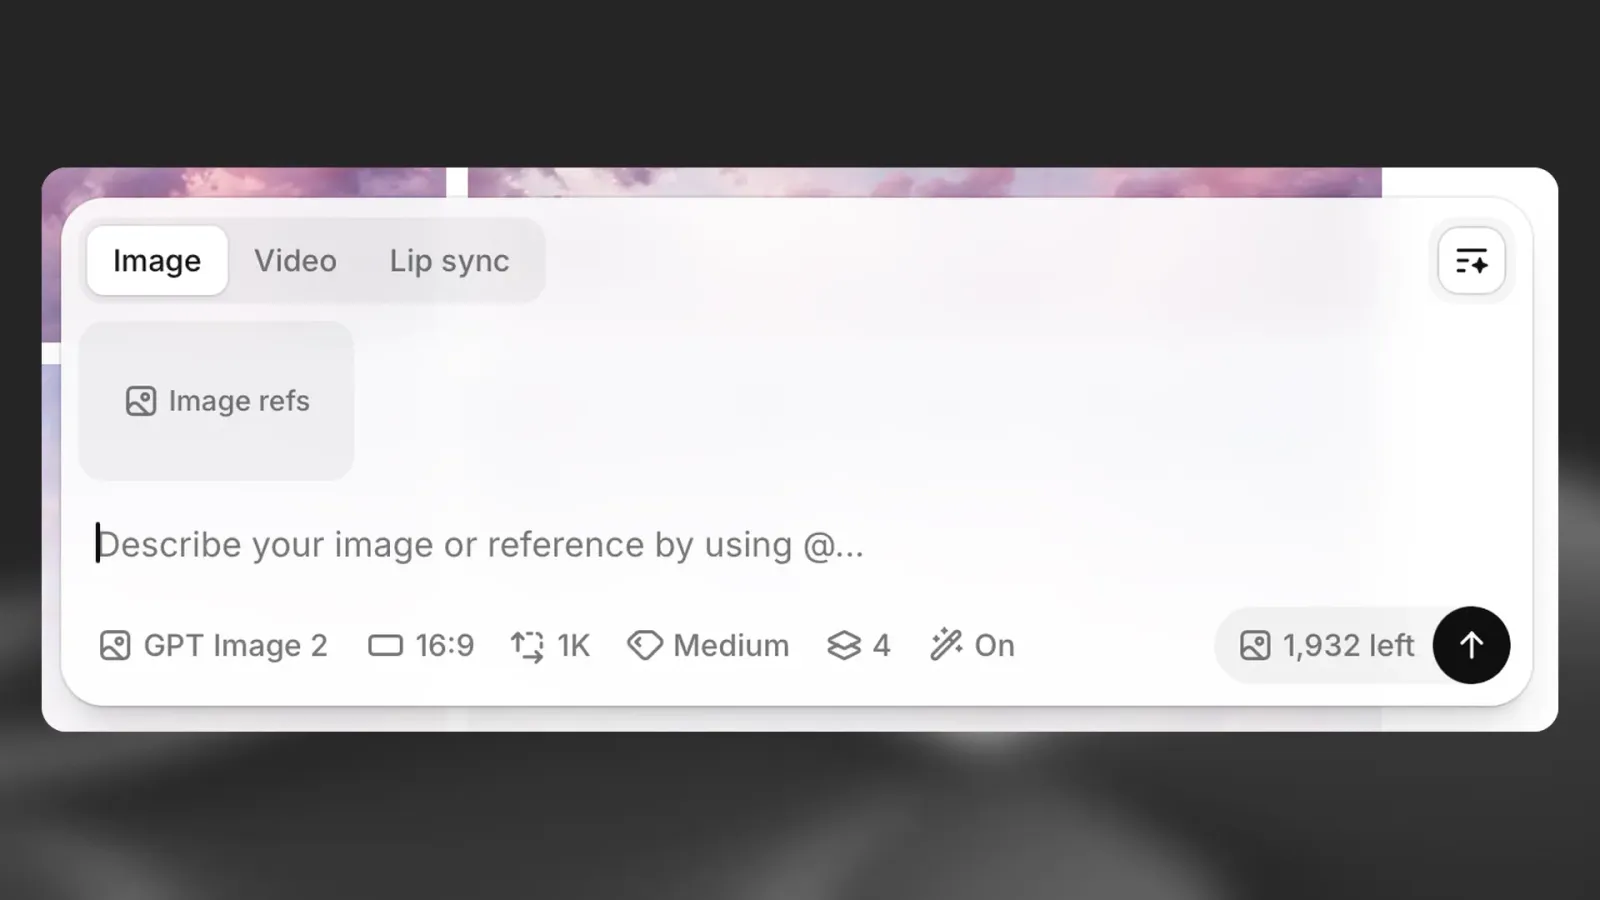
El cuadro de prompt está anclado en la parte inferior de la página y ofrece todos los controles para crear contenido visual.
Configura el modo y el prompt
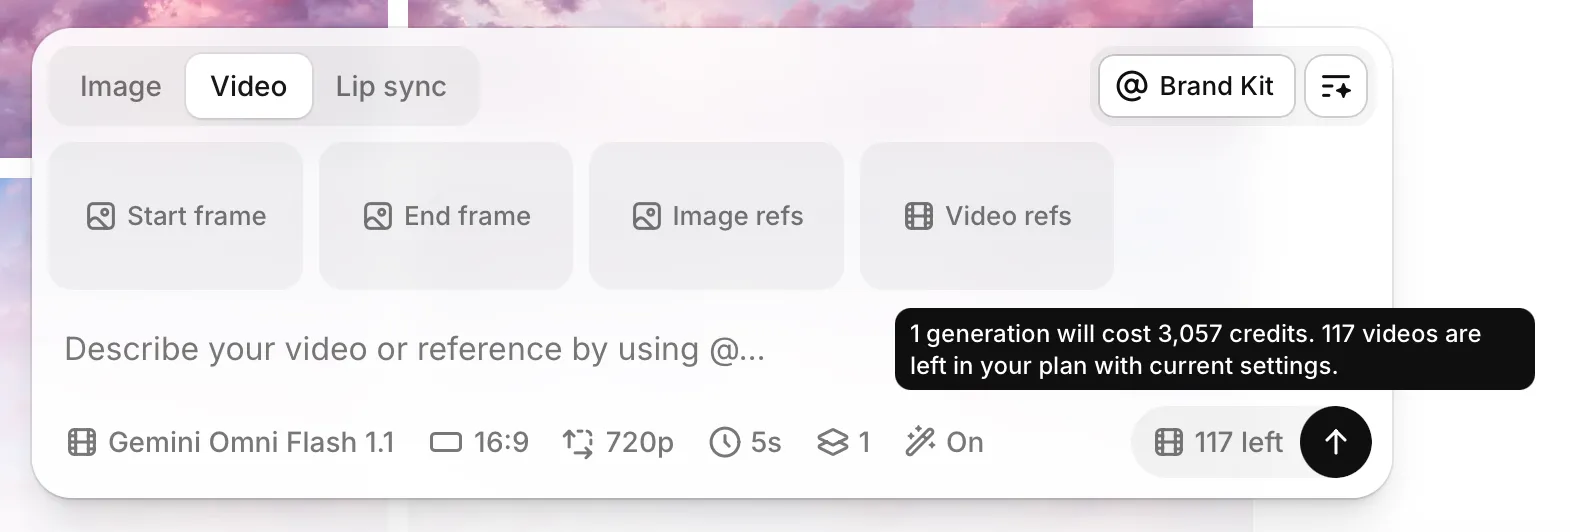
Selecciona el modo: Usa el selector de la esquina superior derecha para alternar entre generar Imagen y Vídeo.
Escribe tu prompt: En el campo principal, describe lo que quieres generar con lenguaje natural. Sé claro y descriptivo para obtener mejores resultados.
Elige modelos y ajustes
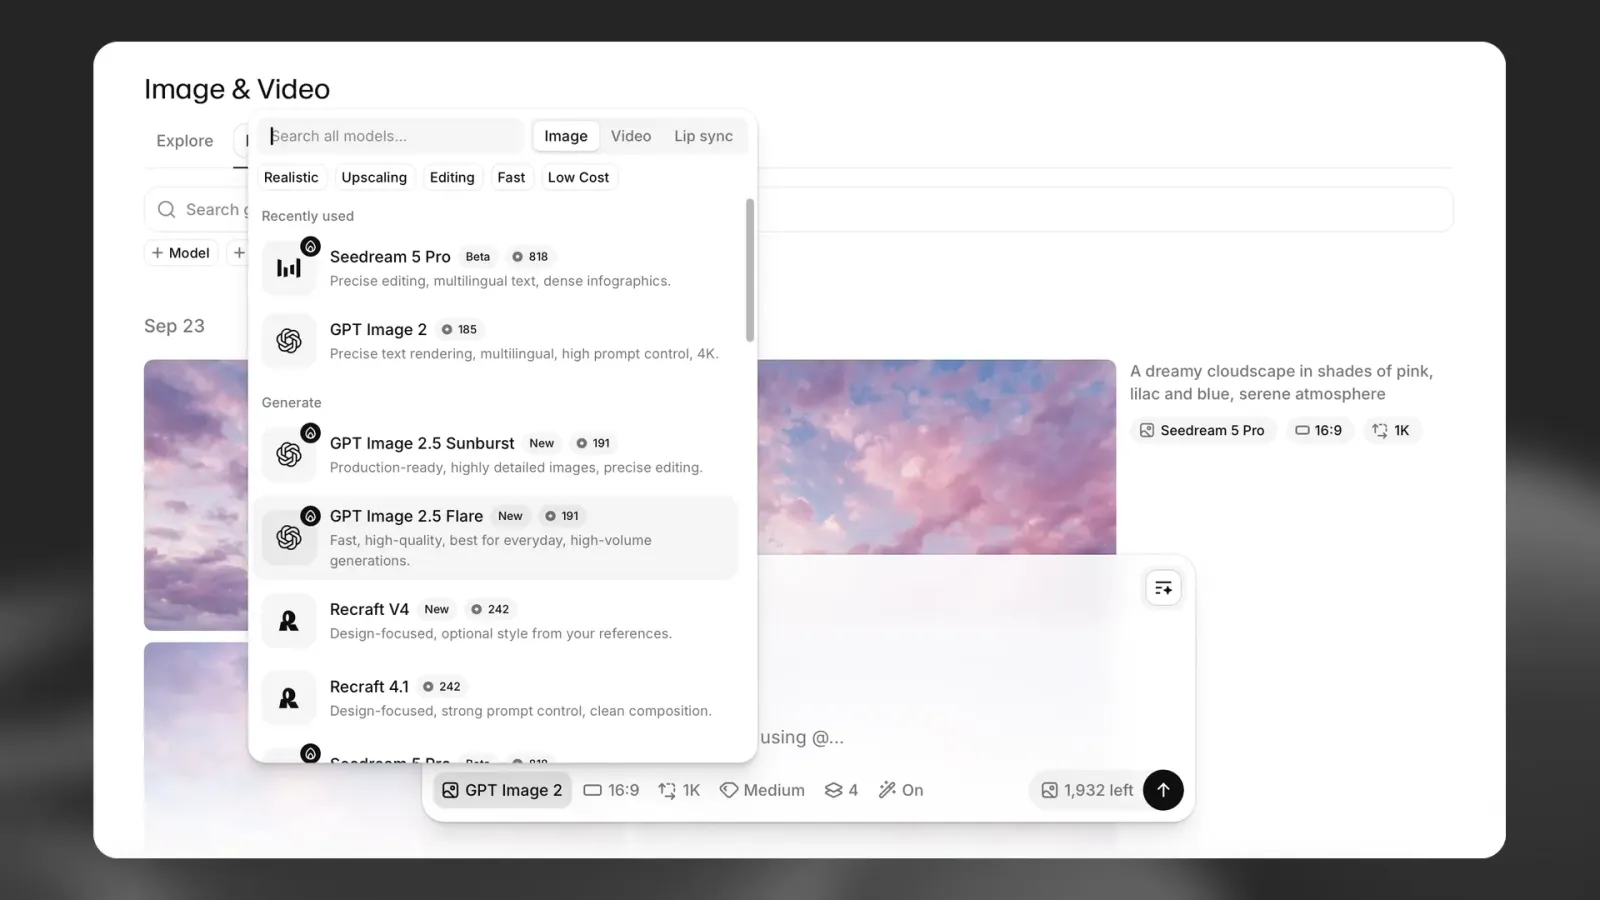
Selecciona un modelo: Abre el menú de modelos para consultar las opciones disponibles, como Google Veo 3.1, Kling 2.5 o Flux 1 Kontext Pro. Cada modelo incluye sus puntos fuertes y capacidades para que puedas compararlos fácilmente. Consulta la sección Modelos para obtener información detallada.
Ajusta los parámetros: Perfecciona tu generación con los ajustes que aparecen debajo del prompt. Varían según el modelo, pero suelen incluir:
- Relación de aspecto: Controla las dimensiones del resultado
- Resolución: Define el nivel de calidad
- Duración: Especifica la duración del vídeo (en modo vídeo)
- Número de generaciones: Crea hasta 4 variaciones a la vez
Usa los controles: En los modelos compatibles, activa Audio, añade un Prompt negativo para excluir elementos no deseados o ajusta el Control de sonido.
Añade referencias
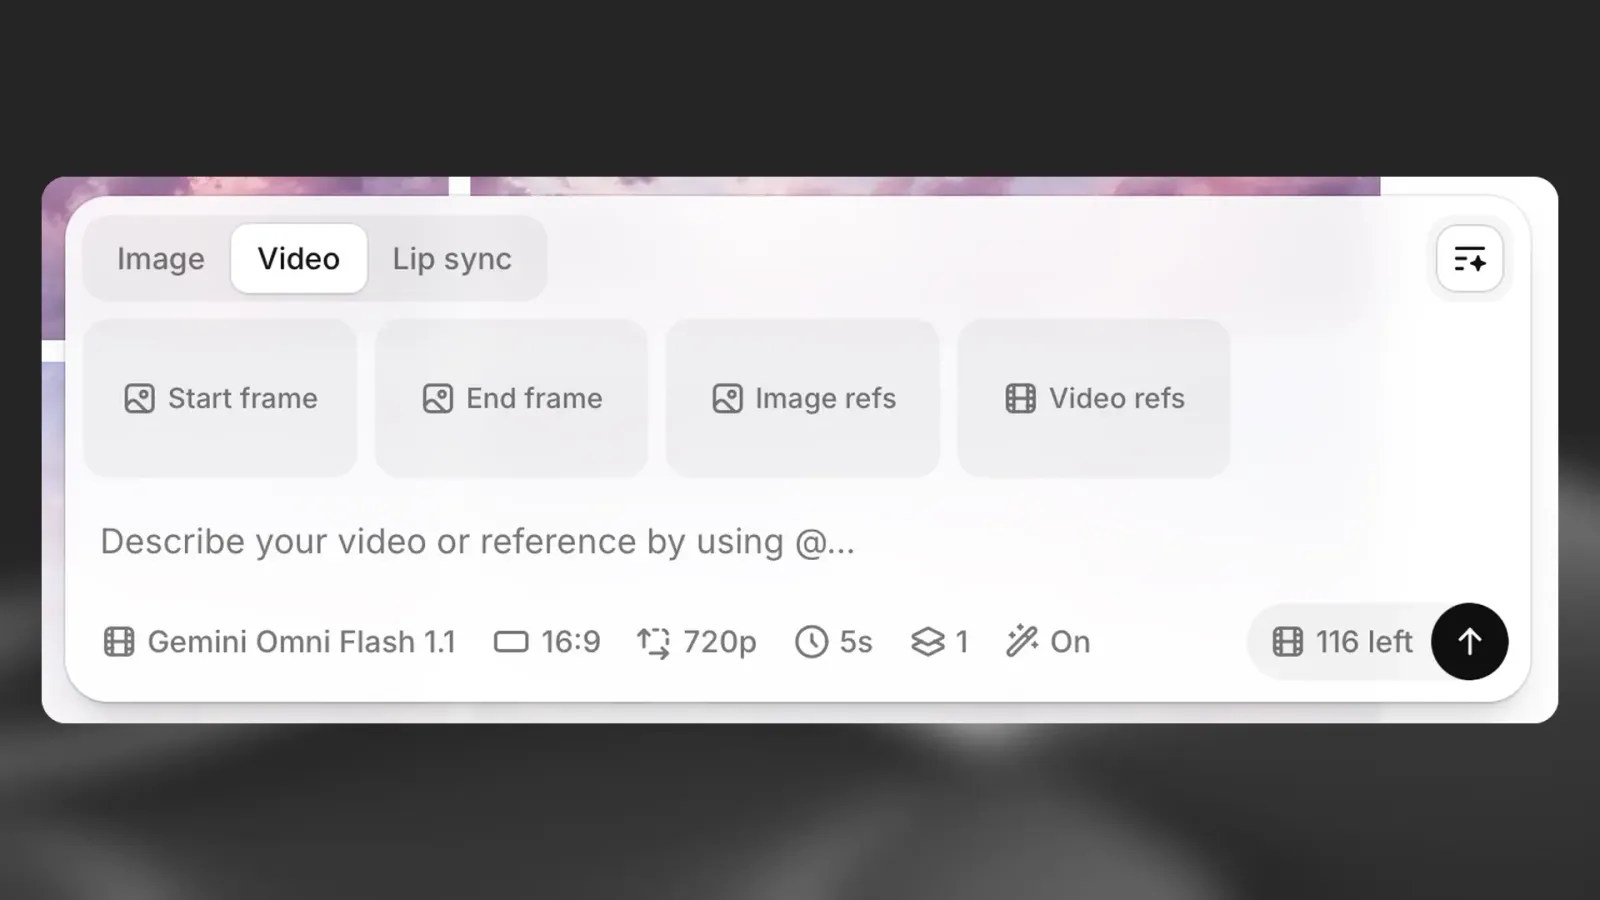
Para tener mayor control sobre el resultado, añade referencias visuales que orienten la generación. La disponibilidad depende del modelo seleccionado. Admitimos una amplia variedad de formatos de imagen, como JPG, PNG, WEBP y más.
Fotograma inicial (vídeo): Define la imagen de apertura del vídeo.
Fotograma final (vídeo): Define la imagen final e influye en la transición.
Referencias de imagen (imagen o vídeo): Proporciona una o varias imágenes para orientar el estilo y el aspecto general.
Arrastra y suelta elementos directamente desde las pestañas Explorar o Historial en los espacios de referencia para disfrutar de un workflow más rápido.
Generar
Antes de generar, un indicador de coste muestra el coste total del número de recursos que has elegido crear. Cuando estés listo, haz clic en Generar. Tus nuevas creaciones aparecerán en la pestaña Historial.
Historial
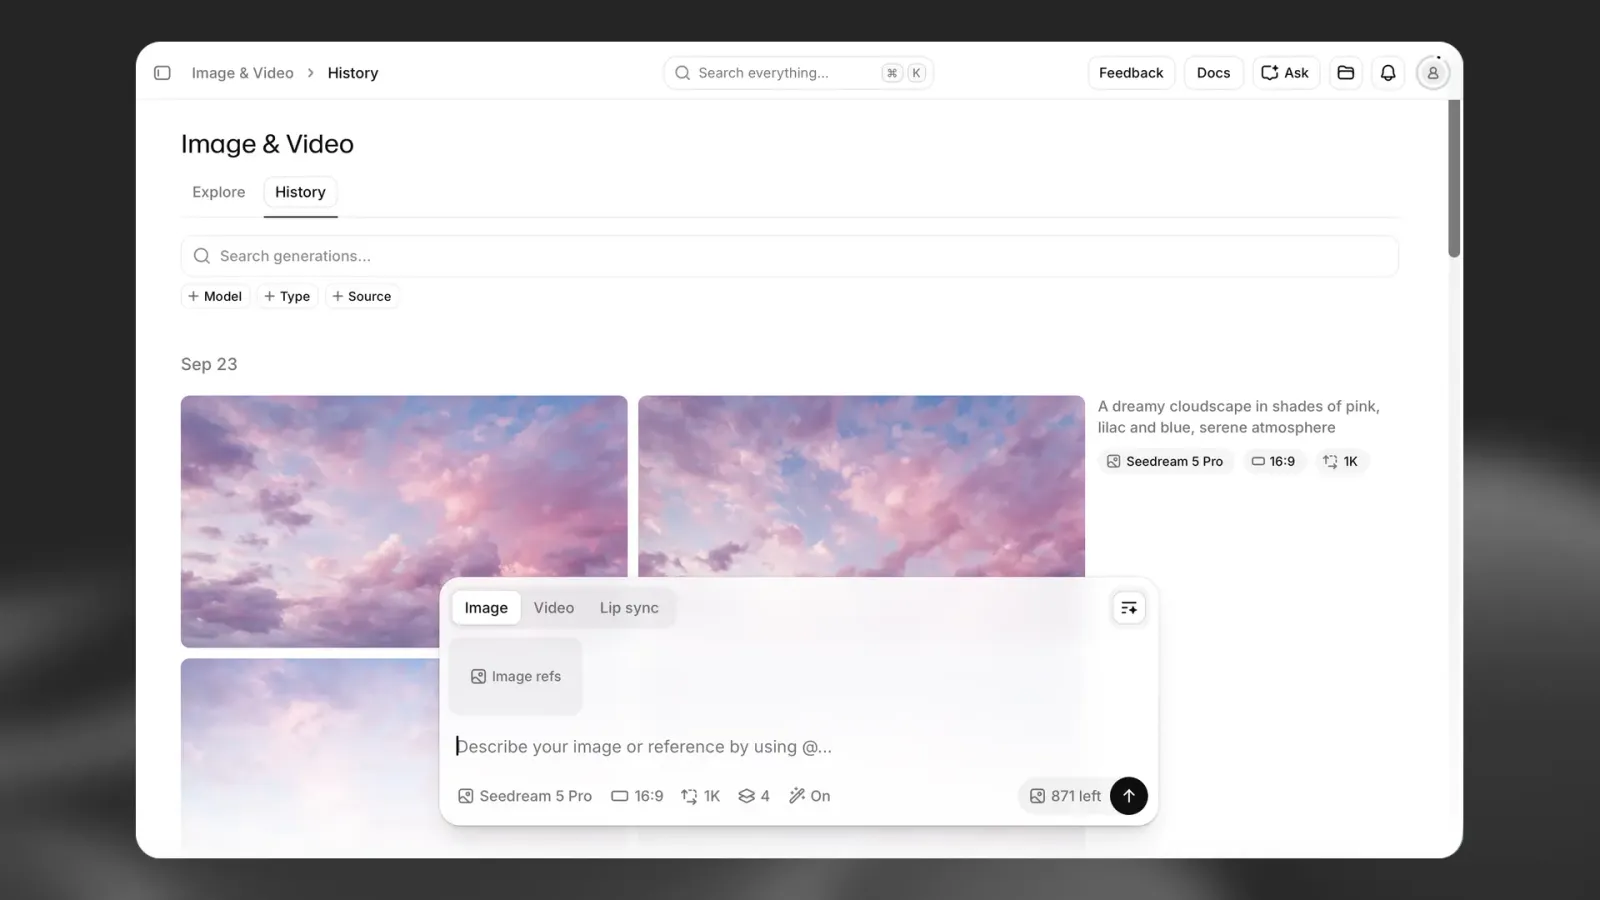
La pestaña Historial ofrece un registro cronológico de todo lo que has generado y sirve como espacio de trabajo para perfeccionar trabajos anteriores.
Explorar: Consulta todas las imágenes y vídeos anteriores.
Inspeccionar: Haz clic en cualquier recurso para ver el prompt original, el modelo y los ajustes utilizados para crearlo.
Reutilizar: Arrastra elementos del Historial de nuevo al cuadro de prompt para usarlos como referencias en nuevas generaciones.
Iterar: Haz clic en Recrear para ejecutar de nuevo el mismo prompt y ajustes y obtener una nueva variación, o ajusta los parámetros para orientar la generación en una dirección diferente.
Compartir: Haz clic en Compartir para generar un enlace único para tu recurso. Envíalo a compañeros y colaboradores para recibir comentarios.
Exportar: Descarga tu recurso como archivo independiente o haz clic en Editar en Studio para importarlo directamente en ElevenCreative Studio.
Exportar
Cuando tengas una generación con la que estés satisfecho, usa las herramientas de mejora integradas antes de exportarla.
Mejora tus creaciones
Aumentar resolución: Usa Topaz Upscale para aumentar la resolución hasta 4 veces manteniendo los detalles nítidos.
LipSync: Aplica sincronización labial realista a tus elementos visuales:
- Omnihuman 1.5: Anima una imagen estática con una pista de audio
- Veed LipSync: Dobla un vídeo existente con audio nuevo
Exporta tus recursos
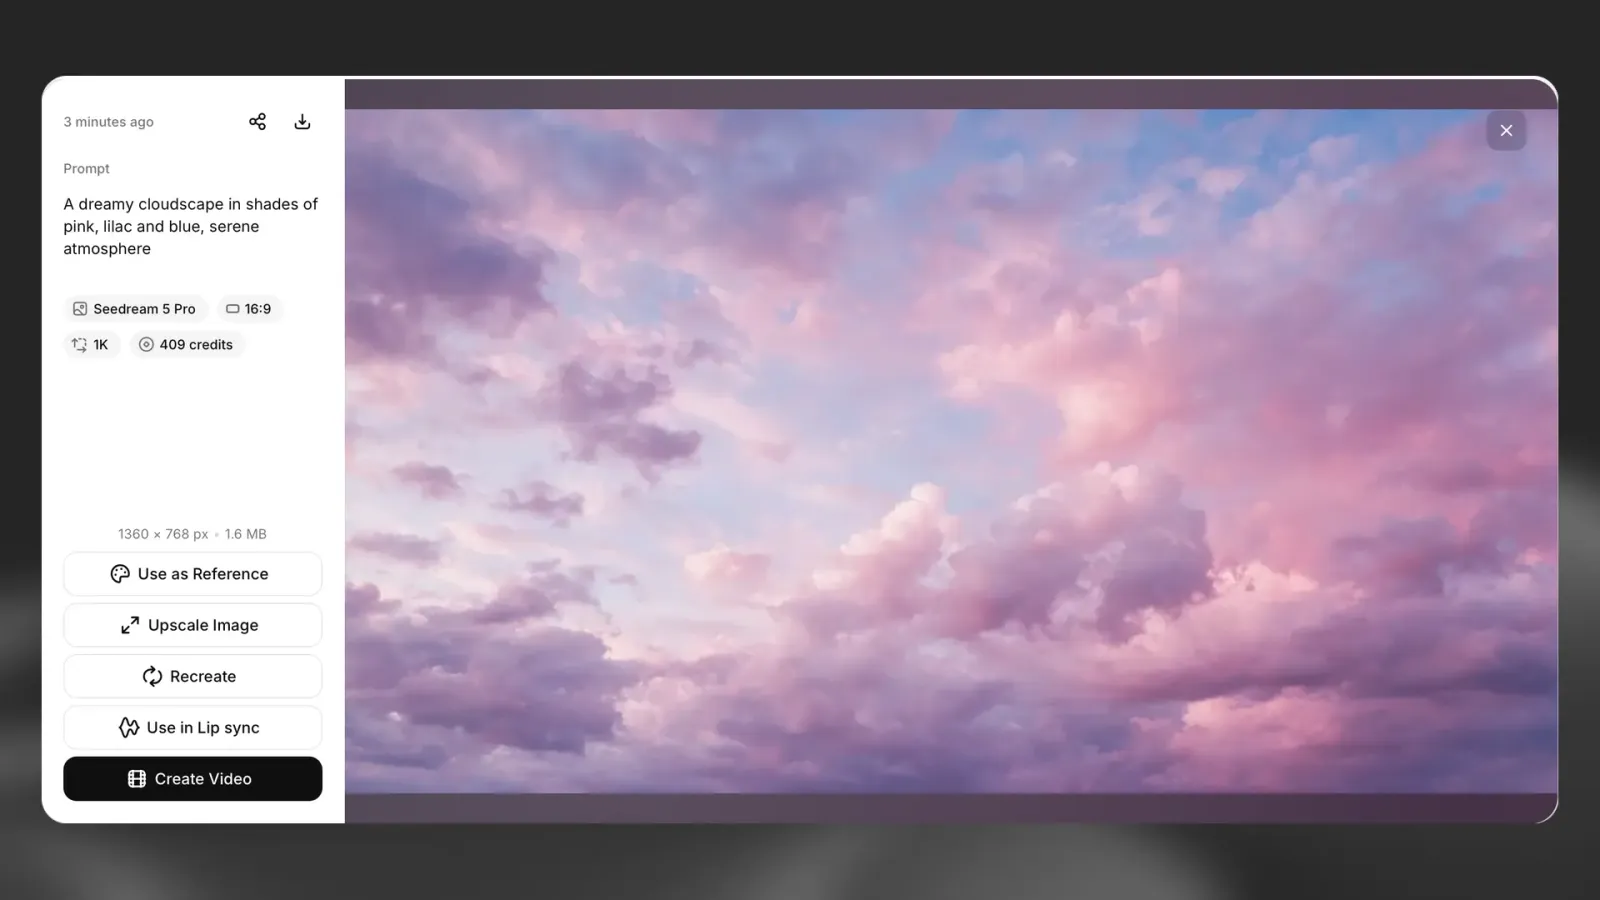
Exporta los recursos terminados descargándolos localmente o enviándolos directamente a ElevenCreative Studio.
Editar en Studio: Importa el recurso directamente en un proyecto de ElevenCreative Studio.
Descargar: Guarda el recurso en tu equipo.
Formatos de descarga compatibles
Vídeo:
- MP4: Códecs H.264, H.265. Calidad de hasta 4K (con reescalado)
Imagen:
- PNG: Resultado de alta resolución y sin pérdidas
Modelos
Imagen y Video da acceso a modelos especializados optimizados para distintos casos de uso. Cada modelo ofrece capacidades únicas, desde iteraciones rápidas hasta calidad lista para producción.
Los modelos de posprocesamiento requieren un resultado generado existente, aunque también puedes subir tu propio archivo de imagen o vídeo.
Los administradores de espacios de trabajo Enterprise pueden controlar qué modelos de generación de imágenes y vídeo están disponibles para los miembros del espacio de trabajo. De forma predeterminada, todos los modelos están desactivados para los espacios de trabajo Enterprise y deben activarlos explícitamente los administradores. Más información sobre las aprobaciones de modelos.
Para las solicitudes de API, los modelos de ByteDance están desactivados de forma predeterminada y requieren aprobación explícita antes de usarse. Los clientes Enterprise pueden contactar con soporte para solicitar acceso.
Modelos generativos de vídeo
Seedance 2.0
Un modelo de vídeo multimodal unificado con generación conjunta de audio y vídeo, que ofrece control de nivel de dirección sobre la interpretación, la iluminación, las sombras y el movimiento de cámara para obtener resultados cinematográficos ultrarrealistas.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen
- Referencias de vídeo
- Referencias de audio
Funciones:
- Arquitectura multimodal unificada que genera conjuntamente audio y vídeo sincronizados en una sola pasada
- Capacidades líderes del sector de referencia y edición multimodal, que aceptan simultáneamente entradas de texto, imagen, audio y vídeo
- Estabilidad de movimiento excepcional con realismo de calidad cinematográfica acorde con los estándares del sector
- Control creativo de nivel de dirección sobre la interpretación, la iluminación, las sombras y el movimiento de cámara
- Duraciones de generación flexibles, de 4 s a 15 s
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p, 1080p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas cinematográficas que requieren audio e imágenes sincronizados
- Contenido basado en referencias que debe respetar estrictamente las imágenes, los vídeos o el audio de origen
- Producciones profesionales que requieren un control detallado de la iluminación y el trabajo de cámara
Coste: Varía según los ajustes seleccionados y la duración
Seedance 2.0 Fast
Una variante más rápida y económica de Seedance 2.0 con las mismas entradas de referencia multimodal, limitada a salida de 720p.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 9)
- Referencias de vídeo (hasta 3, 15 s en total)
- Referencias de audio (hasta 3, 15 s en total)
Funciones:
- El mismo manejo de referencias que Seedance 2.0, con un límite combinado de 12 referencias por generación
- Los fotogramas y las referencias son mutuamente excluyentes: usa un fotograma inicial o final, o referencias, pero no ambos
- Duraciones de generación flexibles, de 4 s a 15 s
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Iterar prompts de Seedance 2.0 antes de un renderizado a resolución completa
- Clips basados en referencias en los que una salida de 720p es suficiente
Coste: Varía según los ajustes seleccionados y la duración
API: bytedance-seedance-v2-fast
Seedance 2.0 Fast no está disponible en Estados Unidos.
Seedance 2.0 Mini
La variante más pequeña de Seedance 2.0: aproximadamente el doble de rápida que Seedance 2.0 y con cerca de la mitad del coste, con las mismas entradas y salida de 720p.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 9)
- Referencias de vídeo (hasta 3, 15 s en total)
- Referencias de audio (hasta 3, 15 s en total)
Funciones:
- El mismo manejo de referencias que Seedance 2.0, con un límite combinado de 12 referencias por generación
- Los fotogramas y las referencias son mutuamente excluyentes: usa un fotograma inicial o final, o referencias, pero no ambos
- Duraciones de generación flexibles, de 4 s a 15 s
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Borradores y previsualizaciones de gran volumen
- Flujos de trabajo sensibles al coste que siguen necesitando entradas de audio y referencias
Coste: Varía según los ajustes seleccionados y la duración
API: bytedance-seedance-v2-mini
Seedance 2.0 Mini no está disponible en Estados Unidos.
Seedance 2.5
El sucesor de Seedance 2.0, con un realismo más nítido, hasta 50 referencias combinadas de imagen, vídeo y audio, y generaciones de hasta 30 segundos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 30)
- Referencias de vídeo (hasta 10, 30 s en total)
- Referencias de audio (hasta 10, 30 s en total)
Funciones:
- Sin límite combinado entre tipos de referencia; se aceptan referencias de solo audio sin imagen ni vídeo
- Los fotogramas y las referencias son mutuamente excluyentes
- Duraciones de generación flexibles, de 4 s a 30 s
- La relación de aspecto se toma del fotograma inicial o del vídeo de referencia cuando se proporciona uno
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Clips largos que deben mantener la coherencia con muchas referencias
- Escenas de diálogo e interpretación guiadas por audio de referencia
Coste: Varía según los ajustes seleccionados y la duración
Seedance 2.5 no ofrece control de semilla.
Seedance 2.5 Video Edit
Edita un vídeo existente describiendo los cambios. La duración de salida y la relación de aspecto siguen el vídeo de entrada.
Entradas de generación:
- Vídeo que editar (obligatorio, hasta 30 s)
- Prompt de texto que describe las ediciones
- Referencias de imagen (hasta 30)
- Referencias de vídeo adicionales (hasta 10, 30 s en total)
- Referencias de audio (hasta 10, 30 s en total)
Funciones:
- Sin control de duración: la salida coincide con la duración del vídeo de entrada
- La relación de aspecto se toma del vídeo de entrada
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
Ideal para:
- Cambiar vestuario, accesorios, iluminación o escenario en material existente
- Transferencia de estilo que conserva el movimiento original
Coste: Varía según los ajustes seleccionados y la duración
Seedance 2.5 Video Extend
Continúa un vídeo existente desde donde termina, guiado por un prompt y referencias opcionales.
Entradas de generación:
- Vídeo que ampliar (obligatorio, hasta 30 s)
- Prompt de texto que describe la continuación
- Referencias de imagen (hasta 30)
- Referencias de vídeo adicionales (hasta 10, 30 s en total)
- Referencias de audio (hasta 10, 30 s en total)
Funciones:
- Duración de extensión de 4 s a 30 s
- La relación de aspecto se toma del vídeo de entrada
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
Ideal para:
- Alargar un plano que termina demasiado pronto
- Encadenar varias generaciones en una secuencia más larga
Coste: Varía según los ajustes seleccionados y la duración
Kling 3.0
Un modelo de vídeo avanzado que funciona como un director de IA y mantiene una alta coherencia de personajes, elementos y escenas durante movimientos de cámara complejos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
Funciones:
- Conservación de alta fidelidad de personajes y escenas mediante referencias de imagen o vídeo desde varios ángulos
- Cogeneración audiovisual nativa con sincronización labial multilingüe y sonido ambiental
- Duraciones de generación flexibles, de 3 s a 15 s
- Genera hasta 4 variaciones simultáneamente
- Manejo mejorado de texto, dinámica de fluidos e interacciones físicas complejas
Opciones de salida:
- Resoluciones: solo 1080p
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Narrativas centradas en personajes que requieren continuidad visual
- Anuncios y recursos con necesidades específicas de renderizado de texto
Coste: Varía según los ajustes seleccionados y la duración
Admite prompts negativos para un control detallado. El sonido puede activarse o desactivarse en cada generación.
Kling 3.0 no está disponible en Estados Unidos.
Kling O3
Un modelo de vídeo de alta coherencia que funciona como un director de IA y preserva la identidad de personajes, elementos y escenas durante movimientos de cámara complejos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencia de vídeo
- Referencia de imagen
Funciones:
- Mantiene una identidad visual precisa de los personajes y elementos principales mediante referencias desde varios ángulos
- Admite duraciones de generación continuas de 3 s a 15 s
- Genera hasta 4 variaciones a la vez
- Modelado preciso de las interacciones entre elementos y la coherencia del movimiento
- Compatibilidad nativa con audio activado o desactivado en cada generación
Opciones de salida:
- Resoluciones: solo 1080p
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Narrativas centradas en personajes que requieren una continuidad visual estricta
- Recursos profesionales de marketing y marca con renderizado coherente de elementos
Coste: Varía según los ajustes seleccionados y la duración
Kling O3 no está disponible en Estados Unidos.
Kling O3 Edit
Un modelo de edición de vídeo a vídeo guiado por lenguaje natural y basado en la arquitectura O3, que permite transformaciones visuales complejas —como sustituir personajes o cambiar entornos— sin necesidad de máscaras manuales ni ajustes fotograma a fotograma.
Entradas de generación:
- Vídeo de origen
- Referencias de imagen (hasta 4 elementos/ángulos distintos)
- Descripción de texto (instrucciones en lenguaje natural)
Funciones:
- Interpreta prompts conversacionales para sustituir sujetos o escenarios respetando la estructura de movimiento original
- Mantiene los ángulos de cámara, los patrones de movimiento y las relaciones espaciales originales durante toda la edición
- Combina hasta 4 elementos en total (incluidas imágenes frontales y desde varios ángulos) para garantizar una alta coherencia de personajes
- Opción de conservar el audio de origen original o generar una salida sin sonido en cada generación
- Genera hasta 4 variaciones editadas a la vez
Opciones de salida:
- Resoluciones: dependen del vídeo de origen
- Relaciones de aspecto: coincide con el vídeo de origen
Ideal para:
- Sustitución de personajes de alta fidelidad en material existente manteniendo los movimientos originales
- Transformaciones completas del entorno de una escena (por ejemplo, cambiar una ciudad diurna por un paisaje nocturno futurista)
- Aplicar transferencias de estilo que requieren respetar estrictamente la dinámica de cámara existente
Coste: Varía según la duración del vídeo y los ajustes seleccionados
Kling O3 Edit no está disponible en Estados Unidos.
Google Veo 3.1
Un modelo de calidad profesional para la generación de vídeo cinematográfico de alta calidad.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen
Funciones:
- Excelente calidad y control creativo con prompts negativos
- Audio totalmente integrado y sincronizado
- Diálogo, sincronización labial y efectos de sonido realistas
- Duraciones fijas: 4 s, 6 s y 8 s
- Creación por lotes de hasta 4 generaciones a la vez
- Control de sonido específico
Opciones de salida:
- Resoluciones: 720p, 1080p
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Generación de vídeo cinematográfico de alta calidad con control creativo completo
Coste: Varía según los ajustes seleccionados y la duración
API: veo-3.1-generate-001
Activar y desactivar el sonido cambiará los créditos de generación.
Google Veo 3.1 Fast
Un modelo de alta velocidad optimizado para previsualizaciones y generaciones rápidas, que ofrece imágenes más nítidas con menor latencia.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
Funciones:
- Control creativo avanzado con prompts negativos y control de sonido específico
- Duraciones fijas: 4 s, 6 s y 8 s
- Creación por lotes de hasta 4 generaciones a la vez
- Modela con precisión la física del mundo real para lograr movimientos e interacciones realistas
Opciones de salida:
- Resoluciones: 720p, 1080p
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Iteración rápida y pruebas A/B de imágenes
- Creación ágil de contenido para redes sociales
Coste: Varía según los ajustes seleccionados y la duración
Google Veo 3.1 Lite
Una variante de Veo 3.1 rápida y eficiente en costes, optimizada para generar rápidamente con menos capacidad de cálculo.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
Funciones:
- Control creativo detallado con prompts negativos y control de sonido específico
- Duraciones fijas: 4 s, 6 s y 8 s
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Creación de contenido de gran volumen donde se priorizan la velocidad y la eficiencia de costes
- Exploración rápida de conceptos y previsualizaciones
Coste: Varía según los ajustes seleccionados y la duración
Gemini Omni Flash 1.1
El modelo de vídeo de Google con física integrada, audio nativo, salida de hasta 4K y generación tanto por interpolación de fotogramas como guiada por referencias.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 10)
- Referencias de vídeo (hasta 3, de hasta 10 s cada una)
Funciones:
- Los fotogramas y las referencias son mutuamente excluyentes: interpola entre fotogramas o guía con referencias
- Duraciones fijas de 3 s a 10 s; la duración sigue el vídeo de referencia cuando se adjunta uno
- Excelente renderizado de texto breve y etiquetas en pantalla
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 360p, 720p, 1080p, 4K
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Vídeos explicativos y tipografía cinética con texto legible
- Movimiento basado en la física con sujetos coherentes entre referencias
Coste: Varía según los ajustes seleccionados y la duración
Gemini Omni Flash 1.1 Extend
Continúa un vídeo existente desde donde termina mediante Gemini Omni Flash 1.1, hasta una duración total de 40 segundos.
Entradas de generación:
- Vídeo que ampliar (obligatorio, hasta 30 s)
- Prompt de texto que describe la continuación
Funciones:
- Duración de extensión de 3 s a 10 s
- La relación de aspecto sigue el vídeo de entrada
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 360p, 720p, 1080p, 4K
Ideal para:
- Alargar generaciones de Gemini Omni Flash sin un corte visible
- Crear secuencias más largas de lo que permite una sola generación
Coste: Varía según los ajustes seleccionados y la duración
Gemini Omni Flash
El primer modelo de vídeo Gemini Omni: movimiento basado en la física, audio nativo y el mejor renderizado de texto en pantalla de los modelos de vídeo disponibles, a 720p.
Entradas de generación:
- Texto a Vídeo
- Referencias de imagen (hasta 8)
- Referencia de vídeo (1, hasta 10 s)
Funciones:
- Duraciones fijas de 3 s a 10 s; la duración sigue el vídeo de referencia cuando se adjunta uno
- Sin fotograma inicial ni final; usa referencias de imagen para fijar un sujeto
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Subtítulos breves, títulos y explicativos con etiquetas
- Coherencia entre varias imágenes a 720p
Coste: Varía según los ajustes seleccionados y la duración
Seedance 1.5 Pro
Un modelo especializado mejorado para crear secuencias dinámicas de alta fidelidad, con mayor estabilidad temporal y un control preciso de las transiciones entre fotogramas clave.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial
- Fotograma final
Funciones:
- Conecta sin interrupciones los fotogramas inicial y final para crear secuencias coherentes de varios planos
- Modelado de alta fidelidad de acciones complejas y consistencia del entorno
- Admite duraciones de generación fijas de 4 s a 12 s
- Genera hasta 4 variaciones a la vez
- Compatibilidad nativa con audio activado o desactivado en cada generación
Opciones de salida:
- Resoluciones: 420p, 720p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas y escenas de acción que requieren una física estable entre referencias visuales específicas
- Transiciones cinematográficas y recursos de vídeo profesionales con requisitos estrictos de inicio y final
Coste: Varía según la configuración y la duración seleccionadas
Seedance 1.5 Pro está obsoleto. ByteDance retirará el modelo el 11 de noviembre de 2026 y ya no se ofrece para nuevas generaciones. Utiliza un modelo Seedance 2.0 en su lugar. Seedance 1.5 Pro no está disponible en Estados Unidos.
FLUX 3
El modelo de vídeo de Black Forest Labs con movimiento natural, escenas de varios planos, audio generado y ampliación de vídeo.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial
- Fotograma final
- Vídeo que ampliar (1, hasta 15 s)
Funciones:
- La ampliación de vídeo es mutuamente excluyente con los fotogramas inicial y final
- Duraciones de generación flexibles de 5 s a 20 s
- Control nativo del sonido con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 720p, 1080p
- Relaciones de aspecto: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Escenas de varios planos a partir de un único prompt
- Ampliar un clip existente con movimiento y audio coincidentes
Coste: Varía según la configuración y la duración seleccionadas
FLUX 3 Edit
Edita un vídeo existente a partir de un prompt de texto. La duración y el encuadre de salida siguen el vídeo de origen, hasta 15 s.
Entradas de generación:
- Vídeo que editar (obligatorio, hasta 15 s)
- Prompt de texto que describe las ediciones
Opciones de salida:
- La resolución y la relación de aspecto coinciden con el vídeo de origen
Ideal para:
- Cambios basados en prompts en metraje existente
Coste: Varía según la configuración y la duración seleccionadas
MiniMax H3
El modelo de vídeo insignia de MiniMax con referencias multimodales, audio generado y salida de hasta 4K.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 9)
- Referencias de vídeo (hasta 3, de 2 s a 15 s cada una, 15 s en total)
- Referencias de audio (hasta 3, de 2 s a 15 s cada una, 15 s en total)
Funciones:
- Límite combinado de 12 referencias por generación; las referencias de audio requieren al menos una referencia de imagen o vídeo
- Los fotogramas y las referencias son mutuamente excluyentes
- Duraciones de generación flexibles de 5 s a 15 s
- Genera audio sincronizado
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 768p, 2K, 4K (2K y 4K se reescalan desde 768p)
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Escenas basadas en referencias que necesitan una entrega en alta resolución
- Clips de diálogo guiados por audio de referencia
Coste: Varía según la configuración y la duración seleccionadas
MiniMax H3 no está disponible en Estados Unidos.
MiniMax H3 Max
Una variante casi instantánea de MiniMax H3 con las mismas entradas y una estética destacada, renderizada de forma nativa hasta 768p.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 9)
- Referencias de vídeo (hasta 3, de 2 s a 15 s cada una, 15 s en total)
- Referencias de audio (hasta 3, de 2 s a 15 s cada una, 15 s en total)
Funciones:
- Límite combinado de 12 referencias por generación; las referencias de audio requieren al menos una referencia de imagen o vídeo
- Los fotogramas y las referencias son mutuamente excluyentes
- Duraciones de generación flexibles de 5 s a 15 s
- Genera audio sincronizado
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 768p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Iteración rápida de prompts y referencias
- Vistas previas antes de renderizar con MiniMax H3
Coste: Varía según la configuración y la duración seleccionadas
MiniMax H3 Max no está disponible en Estados Unidos.
MiniMax H3 Max Recast
Sustituye a las personas de un vídeo de origen usando de 1 a 4 fotos. La duración sigue la del vídeo de origen, hasta 30 s, y se conserva el audio original.
Entradas de generación:
- Vídeo de origen (hasta 30 s)
- Fotos de las personas que sustituir (de 1 a 4)
Funciones:
- La duración de salida sigue la del vídeo de origen
- Conserva el audio de origen
Opciones de salida:
- Resoluciones: hasta 1080p
- La relación de aspecto sigue la del vídeo de origen
Ideal para:
- Sustituir personas de metraje existente por sujetos de fotos de referencia
Coste: Varía según la configuración y la duración seleccionadas
Kling O1
Un modelo de vídeo con razonamiento de última generación diseñado para ofrecer una fidelidad superior al prompt y una simulación compleja del mundo físico, que utiliza procesamiento lógico avanzado para interpretar y ejecutar instrucciones detalladas.
Entradas de generación:
- Texto a vídeo (descripción)
- Fotograma inicial y fotograma final
- Referencia de vídeo
- Referencia de imagen
Funciones:
- Capacidad excepcional para interpretar prompts multicapa y ejecutar acciones cronológicas complejas
- Aprovecha imágenes y vídeos como anclajes visuales para mantener una alta consistencia de personajes y escenas
- Modelado superior de interacciones físicas, causa y efecto, y dinámica de fluidos
- Admite generación de alta calidad para clips de 5 s y 10 s
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: dependen de la entrada
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Conceptos creativos muy específicos que requieren un cumplimiento preciso de descripciones largas y detalladas
- Narrativas profesionales en las que el realismo físico y la consistencia entre varias referencias son esenciales
Coste: Varía según la configuración y la duración seleccionadas
Kling O1 no está disponible en Estados Unidos.
Kling O1 Edit
Un modelo de edición de vídeo a vídeo guiado por lenguaje natural que permite transformaciones visuales complejas, como sustituir personajes y entornos, sin necesidad de enmascarado manual ni ajustes fotograma a fotograma.
Entradas de generación:
- Vídeo de origen
- Referencias de imagen (hasta 4 elementos/ángulos distintos)
- Descripción de texto (instrucciones en lenguaje natural)
Funciones:
- Interpreta prompts conversacionales para sustituir sujetos o escenarios respetando la estructura de movimiento original
- Mantiene los ángulos de cámara, patrones de movimiento y relaciones espaciales originales durante toda la edición
- Combina hasta 4 elementos en total, incluidas imágenes frontales y desde varios ángulos, para garantizar una consistencia de personajes de alta fidelidad
- Opción de conservar el audio original o generar una salida silenciosa en cada generación
- Genera hasta 4 variaciones editadas a la vez
Opciones de salida:
- Resoluciones: dependen del vídeo de origen
- Relaciones de aspecto: coinciden con el vídeo de origen
Ideal para:
- Sustitución de personajes de alta fidelidad en metraje existente conservando los movimientos originales
- Transformaciones completas del entorno de una escena (por ejemplo, cambiar una ciudad diurna por un paisaje nocturno futurista)
- Aplicar transferencias de estilo que requieren una adhesión estricta a la dinámica de cámara existente
Coste: Varía según la duración del vídeo y la configuración seleccionada
Kling O1 Edit no está disponible en Estados Unidos.
Kling 2.6 Motion Control
Un modelo especializado para transferir movimiento con precisión, que te permite animar la imagen de un personaje con un vídeo de referencia para reproducir movimientos, gestos y ángulos de cámara específicos.
Entradas de generación:
- Imagen del personaje (origen)
- Vídeo de movimiento (referencia)
- Descripción de texto (opcional)
Funciones:
- Elige “Match Video” para reproducir el movimiento con exactitud o “Match Image” para añadir movimiento creativo nuevo a un personaje
- Admite hasta 30 s en modo Match Video y 10 s en modo Match Image
- Asignación de alta fidelidad del movimiento humano del metraje de referencia a un personaje estático
- Compatibilidad nativa para activar o desactivar el audio en cada generación
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: dependen del origen
- Relaciones de aspecto: dependen del origen
Ideal para:
- Reproducir coreografías complejas o movimientos específicos en un personaje personalizado
- Animación de personajes de formato largo que requiere alta fidelidad de movimiento
- Contenido para redes sociales guiado por movimientos de vídeo en tendencia
Coste: Varía según la configuración y la duración seleccionadas
Kling 2.6 Motion Control no está disponible en Estados Unidos.
Kling 3.0 Motion Control
Un modelo especializado para transferir movimiento con precisión basado en la arquitectura Kling 3.0, que te permite animar la imagen de un personaje con un vídeo de referencia para reproducir movimientos, gestos y ángulos de cámara específicos con mayor fidelidad.
Entradas de generación:
- Imagen del personaje (origen)
- Vídeo de movimiento (referencia)
- Descripción de texto (opcional)
Funciones:
- Elige “Match Video” para reproducir el movimiento con exactitud o “Match Image” para añadir movimiento creativo nuevo a un personaje
- Admite hasta 30 s en modo Match Video y 10 s en modo Match Image
- Asignación de alta fidelidad del movimiento humano del metraje de referencia a un personaje estático
- Compatibilidad nativa para activar o desactivar el audio en cada generación
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: dependen del origen
- Relaciones de aspecto: dependen del origen
Ideal para:
- Reproducir coreografías complejas o movimientos específicos en un personaje personalizado
- Animación de personajes de formato largo que requiere alta fidelidad de movimiento
- Contenido para redes sociales guiado por movimientos de vídeo en tendencia
Coste: Varía según la configuración y la duración seleccionadas
Kling 3.0 Motion Control no está disponible en Estados Unidos.
Kling 2.6
Un modelo generativo optimizado diseñado para una mayor fidelidad de movimiento y transiciones más fluidas, que equilibra la iteración rápida con una salida visual de calidad de producción.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial (imagen a vídeo)
Funciones:
- Dinámica de movimiento mejorada: mejoras significativas en la fluidez del movimiento y las interacciones físicas realistas
- Control flexible del sonido: compatibilidad nativa para activar o desactivar el audio en cada generación
- Creación por lotes: genera hasta 4 variaciones simultáneamente
- Perfeccionamiento granular: control creativo avanzado mediante compatibilidad con prompts negativos
- Duraciones fijas: admite duraciones de generación de 5 s y 10 s
Opciones de salida:
- Resoluciones: dependen de la entrada
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Clips de mucha acción que requieren movimiento fluido de personajes
- Contenido profesional para redes sociales con gran fidelidad al prompt
Coste: Varía según la configuración y la duración seleccionadas
Kling 2.6 no está disponible en Estados Unidos.
Kling 2.5
Un modelo equilibrado y versátil para generar vídeos Full HD de alta calidad.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial
Funciones:
- Destaca al simular movimientos complejos y física realista
- Modela con precisión la dinámica de fluidos y las expresiones
- Duraciones fijas: 5 s y 10 s
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1080p
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Simulaciones de física realista y movimiento complejo
Coste: Varía según la configuración y la duración seleccionadas
El fotograma final no es compatible actualmente. No se pueden proporcionar referencias de imagen. El control de sonido no está disponible.
Kling 2.5 no está disponible en Estados Unidos.
Runway Gen-4.5
Calidad de movimiento, fidelidad al prompt y fidelidad visual de última generación para vídeo cinematográfico y altamente realista.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial (imagen a vídeo)
Funciones:
- Calidad de movimiento excepcional con realismo y simulación física líderes en el sector
- Fidelidad superior al prompt para un control creativo preciso de escenas complejas
- Alta fidelidad visual que ofrece resultados de calidad cinematográfica
- Genera hasta 4 variaciones simultáneamente
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: 16:9, 9:16
Ideal para:
- Contenido cinematográfico que requiere la máxima calidad de movimiento y realismo
- Producciones profesionales que exigen fidelidad precisa al prompt
- Narrativa visual de alta fidelidad
Coste: Varía según la configuración y la duración seleccionadas
Runway Gen-4 Turbo
Un modelo de vídeo avanzado diseñado para iteración rápida y creación rentable, capaz de producir vídeos de alta calidad.
Entradas de generación:
- Texto a vídeo
- Fotograma inicial (imagen a vídeo)
Funciones:
- Optimizado para una generación ultrarrápida, ofrece resultados hasta cuatro veces más rápido que las iteraciones anteriores
- Permite dirigir con precisión los movimientos de personajes, ángulos de cámara y composiciones de escena
- Destaca por mantener la coherencia visual y la estabilidad en escenas dinámicas
- Admite duraciones de generación de 2 s a 10 s
- Genera hasta 4 variaciones simultáneamente
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Creación rápida de prototipos y experimentación creativa que requieren comentarios casi instantáneos
- Proyectos profesionales que necesitan entregas rápidas de recursos de marketing en alta resolución
- Contenido cinematográfico con requisitos específicos de movimiento de cámara
Coste: Varía según la configuración y la duración seleccionadas
Runway Gen-4 Aleph
Un modelo de vídeo en contexto de última generación diseñado para la generación visual multitarea, capaz de realizar ediciones complejas mientras mantiene la estructura subyacente del metraje de origen.
Entradas de generación:
- Vídeo de origen
- Imagen de referencia
- Descripción de texto
Funciones:
- Añade, elimina o transforma sin interrupciones objetos y sujetos de una escena con iluminación, sombras y perspectiva naturales
- Cambia ubicaciones, estaciones y momentos del día (por ejemplo, convertir metraje nublado en una puesta de sol espectacular) con actualizaciones realistas de la temperatura de color
- Modifica la edad y apariencia de actores o cambia la textura de ropa y sujetos mediante prompts sencillos en lenguaje natural
- Aplica el movimiento y la trayectoria de cámara específicos de un vídeo de referencia a una imagen estática para controlar la animación con precisión
- Genera ángulos de cámara completamente nuevos, como planos inversos o contrapicados, a partir de una única secuencia de vídeo existente
- Incluye chroma preciso (aislamiento con detección de bordes), generación del siguiente plano para continuar la historia y transferencia de estilo estético
- Genera hasta 4 variaciones simultáneamente
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: automática
Ideal para:
- Tareas profesionales de efectos visuales, como rejuvenecimiento digital, nueva iluminación y eliminación de objetos
- Creación rápida de prototipos cinematográficos y generación de cobertura de cámara alternativa a partir de un único plano
- Contenido creativo de marketing que requiere transformaciones drásticas del entorno o del estilo
Coste: Varía según la configuración y la duración seleccionadas
Runway Aleph 2.0
El modelo de edición de vídeo de Runway: transforma un vídeo existente hacia una apariencia objetivo mientras conserva el movimiento y la coherencia.
Entradas:
- Vídeo de origen (obligatorio, de 2 s a 30 s)
- Imagen de apariencia objetivo (obligatoria)
- Prompt de texto que describe las ediciones
Funciones:
- La duración y el encuadre de salida siguen el vídeo de origen
- Transferencia de estilo guiada por la imagen de apariencia objetivo
- Creación por lotes de hasta 4 generaciones a la vez
Ideal para:
- Cambiar la iluminación, el estilo o el escenario de metraje existente
- Aplicar la apariencia de una imagen de referencia a un clip completo
Coste: Varía según la configuración y la duración seleccionadas
Runway Act-Two
Un modelo especializado de transferencia de interpretaciones que anima personajes mapeando el movimiento, el habla y las expresiones faciales de un vídeo de referencia sobre una imagen o un vídeo de personaje.
Entradas de generación:
- Interpretación de referencia (vídeo)
- Entrada de personaje (imagen o vídeo)
Características:
- Transfiere expresiones faciales matizadas, sincronización labial y audio sincronizado directamente de un actor de referencia a cualquier personaje
- Añade automáticamente movimiento secundario y sutiles temblores de cámara a imágenes estáticas de personajes para lograr un aspecto más natural
- Control preciso para activar o desactivar los movimientos del cuerpo y las manos al usar una imagen de personaje
- Ajustes configurables para equilibrar una interpretación emocional intensa y la coherencia visual del personaje
- Permite cambiar la voz del personaje tras la generación manteniendo una alineación perfecta con la interpretación de referencia
Opciones de salida:
- Resoluciones: 720p
- Relaciones de aspecto: Automática
Ideal para:
- Dar vida a retratos estáticos de personajes con movimiento y habla humanos realistas
- Animar personajes no humanos o avatares estilizados con expresiones de alta fidelidad
- Producir rápidamente contenido de personas hablando a cámara con gestos corporales integrados
Coste: Varía según los ajustes y la duración seleccionados
Seedance 1 Pro
Un modelo especializado para crear secuencias dinámicas de varios planos con mucho movimiento y acción.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
Características:
- Física muy estable y transiciones fluidas entre planos
- Duraciones fijas: 3 s, 4 s, 5 s, 6 s, 7 s, 8 s, 9 s, 10 s, 11 s y 12 s
- Creación por lotes de hasta 4 generaciones a la vez
- Máxima flexibilidad creativa con numerosas opciones de relación de aspecto
Opciones de salida:
- Resoluciones: 480p, 720p, 1080p
- Relaciones de aspecto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativas y escenas de acción que requieren una física estable
Coste: Varía según los ajustes y la duración seleccionados
La relación de aspecto y la resolución no afectan a los créditos de generación, pero la duración sí.
Seedance 1 Pro no está disponible en Estados Unidos.
LTX Audio-to-Video
Un modelo fundacional basado en DiT diseñado para generar vídeo y audio sincronizados en una sola pasada, lo que garantiza un habla coherente y un movimiento realista.
Entradas de generación:
- Texto a Vídeo
- Imagen a Vídeo
- Audio a Vídeo
- Profundidad a Vídeo
Características:
- Genera diálogo, movimiento de labios y audio ambiente simultáneamente para una alineación perfecta sin herramientas externas
- Escenas dinámicas con movimiento estable, identidad coherente y gran coherencia entre fotogramas
- Admite generación sincronizada de alta fidelidad de hasta 20 segundos
- Dirección creativa avanzada mediante compatibilidad detallada con prompts negativos
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: 720p, 1080p
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Habla coherente e interpretaciones expresivas de personajes
- Contenido narrativo que requiere audio ambiente integrado y una sincronización coherente
- Escenas dinámicas con lógica de movimiento compleja que tiene en cuenta la cámara
Coste: Varía según los ajustes y la duración seleccionados
LTX 2 Pro
Un modelo generativo de alta fidelidad optimizado para ofrecer el máximo detalle visual y estabilidad estructural, capaz de producir resultados 4K con calidad de producción y movimiento fluido.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial (Imagen a Vídeo)
Características:
- Prioriza la calidad visual y la coherencia frente a la velocidad, y garantiza resultados estables en secuencias extensas
- Admite tanto 25 FPS como 50 FPS para un movimiento excepcionalmente fluido y profesional
- Generación audiovisual integrada con un control para activar o desactivar el sonido
- Diseñado para gestionar salidas nativas de 1080p, 2k y 4k sin pérdida de detalle
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: 1080p, 2k, 4k
- Velocidades de fotogramas: 25 FPS, 50 FPS
- Relación de aspecto: 16:9 (predeterminada)
- Duraciones: 6 s, 8 s, 10 s
Ideal para:
- Producción cinematográfica de alta resolución que requiere nitidez 4K
- Contenido profesional que necesita movimiento fluido a 50 FPS
- Secuencias detalladas en las que la estabilidad visual y la integridad estructural son fundamentales
Coste: Varía según los ajustes y la duración seleccionados
LTX 2 Retake
Una herramienta de dirección con IA de precisión que permite redirigir de forma específica el diálogo, la emoción y la acción dentro de planos existentes sin romper la continuidad ni regenerar toda la secuencia.
Entradas de generación:
- Vídeo de origen
- Descripción de texto
Características:
- Modifica segmentos específicos y conserva firmemente el contexto de los fotogramas circundantes
- Reformula líneas habladas manteniendo la coherencia de la voz, la interpretación y el entorno del personaje
- Varios modos de edición: selecciona entre “Audio y vídeo”, “Solo audio” o “Solo vídeo” para aislar y regenerar elementos específicos del plano
- El contenido nuevo hereda de forma natural el movimiento, la iluminación y el tono originales para lograr transiciones fluidas
- Experimenta al instante con reacciones alternativas de personajes, momentos emocionales o movimientos de cámara dentro de un mismo plano
- Genera hasta 4 variaciones simultáneamente para compararlas lado a lado
Opciones de salida:
- Relaciones de aspecto: solo 16:9
Ideal para:
- Ajustar guiones y perfeccionar diálogos sin necesidad de repetir tomas ni grabaciones
- Corregir momentos emocionales o problemas de ritmo en posproducción
- Probar varios mensajes de marca y llamadas a la acción en un mismo recurso de marketing
Coste: Varía según los ajustes y la duración seleccionados
LTX 2 Fast
Un modelo generativo optimizado para la velocidad, diseñado para ciclos de feedback cortos y creación de contenido a gran ritmo, que ofrece imágenes de alta resolución con tiempos de renderizado considerablemente reducidos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial (Imagen a Vídeo)
Características:
- Diseñado para la velocidad y la iteración rápida, permite experimentar visualmente con rapidez y obtener previsualizaciones casi instantáneas
- Admite salidas nativas de 1080p, 2k y 4k con menor carga de computación que el modelo Pro
- Compatible con 25 FPS y 50 FPS para un movimiento fluido a gran velocidad
- Permite generar rápidamente contenido audiovisual sincronizado de hasta 20 segundos
- Compatibilidad nativa para activar o desactivar el audio en cada generación
- Genera hasta 4 variaciones simultáneamente
Opciones de salida:
- Resoluciones: 1080p, 2k, 4k
- Velocidades de fotogramas: 25 FPS, 50 FPS
- Relación de aspecto: 16:9 (predeterminada)
- Duraciones: 6 s, 8 s, 10 s, 12 s, 14 s, 16 s, 18 s, 20 s
Ideal para:
- Creación rápida de prototipos y exploración creativa cuando se prioriza la velocidad frente al máximo detalle
- Contenido para redes sociales de gran volumen que requiere entregas rápidas
- Pruebas A/B de distintos conceptos visuales y estilos de movimiento
Coste: Varía según los ajustes y la duración seleccionados
Wan 3.0
Un modelo de vídeo cinematográfico con referencias de imagen, vídeo y audio, audio generado y generaciones de hasta 30 segundos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 10)
- Referencias de vídeo (hasta 5, 15 s en total)
- Referencias de audio (hasta 5, 15 s en total)
Características:
- Los fotogramas y las referencias son mutuamente excluyentes
- Duraciones fijas: 5 s, 10 s, 15 s, 20 s y 30 s
- Control de sonido nativo con audio activado o desactivado en cada generación
- Mejora de prompt opcional
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p, 1080p
- Relaciones de aspecto: Automática, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Planos cinematográficos más largos con gran fidelidad al prompt
- Escenas basadas en referencias con audio
Coste: Varía según los ajustes y la duración seleccionados
Wan 3.0 no está disponible en Estados Unidos.
Wan 3.0 Prime
Una variante más rápida de Wan 3.0 con las mismas entradas y opciones de salida, adecuada para la ideación.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial
- Fotograma final
- Referencias de imagen (hasta 10)
- Referencias de vídeo (hasta 5, 15 s en total)
- Referencias de audio (hasta 5, 15 s en total)
Características:
- Aproximadamente la mitad del tiempo de generación de Wan 3.0
- Duraciones fijas: 5 s, 10 s, 15 s, 20 s y 30 s
- Control de sonido nativo con audio activado o desactivado en cada generación
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p, 1080p
- Relaciones de aspecto: Automática, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Explorar ideas antes del renderizado final con Wan 3.0
- Flujos de trabajo sensibles a los plazos de entrega
Coste: Varía según los ajustes y la duración seleccionados
Wan 3.0 Prime no está disponible en Estados Unidos.
Wan 2.6
Una plataforma de vídeo cinematográfico de nueva generación que utiliza una arquitectura multimodal unificada para ofrecer contenido 1080p listo para producción con sincronización de audio nativa y secuenciación inteligente de varios planos.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial (Imagen a Vídeo)
- Referencia de vídeo (Vídeo a Vídeo)
- Referencia de audio (audio de fondo o diálogo opcional)
Características:
- Sistema multimodal unificado: procesa texto, imágenes, vídeo y audio mediante un único marco integrado para ofrecer una calidad de salida coherente
- Sincronización de audio nativa: genera y alinea automáticamente diálogos, narración y efectos de sonido ambientales con el movimiento en pantalla
- Secuenciación inteligente de varios planos: organiza automáticamente secuencias de vídeo conectadas en arcos narrativos coherentes y mantiene la coherencia de los personajes
- Duraciones ampliadas: admite una generación estable y de alta calidad con duraciones fijas de 5 s, 10 s y 15 s
- Control creativo avanzado: admite prompts negativos para gestionar los detalles con precisión y la creación por lotes de hasta 4 variaciones
Opciones de salida:
- Resoluciones: 720p, 1080p
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Narrativa profesional y secuencias cinematográficas complejas de varios planos
- Anuncios en redes sociales y contenido de marketing que requiere audio integrado de alta fidelidad
- Contenido centrado en personajes que requiere estricta coherencia visual y de movimiento mediante referencias de vídeo
Coste: Varía según los ajustes y la duración seleccionados
Wan 2.6 no está disponible en Estados Unidos.
Wan 2.5 Video
Un modelo versátil que ofrece movimiento cinematográfico y gran fidelidad al prompt a partir de texto o una imagen inicial.
Entradas de generación:
- Texto a Vídeo
- Fotograma inicial (Imagen a Vídeo)
Características:
- Control creativo detallado con prompts negativos y control de sonido específico
- Duraciones fijas: 5 s y 10 s
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p, 1080p
- Relaciones de aspecto: 16:9, 1:1, 9:16
Ideal para:
- Contenido cinematográfico con gran fidelidad al prompt
Coste: Varía según los ajustes y la duración seleccionados
El coste de generación varía según los ajustes seleccionados.
Wan 2.5 Video no está disponible en Estados Unidos.
Modelos generativos de imagen
GPT Image 2.5 Sunburst
El modelo de imagen de OpenAI listo para producción, para resultados muy detallados y edición precisa.
Entradas de generación:
- Texto a Imagen
- Referencias de imagen (hasta 10)
Características:
- Cinco niveles de calidad, de baja a máxima
- Resolución personalizada de hasta 3840 px por lado, con relaciones de aspecto de hasta 3:1
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K, 4K o personalizada
- Relaciones de aspecto: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideal para:
- Recursos finales en los que el detalle y la fidelidad son esenciales
- Ediciones precisas de imágenes existentes
Coste: Varía según los ajustes seleccionados y el número de variaciones
GPT Image 2.5 Flare
Una variante rápida de GPT Image 2.5 con los mismos controles que Sunburst, optimizada para la generación cotidiana de gran volumen.
Entradas de generación:
- Texto a Imagen
- Referencias de imagen (hasta 10)
Características:
- Cinco niveles de calidad, de baja a máxima
- Resolución personalizada de hasta 3840 px por lado, con relaciones de aspecto de hasta 3:1
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K, 4K o personalizada
- Relaciones de aspecto: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideal para:
- Generación de imágenes de gran volumen
- Iteraciones rápidas que siguen necesitando 4K y tamaños personalizados
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: gpt-image-2.5-flare
GPT Image 2
Un modelo de IA avanzado diseñado para generar imágenes con precisión, con renderizado de texto mejorado y capacidades de salida de alta resolución.
Características:
- Control preciso del texto para crear imágenes con tipografía y claridad exactas
- Salida PNG de alta resolución adecuada para uso profesional y comercial
- Admite varias referencias de imagen para guiar el estilo y la composición
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 3:2, 1:1, 2:3
- Opciones de calidad: baja, media, alta
Ideal para:
- Recursos visuales de marketing y diseño que requieren una colocación precisa del texto
- Contenido profesional con requisitos de alta resolución
- Proyectos creativos que necesitan un control preciso de las imágenes basadas en texto
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: gpt-image-2
Nano Banana 2.1
Un modelo de imagen con salida 4K nativa y hasta 14 referencias de imagen.
Entradas de generación:
- Texto a Imagen
- Referencias de imagen (hasta 14)
Opciones de salida:
- Resoluciones: 4K
- Relaciones de aspecto: de 8:1 a 1:8 y automática
Ideal para:
- Imágenes guiadas por referencias que necesitan 4K nativo
Coste: Varía según los ajustes seleccionados y el número de variaciones
Nano Banana 2
Un modelo avanzado de generación de imágenes con IA que combina calidad lista para producción con procesamiento ultrarrápido, además de un mejor conocimiento del mundo y coherencia de los sujetos.
Características:
- Salida con resolución 4K nativa sin escalado para un detalle nítido
- Generación de imágenes ultrarrápida en tan solo 1-2 segundos
- Fidelidad superior al prompt mediante razonamiento avanzado y seguimiento de instrucciones
- Renderizado de texto nítido y preciso en varios idiomas para maquetas, señalética e infografías
- Estilo coherente para varios sujetos que conserva la identidad entre distintos personajes y objetos
- Mejor conocimiento del mundo para generar escenas más precisas
- Admite varias referencias de imagen para guiar la generación
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Resoluciones: hasta 4K
Ideal para:
- Flujos de trabajo creativos rápidos que requieren iteración en tiempo real
- Contenido de marca y narrativa con una identidad de personaje coherente
- Recursos visuales profesionales con texto y tipografía precisos
Coste: Varía según los ajustes seleccionados y el número de variaciones
Nano Banana 2 Lite
Una variante rápida y económica de Nano Banana 2 para generar y editar rápidamente en 1K.
Entradas de generación:
- Texto a Imagen
- Referencias de imagen (hasta 14)
Características:
- Salida fija de 1K para mantener una velocidad y un coste constantes
- La misma capacidad de 14 referencias de imagen que Nano Banana 2
- Creación por lotes de hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K
- Relaciones de aspecto: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Iteraciones rápidas y borradores
- Ediciones en masa para las que 1K es suficiente
Coste: Varía según los ajustes seleccionados y el número de variaciones
Krea 2 Medium
Un modelo versátil de generación de imágenes de Krea AI listo para producción, que equilibra calidad y velocidad para una amplia variedad de flujos de trabajo creativos.
Características:
- Generación de imágenes de alta fidelidad con gran fidelidad al prompt
- Admite varias referencias de imagen para guiar la generación
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Creación de contenido profesional que requiere una calidad coherente
- Iteración rápida entre diversos conceptos creativos
Coste: Varía según los ajustes seleccionados y el número de variaciones
Krea 2 Large
El modelo insignia de generación de imágenes de Krea AI, que ofrece máxima fidelidad visual y control creativo avanzado para flujos de trabajo de producción profesionales.
Características:
- Detalle y realismo excepcionales para resultados de nivel profesional
- Control de estilo avanzado compatible con múltiples imágenes de referencia
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Producción comercial y editorial de imágenes de alta gama
- Composiciones creativas complejas que requieren la máxima fidelidad
Coste: Varía según los ajustes seleccionados y el número de variaciones
Recraft V4.1
Un modelo de texto a imagen centrado en el diseño, con un gran control de los prompts y composiciones limpias.
Entradas de generación:
- Texto a imagen
Características:
- La salida en 2K utiliza la variante de modelo Pro
- Creación por lotes con hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K
- Relaciones de aspecto: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideal para:
- Gráficos, iconos y carteles basados en la composición
- Composiciones limpias creadas solo a partir de texto
Coste: Varía según los ajustes seleccionados y el número de variaciones
Recraft V4.1 Flash
Un modelo rápido de texto a imagen centrado en el diseño.
Entradas de generación:
- Texto a imagen
Opciones de salida:
- Relaciones de aspecto: 16 proporciones
Ideal para:
- Gráficos basados en la composición creados solo a partir de texto
Coste: Varía según los ajustes seleccionados y el número de variaciones
Recraft V4
Un modelo de imágenes centrado en el diseño que puede reproducir el estilo de imágenes de referencia.
Entradas de generación:
- Texto a imagen
- Referencias de estilo (hasta 10)
Características:
- Control de coincidencia de estilo: Preciso sigue de cerca el estilo de referencia; Flexible reproduce el aspecto general
- La salida en 2K utiliza la variante de modelo Pro
- Creación por lotes con hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K
- Relaciones de aspecto: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideal para:
- Gráficos coherentes con la marca a partir de un conjunto de referencias de estilo
- Trabajos de ilustración y diseño
Coste: Varía según los ajustes seleccionados y el número de variaciones
Seedream 5 Lite
Un modelo de imágenes ligero y de generación rápida de ByteDance que ofrece resultados de alta calidad con menos requisitos de computación.
Características:
- Generación rápida para iterar con agilidad en el proceso creativo
- Admite múltiples imágenes de referencia para orientar la generación
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Flujos de trabajo de creación de imágenes de gran volumen que requieren velocidad
- Exploración rápida de conceptos y vistas previas
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: bytedance-seedream-5-lite
Seedream 5 Lite no está disponible en Estados Unidos.
Seedream 5 Pro
La variante de Seedream 5 de mayor fidelidad para edición precisa, texto multilingüe e infografías densas.
Entradas de generación:
- Texto a imagen
- Referencias de imágenes (hasta 10)
Características:
- Representación precisa de texto multilingüe
- Gestiona diseños densos como infografías y carteles
- Creación por lotes con hasta 4 generaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Diseños con mucho texto en varios idiomas
- Edición de varias imágenes con una estricta adhesión a las referencias
Coste: Varía según los ajustes seleccionados y el número de variaciones
Seedream 5 Pro no está disponible en Estados Unidos.
GPT Image 1.5
Un modelo insignia de alta velocidad diseñado para la generación precisa de imágenes a partir de texto y la edición fotográfica compleja y no destructiva que conserva los detalles originales.
Características:
- Ejecuta de forma fiable los cambios solicitados mientras mantiene la integridad de la iluminación, la composición y el aspecto del sujeto en las imágenes de origen
- Admite tareas de edición complejas, como añadir, eliminar, combinar y fusionar elementos
- Ofrece resultados hasta 4 veces más rápidos que las iteraciones anteriores
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 3:2, 1:1, 2:3
- Opciones de calidad: baja, media, alta
Ideal para:
- Ajustes fotográficos prácticos y pruebas virtuales realistas de ropa o peinados
- Transformaciones conceptuales y filtros estilísticos que conservan la esencia de la imagen de entrada
- Iteración rápida de conceptos de texto a imagen
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: gpt-image-1.5
GPT Image 1
El modelo de imágenes de primera generación de OpenAI, con buena adherencia a los prompts, texto legible y edición detallada.
Entradas de generación:
- Texto a imagen
- Referencias de imágenes (hasta 5)
Características:
- Tres niveles de calidad: baja, media, alta
- Creación por lotes con hasta 4 generaciones a la vez
Opciones de salida:
- Relaciones de aspecto: 3:2, 1:1, 2:3
Ideal para:
- Flujos de trabajo ya basados en la salida de GPT Image 1
- Ediciones sencillas y tareas de texto en imagen con resolución estándar
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: gpt-image-1
Seedream 4.5
Un modelo fundacional multimodal de alto rendimiento que unifica la síntesis de texto a imagen, la edición precisa de imágenes y la composición compleja de varias imágenes en un único marco eficiente.
Características:
- Compatibilidad nativa con la generación rápida de imágenes de alta fidelidad de hasta resolución 4K
- Conservación excepcional de los rasgos faciales, la iluminación, el tono de color y los detalles finos durante tareas de edición basadas en referencias
- Identifica y combina con precisión elementos objetivo entre varias imágenes de entrada para obtener resultados controlables y coherentes
- Ofrece capacidades de composición de nivel de diseño con representación clara y precisa de texto pequeño para carteles y elementos visuales de marca
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluciones: 2K, 4K
Ideal para:
- Flujos de trabajo de diseño gráfico profesional que requieren una composición y tipografía precisas
- Edición fotográfica compleja que necesita una estricta adhesión a la identidad y la iluminación de referencia
- Composición creativa de alta resolución a partir de múltiples fuentes visuales
Coste: Varía según los ajustes seleccionados y el número de variaciones
Seedream 4.5 no está disponible en Estados Unidos.
Kling O1 Image
Un modelo de generación de imágenes de alta fidelidad con capacidades de razonamiento avanzadas, diseñado para una adherencia superior a los prompts y una coherencia visual precisa en composiciones complejas.
Características:
- Capacidad excepcional para interpretar y ejecutar descripciones de texto complejas y con varias capas con gran precisión
- Aprovecha referencias de imágenes para mantener la identidad del sujeto, la iluminación y el estilo estético entre generaciones
- Optimizado para texturas realistas, relaciones espaciales complejas y efectos de iluminación de nivel profesional
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: Automática, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Resoluciones: 1K, 2K
Ideal para:
- Recursos creativos profesionales que requieren una estricta adherencia a prompts de texto detallados y técnicos
- Edición de imágenes y diseño de personajes de gran coherencia mediante referencias visuales
Coste: Varía según los ajustes seleccionados y el número de variaciones
Kling O1 Image no está disponible en Estados Unidos.
FLUX.2 [Pro]
Un modelo de generación y edición de imágenes preparado para producción, diseñado para flujos de trabajo profesionales, que ofrece una calidad visual de vanguardia centrada en la velocidad, la precisión y la coherencia.
Características:
- Usa varias imágenes de referencia simultáneamente para lograr una coherencia de personajes e identidad líder en el sector en cientos de recursos
- Ofrece un avance sin precedentes en la calidad de detalle, acercándose a la fotografía real en todo, desde texturas de telas hasta elementos arquitectónicos
- Proporciona representación de texto lista para producción para tipografías complejas, maquetas de interfaz e infografías
- Admite la especificación precisa de colores de marca mediante códigos hexadecimales, sin aproximaciones
- Garantiza un posicionamiento preciso de los objetos, física realista, iluminación coherente y perspectiva correcta en escenas complejas
- Optimizado para mejorar la precisión y la respuesta a instrucciones estructuradas y complejas
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluciones: 720p, 1080p, 2K
Ideal para:
- Ejecutar campañas con personajes coherentes y situar productos con precisión en cualquier contexto
- Crear maquetas de interfaces con texto legible y sistemas de diseño visual coherentes
- Generar fotografía de producto a escala y fotografías contextuales de estilo de vida
Coste: Varía según los ajustes seleccionados y el número de variaciones
Nano Banana Pro
Un modelo profesional de generación y edición de imágenes basado en razonamiento, diseñado para producir recursos de alta fidelidad, ofrecer control creativo avanzado y seguir instrucciones con precisión.
Entradas:
- Referencia de imagen
- Descripción de texto (admite prompts complejos y con varias capas)
Características:
- Planifica las escenas antes de renderizarlas para ofrecer iluminación físicamente precisa, relaciones exactas entre objetos y una adherencia superior a los prompts
- Genera texto multilingüe nítido y legible en diversos estilos tipográficos y de escritura a mano para carteles y maquetas de producto impactantes
- Mantiene una alta fidelidad y parecido para hasta 5 personas y múltiples objetos en diversas creaciones
- Integra Google Search para mejorar los elementos visuales con datos reales, conocimiento del mundo real e información en tiempo real, como el tiempo o los deportes
- Ajusta ángulos de cámara, puntos focales e iluminación de la escena (por ejemplo, transforma el día en noche) con herramientas avanzadas de edición localizada
- Su comprensión espacial superior permite generar infografías precisas, diagramas técnicos y diapositivas de presentación
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: 1K, 2K, 4K
- Relaciones de aspecto: Automática, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Publicidad profesional, recursos de marca y fotografía de productos de comercio electrónico de alta gama
- Explicaciones educativas, infografías basadas en datos y documentación técnica compleja
- Creación rápida de prototipos de diseños visuales de alta resolución con identidad coherente de personaje o marca
Coste: Varía según los ajustes seleccionados y el número de variaciones
API: gemini-3-pro-image
Nano Banana
Un modelo de alta velocidad para generar y editar imágenes de forma rápida y con gran calidad directamente a partir de prompts de texto.
Características:
- Admite múltiples imágenes de referencia para orientar la generación
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideal para:
- Creación e iteración rápidas de imágenes
Coste: Varía según los ajustes seleccionados y el número de variaciones
Runway Gen-4 Image
Un modelo base avanzado diseñado para la generación de imágenes de alta fidelidad, que ofrece un control estilístico sin precedentes y memoria visual para mantener la coherencia entre escenas.
Características:
- Fija personajes, estilos u objetos específicos mediante imágenes de entrada para mantener una coherencia de nivel profesional entre múltiples resultados
- Optimizado para interpretar descripciones complejas en lenguaje natural y controlar con precisión los detalles visuales, la iluminación y las emociones
- Capaz de generar elementos visuales de alta calidad para diversos casos de uso, desde guiones gráficos cinematográficos hasta fotografía de producto profesional
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluciones: 720p, 1080p
Ideal para:
- Garantizar que los protagonistas mantengan su aspecto en distintos entornos y tratamientos de iluminación
- Producir rápidamente recursos de marca de alta resolución, pruebas virtuales y visualizaciones de productos listas para escalar
- Explorar diversas direcciones artísticas mientras se fija la identidad visual principal mediante referencias de imágenes
Coste: Varía según los ajustes seleccionados y el número de variaciones
Runway Gen-4 Image Turbo
Un modelo optimizado de generación de imágenes diseñado para la velocidad, que ofrece resultados 2,5 veces más rápidos que el Gen-4 Image estándar manteniendo una calidad de salida idéntica.
Características:
- El procesamiento optimizado permite una exploración creativa rápida y genera imágenes de alta fidelidad en una fracción del tiempo
- Sube hasta tres imágenes de referencia para orientar la comprensión del modelo sobre personajes, entornos y estilos artísticos específicos
- Resuelve el problema de la deriva visual codificando características visuales específicas de las imágenes de referencia para mantener la identidad entre varias generaciones
- Aplica fácilmente la estética, iluminación y textura de una imagen de referencia a sujetos y escenas completamente nuevos
- Utiliza parámetros seed para explorar variaciones de forma sistemática o recrear resultados específicos con precisión
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
- Resoluciones: 720p, 1080p
Ideal para:
- Producir rápidamente elementos visuales optimizados para la plataforma a escala, para Instagram Stories (9:16) o publicaciones estándar (1:1)
- Mantener una identidad visual estricta en todas las campañas usando guías de estilo de marca como imágenes de referencia
- Desarrollar poses y entornos de personajes coherentes mientras se garantiza que el protagonista siga siendo reconocible
- Crear con precisión fotografías diversas de productos de estilo de vida y de temporada mediante orientación basada en referencias
Coste: Varía según los ajustes seleccionados y el número de variaciones
Seedream 4
Un modelo de imágenes especializado en generar secuencias de varios planos o escenas con mucho movimiento y acción.
Características:
- Destaca al crear imágenes con física estable y transiciones coherentes
- Admite múltiples imágenes de referencia para orientar la generación
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: automática, 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Escenas de acción y composiciones dinámicas
Coste: Varía según los ajustes seleccionados y el número de variaciones
Seedream 4 no está disponible en Estados Unidos.
Wan 2.5 Image
La variante de imágenes de Wan 2.5, con gran fidelidad a los prompts y compatibilidad con imágenes de referencia.
Entradas de generación:
- Texto a imagen
- Referencias de imágenes (hasta 2)
Características:
- Controles de prompt negativo y seed
- Creación por lotes con hasta 4 generaciones a la vez
Opciones de salida:
- Relaciones de aspecto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideal para:
- Imágenes fijas que coinciden con el aspecto de las generaciones de vídeo de Wan
- Imágenes conceptuales fieles al prompt
Coste: Varía según los ajustes seleccionados y el número de variaciones
Wan 2.5 Image no está disponible en Estados Unidos.
FLUX 3 Image
Un modelo de imágenes con hasta 10 referencias de imágenes y salida en 4K.
Entradas de generación:
- Texto a imagen
- Referencias de imágenes (hasta 10)
Opciones de salida:
- Resoluciones: 4K
- Relaciones de aspecto: 16 proporciones
Ideal para:
- Imágenes guiadas por referencias en 4K
Coste: Varía según los ajustes seleccionados y el número de variaciones
FLUX.1 Kontext [Pro]
Un modelo profesional para la generación y edición avanzadas de imágenes, con gran coherencia de escena y control de estilo.
Características:
- Control de estilo basado en imágenes que requiere una imagen de referencia para orientar la estética visual
- Genera hasta 4 imágenes a la vez
Opciones de salida:
- Relaciones de aspecto: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Ideal para:
- Contenido profesional con requisitos de estilo precisos
Coste: Varía según los ajustes seleccionados y el número de variaciones
Modelos de sincronización labial
Creatify Aurora
Un modelo transformador de difusión (DiT) de vanguardia diseñado para renderizar avatares ultrarrealistas y reactivos, guiados por audio y texto.
Entradas de generación:
- Avatar (imagen de origen)
- Voz (archivo de audio)
- Descripción de texto (guía)
Características:
- Va más allá de la sincronización labial básica e incluye parpadeos, respiración y expresiones faciales naturales que tienen en cuenta el contexto
- Sincroniza automáticamente los movimientos de manos y de todo el cuerpo según el tono y la inflexión de la voz para lograr una interpretación de calidad de estudio
- Interpreta con precisión la intensidad y el tono de la voz para ofrecer expresiones emocionales fieles a la interpretación
- Mantiene una alta fidelidad del personaje y coherencia de comportamiento incluso en diálogos prolongados o interpretaciones musicales
- Optimizado para distintas configuraciones, como presentaciones en ángulo lateral, diálogos estilo pódcast y animaciones estilizadas
- Genera hasta 4 variaciones a la vez
Opciones de salida:
- Resoluciones: 480p, 720p
Ideal para:
- Anuncios de vídeo profesionales basados en avatares y contenido de marketing
- Narrativa virtual de alta fidelidad e interpretaciones musicales expresivas
- Vídeos educativos o de formación de larga duración que requieren una presencia de personaje coherente
Coste: Varía según la entrada, la configuración y la duración
API: creatify-aurora
Veed Fabric
Un modelo rápido y preciso de sincronización labial de imagen a vídeo que anima una imagen estática para ajustarla al audio proporcionado.
Entradas:
- Imagen de origen
- Archivo de audio de voz
Características:
- Anima la boca y las expresiones faciales de la imagen de origen para que coincidan con el audio proporcionado
- Crea vídeo de alta fidelidad de imágenes estáticas que parecen «hablar»
- Herramienta específica de sincronización labial, no un modelo completo de generación de vídeo
Ideal para:
- Crear avatares que hablan a partir de imágenes estáticas
- Añadir diálogo a retratos de personajes
- Flujos de trabajo profesionales de contenido basado en avatares
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, la imagen debe contener una figura detectable.
HeyGen Avatar 4
El último modelo de avatar de HeyGen para generar vídeos de bustos parlantes muy realistas y expresivos a partir de una sola imagen y una entrada de audio.
Entradas:
- Imagen de origen
- Archivo de audio de voz
Características:
- Anima las expresiones faciales y los movimientos de los labios para que coincidan con el audio proporcionado con alta fidelidad
- Produce movimientos naturales de la cabeza y microexpresiones sutiles para lograr resultados realistas
- Herramienta específica de sincronización labial, no un modelo completo de generación de vídeo
Ideal para:
- Vídeos profesionales de portavoces y presentadores
- Crear contenido de avatar personalizado a escala
- Vídeos de marketing y formación con una presencia de personaje coherente
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, la imagen debe contener un rostro claramente visible.
Sync 3
El modelo de sincronización labial de vídeo de última generación de Sync, que ofrece sincronización de calidad de estudio para una amplia variedad de tipos de contenido.
Entradas de generación:
- Vídeo de origen
- Audio de voz
Características:
- Sincronización labial de alta precisión que preserva detalles faciales únicos, dientes naturales y textura de la piel
- Optimizado para todo tipo de contenido, incluidos vídeo de acción real, animación 3D y vídeo generado con IA
- Herramienta de sincronización labial de vídeo a vídeo, no un generador de vídeo completo
Ideal para:
- Doblaje y localización profesionales para cine y publicidad
- Mejorar o corregir diálogos en cualquier formato de vídeo
- Flujos de trabajo de traducción de contenido de gran volumen
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, el vídeo debe contener una figura detectable.
Sync Lipsync 2 Pro
Un modelo de edición de vídeo de vanguardia diseñado para sincronización labial de calidad de estudio que conserva detalles faciales únicos y permite generar resultados en alta resolución.
Entradas de generación:
- Vídeo de origen
- Audio de voz
Características:
- Incorpora escalado avanzado para admitir salida en 4K y mantener texturas nítidas y naturales
- Protege rasgos faciales únicos, como dientes naturales, pecas, maquillaje y vello facial complejo, sin perder claridad
- Optimizado para funcionar con todo tipo de contenido, incluidos vídeo de acción real, animación 3D y vídeo generado con IA
- Ofrece resultados expresivos y sincronizados de inmediato, sin necesidad de entrenamiento específico para cada hablante ni de ajuste fino del modelo
- Genera hasta 4 variaciones simultáneamente
Ideal para:
- Doblaje de calidad profesional y contenido localizado para cine y publicidad de alto nivel
- Mejorar o corregir diálogos en personajes animados en 3D y generados con IA
- Proyectos en alta resolución que requieren una coherencia y un detalle facial perfectos píxel a píxel
Coste: Varía según la entrada, la configuración y la duración
OmniHuman 1.5
Un modelo de utilidad específico para generar sincronización labial excepcionalmente realista y humana.
Entradas:
- Imagen de origen estática
- Archivo de audio de voz
Características:
- Anima la boca de la imagen de origen para que coincida con el audio proporcionado
- Crea vídeo de alta fidelidad de imágenes estáticas que parecen «hablar»
- Herramienta específica de sincronización labial, no un modelo completo de generación de vídeo
Ideal para:
- Crear avatares que hablan
- Añadir diálogo a imágenes estáticas
- Flujos de trabajo de doblaje profesionales
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, la imagen debe contener una figura detectable.
OmniHuman 1.5 no está disponible en Estados Unidos.
MiniMax H3 Max Lip Sync
Anima una imagen estática a partir de un clip de voz, con salida de hasta 2K.
Entradas:
- Imagen de origen
- Audio de voz (de 5 s a 14,8 s)
Características:
- Herramienta específica de sincronización labial, no un modelo completo de generación de vídeo
Ideal para:
- Retratos que hablan a partir de una imagen estática y un clip de audio corto
Coste: Varía según la entrada, la configuración y la duración
Veed Lipsync
Un modelo de utilidad rápido, asequible y preciso para aplicar sincronización labial realista a vídeos.
Entradas:
- Vídeo de origen
- Nuevo archivo de audio de voz
Características:
- Vuelve a animar los movimientos de la boca del vídeo de origen para que coincidan con el nuevo audio
- Herramienta de sincronización labial de vídeo a vídeo, no un generador de vídeo completo
Ideal para:
- Doblaje de gran volumen y rentable
- Traducir contenido
- Corregir el audio de clips de vídeo con resultados realistas
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, el vídeo debe contener una figura detectable.
Veed Lipsync 2.0
El sucesor de mayor calidad de Veed Lipsync para aplicar sincronización labial realista a vídeos existentes.
Entradas:
- Vídeo de origen
- Nuevo archivo de audio de voz
Características:
- Vuelve a animar los movimientos de la boca del vídeo de origen para que coincidan con el nuevo audio
- Herramienta de sincronización labial de vídeo a vídeo, no un generador de vídeo completo
- Creación por lotes con hasta 4 generaciones a la vez
Ideal para:
- Doblaje y traducción cuando la calidad de salida importa más que el coste
- Corregir diálogos en clips terminados
Coste: Varía según la entrada, la configuración y la duración
Para obtener los mejores resultados, el vídeo debe contener una figura detectable.
Modelos de utilidad
Topaz Image Upscale
Aumenta la resolución de una imagen y conserva los detalles.
Entradas:
- Imagen de origen
Características:
- Factores de escalado: 1.25x, 1.5x, 2x, 3x, 4x
Ideal para:
- Preparar imágenes para pantallas de alta resolución
Coste: Varía según la entrada
Topaz Video Upscale
Aumenta la resolución de un vídeo y conserva los detalles.
Entradas:
- Vídeo de origen
Características:
- Factores de escalado: 1.25x, 1.5x, 2x, 3x, 4x
- Modos de procesamiento rápidos y precisos
- Conversión opcional de la velocidad de fotogramas a 24, 25, 30, 48, 50 o 60 fps
Ideal para:
- Preparar vídeo para pantallas de alta resolución
Coste: Varía según la entrada
Eliminación de fondo
Elimina el fondo de una imagen y la devuelve con transparencia alfa.
Entradas:
- Imagen de origen
Características:
- No requiere prompt
- Una sola salida por ejecución
Ideal para:
- Recortes de productos y composición
- Preparar sujetos para usarlos como referencias en otras generaciones
Coste: Varía según la entrada
Eliminación de fondo de vídeo
Elimina el fondo de un vídeo.
Entradas:
- Vídeo de origen
Características:
- No requiere prompt
- El fondo de salida puede ser transparente, negro o verde
Ideal para:
- Recortar un sujeto de material existente
- Preparar vídeo para composición
Coste: Varía según la entrada
Runway Ruby
Convierte vídeo de rango dinámico estándar en HDR.
Entradas:
- Vídeo de origen (hasta 30 s)
Características:
- No requiere prompt
- Una sola salida por ejecución; la duración y el encuadre siguen los del original
Ideal para:
- Preparar material para pantallas HDR
- Reajustar el color del vídeo generado para la entrega
Coste: Varía según la duración del vídeo
Preguntas frecuentes
|
|