

अपना मॉडल इंटीग्रेट करें
अपने LLM से एजेंट कनेक्ट करें या अपना सर्वर होस्ट करें।
Custom LLM आपको एक्सटर्नल एंडपॉइंट के ज़रिए अपनी बातचीत को अपने LLM से कनेक्ट करने देता है। ElevenLabs नेटिव रूप से इंटीग्रेट किए गए LLMs का भी समर्थन करता है
Custom LLMs से आप अपनी OpenAI API कुंजी इस्तेमाल कर सकते हैं या पूरी तरह कस्टम LLM सर्वर चला सकते हैं।
किसी Custom LLM को Realtime मॉडल के साथ इस्तेमाल नहीं किया जा सकता।
अवलोकन
डिफ़ॉल्ट रूप से, हम OpenAI जैसे लोकप्रिय मॉडलों के लिए अपने आंतरिक क्रेडेंशियल्स इस्तेमाल करते हैं। Custom LLM सर्वर इस्तेमाल करने के लिए, उसे इनमें से किसी एक OpenAI-संगत अनुरोध/जवाब संरचना के अनुरूप होना चाहिए:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Responses API, OpenAI का नया API फ़ॉर्मैट है जो अतिरिक्त सुविधाओं का समर्थन करता है। Custom LLM इंटीग्रेशन के लिए दोनों API फ़ॉर्मैट पूरी तरह समर्थित हैं।
नीचे दिए गए गाइड दोनों उपयोग के मामले कवर करते हैं:
- अपनी OpenAI कुंजी इस्तेमाल करें: हमारे प्लेटफ़ॉर्म के साथ अपनी OpenAI API कुंजी इस्तेमाल करें।
- Custom LLM सर्वर: अपना LLM सर्वर इम्प्लीमेंटेशन होस्ट और कनेक्ट करें।
आप सीखेंगे कि कैसे:
- अपनी OpenAI API कुंजी ElevenLabs में स्टोर करें
- ऐसा सर्वर होस्ट करें जो OpenAI के Chat Completions या Responses एंडपॉइंट की नकल करता हो
- ElevenLabs को अपने कस्टम एंडपॉइंट पर भेजें
- ज़रूरत के अनुसार अपने LLM को अतिरिक्त पैरामीटर्स भेजें
रीजनिंग सारांश
आपके एंडपॉइंट को अंतिम जवाब से अलग रीजनिंग लौटानी चाहिए। ElevenLabs अंतिम जवाब से रीजनिंग जनरेट नहीं करता।
समर्थित एंडपॉइंट से रीजनिंग पाने के लिए, एजेंट की LLM सेटिंग्स में Reasoning summary चालू करें या API के ज़रिए enable_reasoning_summary सेट करें।
रीजनिंग लौटाएँ
अपने एंडपॉइंट के अनुरूप फ़ॉर्मैट इस्तेमाल करें:
Chat Completions API
Responses API
हर रिस्पॉन्स डेल्टा के reasoning या reasoning_content फ़ील्ड में रीजनिंग स्ट्रीम करें।
Gemini-संगत एंडपॉइंट के लिए, ElevenLabs google.thinking_config.include_thoughts के साथ विचारों का अनुरोध करता है और extra_content.google.thought से चिह्नित कंटेंट पढ़ता है।
स्टोरेज, डिलीवरी और सीमाओं के लिए रीजनिंग सारांश देखें।
अपनी OpenAI कुंजी इस्तेमाल करना
Custom OpenAI कुंजी इंटीग्रेट करने के लिए, ElevenLabs डैशबोर्ड में अपनी एजेंट सेटिंग्स अपडेट करें ताकि वे आपके Custom LLM सर्वर की ओर जाएँ और अपनी OPENAI_API_KEY वाली एक सीक्रेट बनाएँ:
ElevenLabs डैशबोर्ड में अपनी Agent सेटिंग्स में, दाईं ओर “LLM” ड्रॉपडाउन मेनू से “Custom LLM” चुनें।
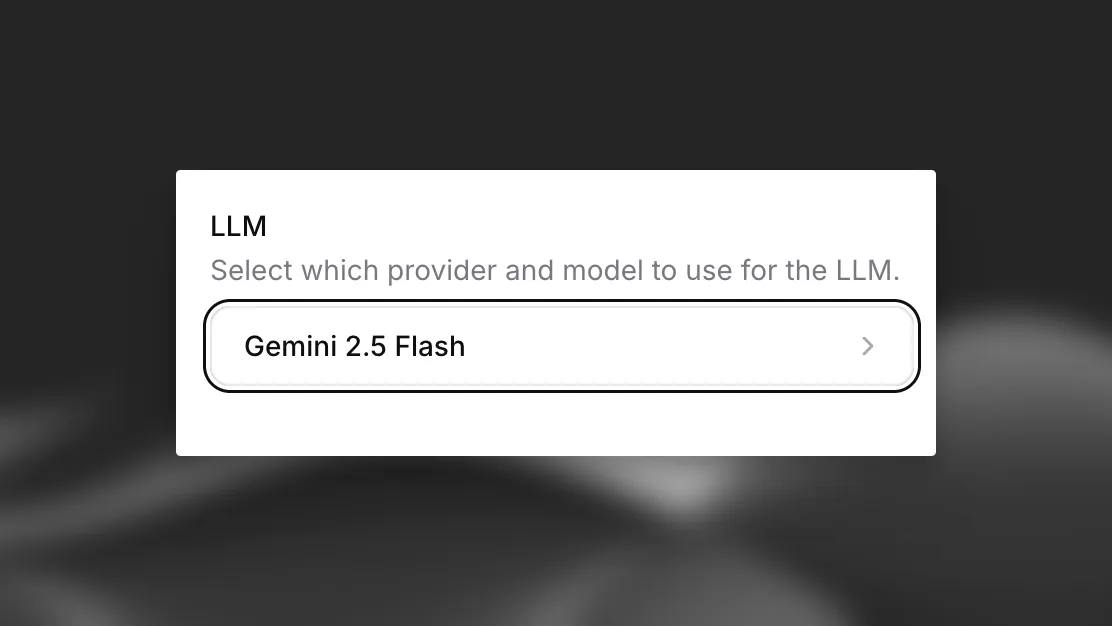
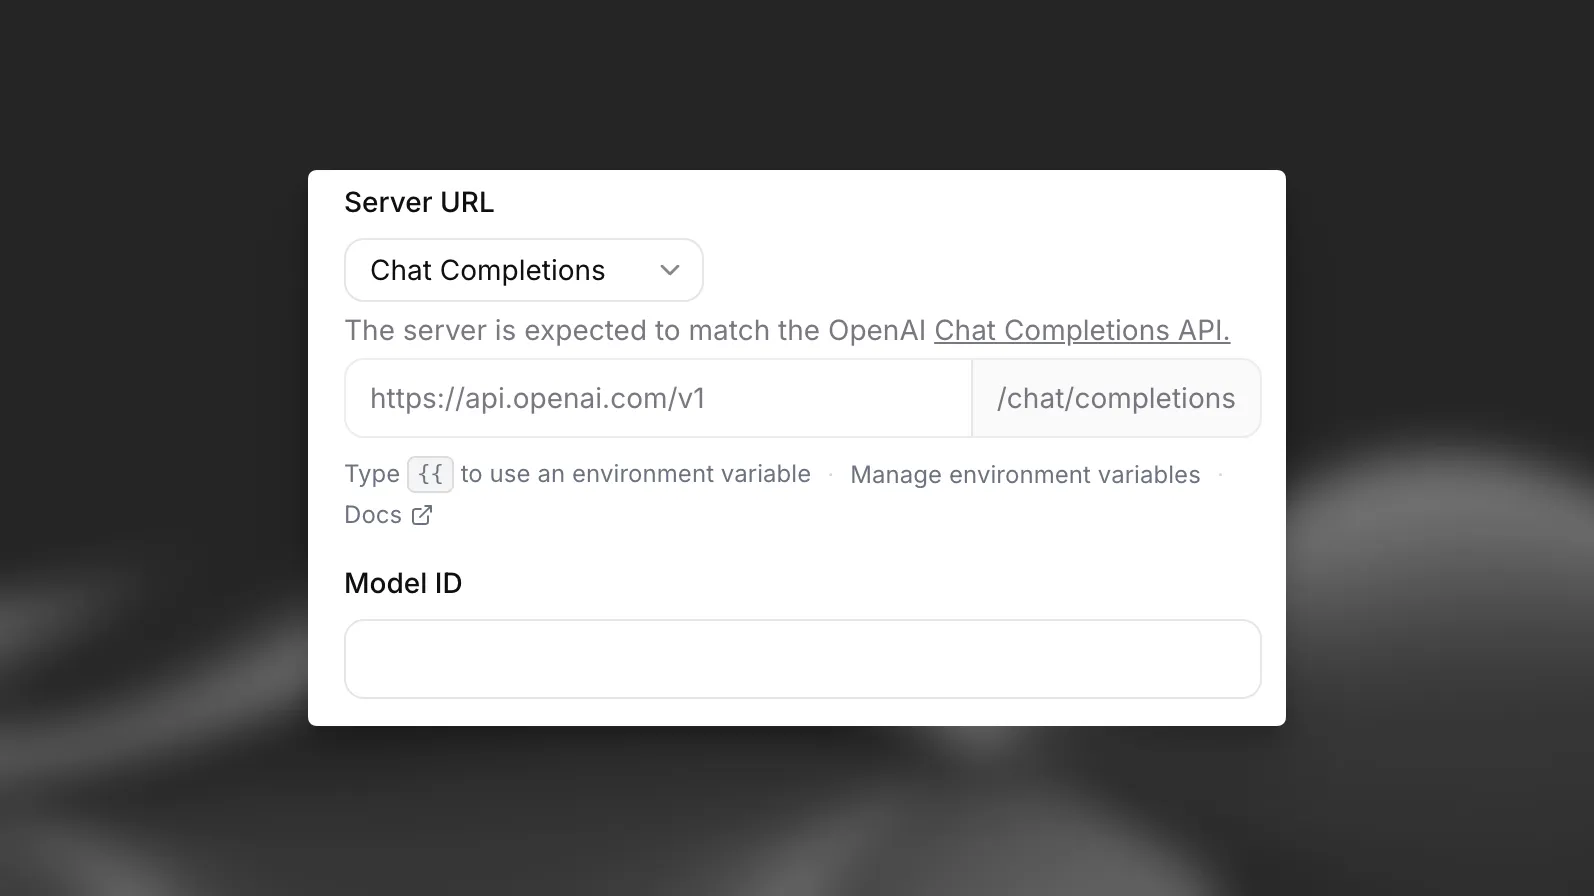
Custom LLM सर्वर
Custom LLM सर्वर लाने के लिए, OpenAI शैली का उपयोग करके एक संगत सर्वर एंडपॉइंट सेट अप करें। आप Chat Completions API (/v1/chat/completions) या Responses API (/v1/responses) में से कोई भी इम्प्लीमेंट कर सकते हैं।
दोनों एंडपॉइंट को Content-Type: text/event-stream के साथ SSE (Server-Sent Events) फ़ॉर्मैट में जवाब लौटाने होंगे।
Chat Completions API
Responses API
Chat Completions API, /v1/chat/completions एंडपॉइंट इस्तेमाल करता है।
हर चंक का फ़ॉर्मैट data: {json}\n\n होना चाहिए और स्ट्रीम का अंत data: [DONE]\n\n से होना चाहिए।
यह एक उदाहरण सर्वर इम्प्लीमेंटेशन है:
यह कोड या अपना सर्वर कोड चलाएँ।
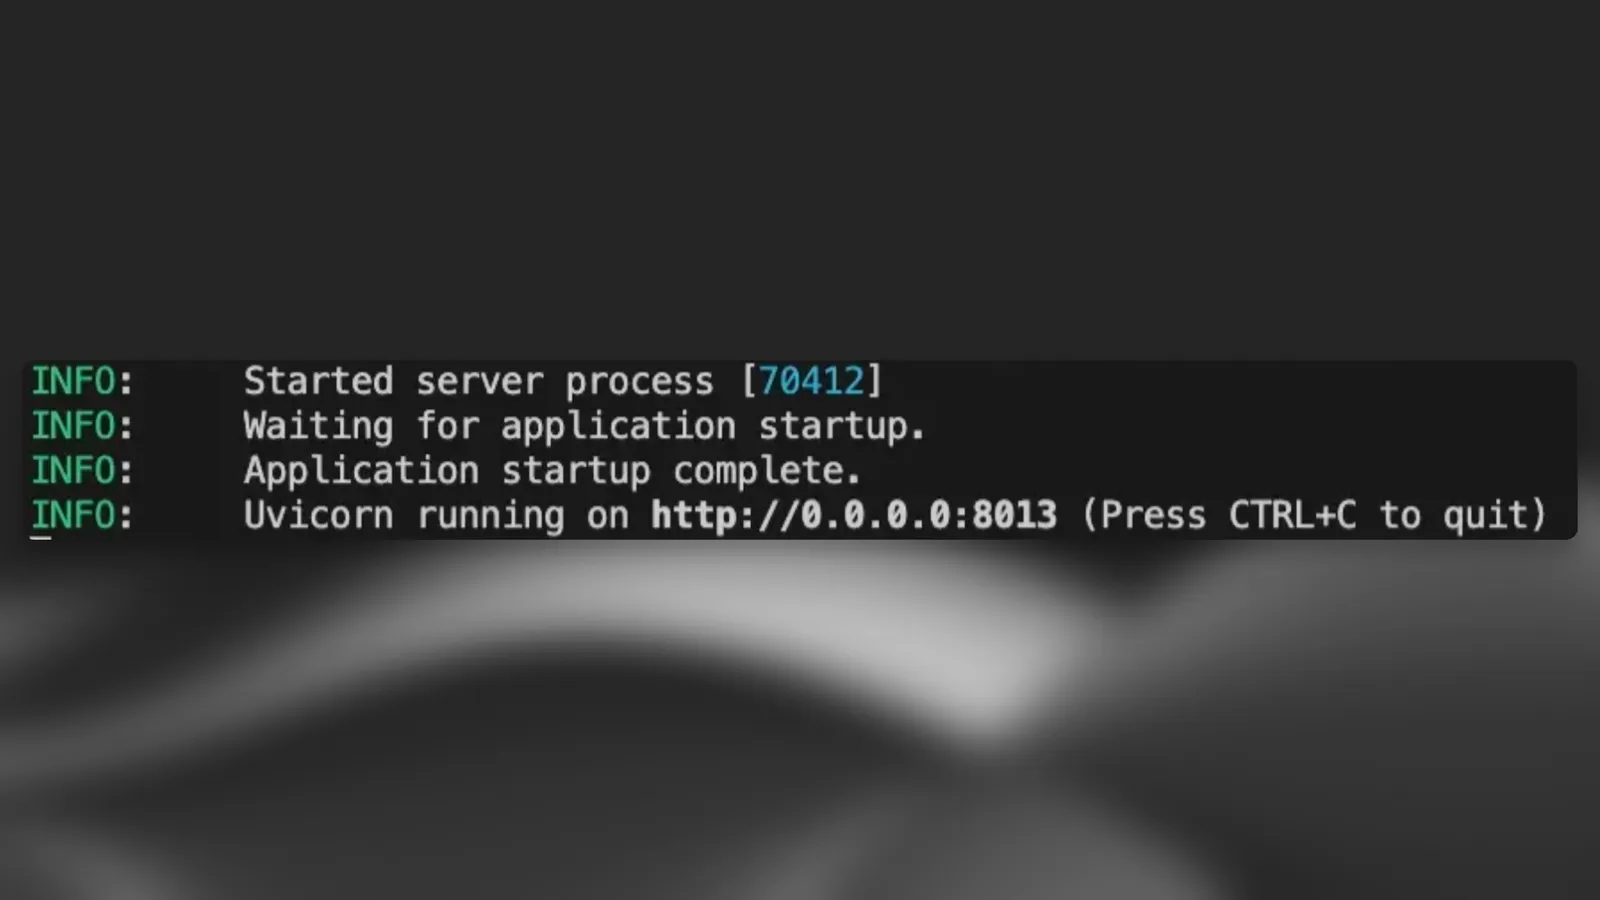
अपने सर्वर के लिए सार्वजनिक URL सेट अप करना
अपने सर्वर को एक्सेस योग्य बनाने के लिए, ngrok जैसे टनलिंग टूल का उपयोग करके एक सार्वजनिक URL बनाएँ:
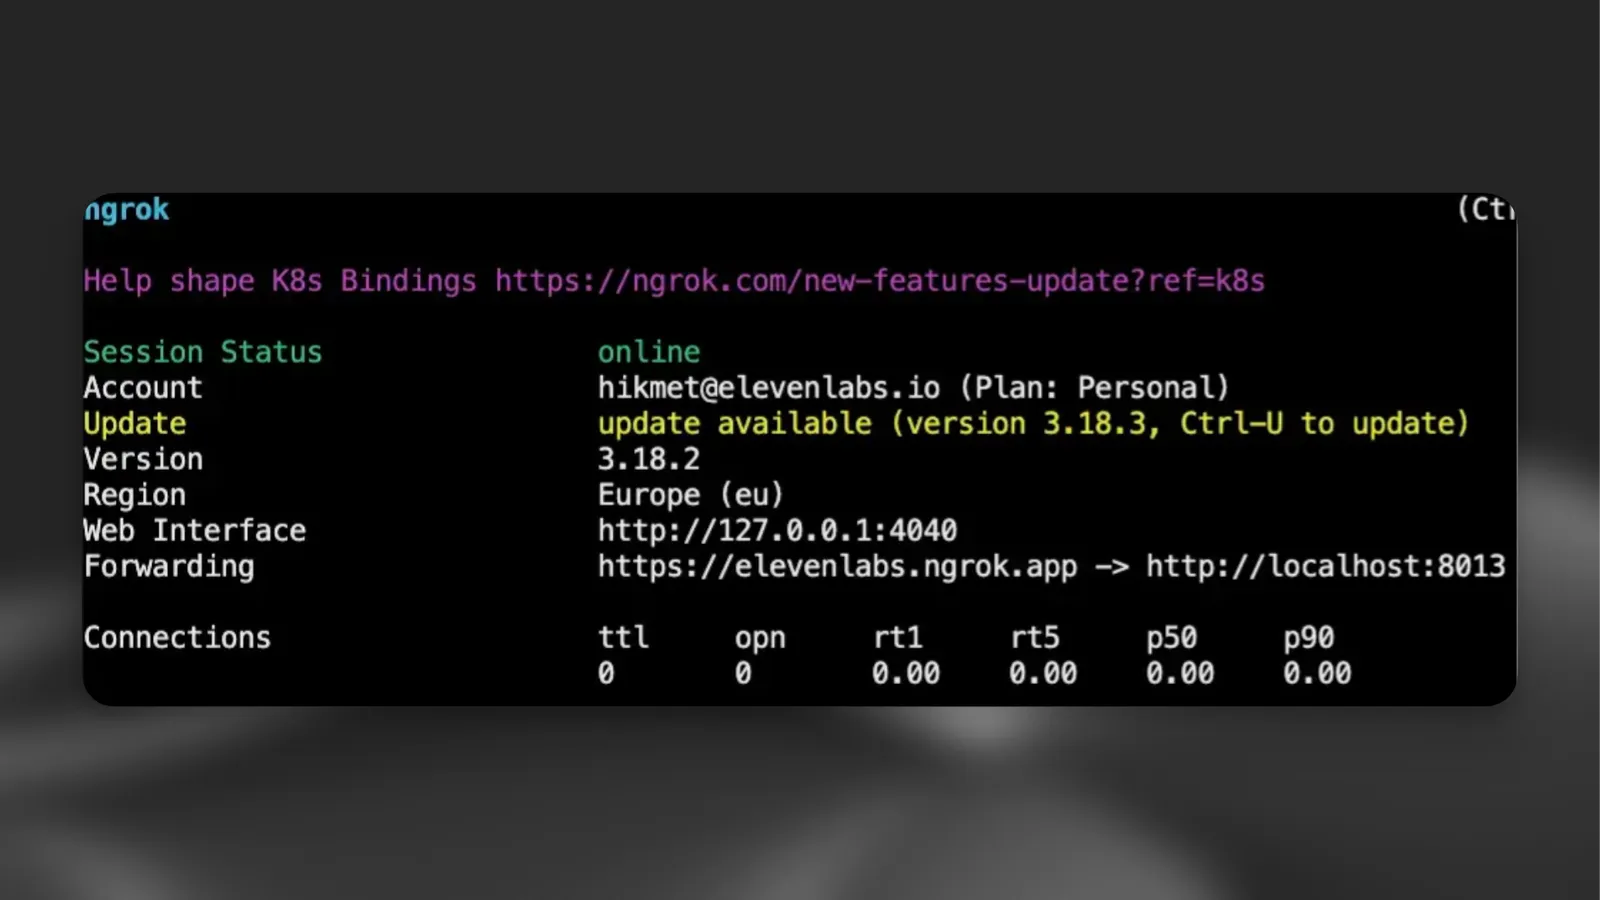
ElevenLabs CustomLLM कॉन्फ़िगर करना
अब, ElevenLabs डैशबोर्ड में अपनी एजेंट सेटिंग्स अपडेट करें ताकि वे आपके Custom LLM सर्वर की ओर जाएँ।
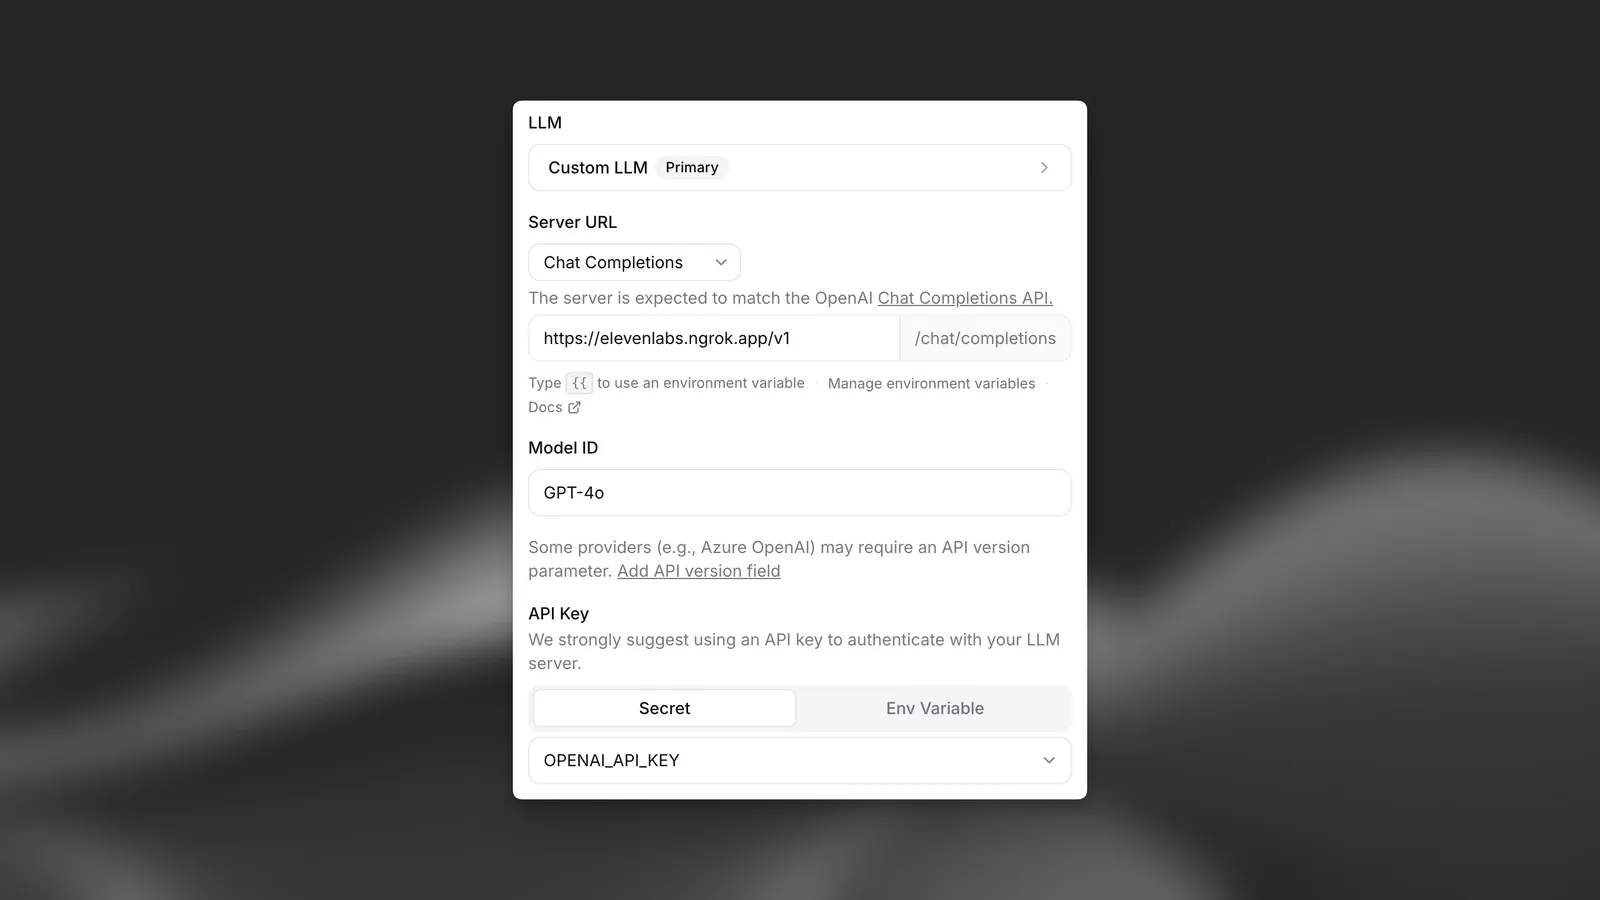
अपने सर्वर URL को ngrok एंडपॉइंट पर भेजें और “Limit token usage” को 5000 पर सेट करें।
अब आप अपने LLM सर्वर के साथ अपने एजेंट से इंटरैक्ट करना शुरू कर सकते हैं।
धीमे प्रोसेस होने वाले LLM के लिए ऑप्टिमाइज़ेशन
अगर आपके कस्टम LLM का प्रोसेसिंग समय धीमा है (शायद एजेंटिक रीजनिंग या प्री-प्रोसेसिंग की ज़रूरतों के कारण), तो आप अपने स्ट्रीमिंग रिस्पॉन्स में बफ़र शब्द लागू करके बातचीत के प्रवाह को बेहतर बना सकते हैं। यह तकनीक आपके LLM द्वारा पूरा रिस्पॉन्स जनरेट किए जाने के दौरान प्राकृतिक स्पीच प्रोसोडी बनाए रखने में मदद करती है।
बफ़र शब्द
जब आपके LLM को पूरा रिस्पॉन्स प्रोसेस करने के लिए ज़्यादा समय चाहिए, तो "... " (स्पेस के बाद इलिप्सिस) पर खत्म होने वाला शुरुआती रिस्पॉन्स लौटाएं। इससे टेक्स्ट टू स्पीच सिस्टम प्राकृतिक प्रवाह बनाए रखता है और बातचीत को गतिशील बनाए रखता है।
इससे स्वाभाविक विराम बनते हैं, जो बाद के उस कंटेंट में सहजता से जुड़ते हैं जिस पर LLM ज़्यादा देर तक रीजनिंग कर सकता है। अतिरिक्त स्पेस बहुत ज़रूरी है, ताकि बाद का कंटेंट ”…” से न जुड़ जाए, जिससे ऑडियो में विकृति आ सकती है।
इम्प्लीमेंटेशन
बफ़र शब्द लागू करने के लिए अपने कस्टम LLM सर्वर को इस तरह बदलें:
सिस्टम टूल्स इंटीग्रेशन
आपका कस्टम LLM बातचीत के प्रवाह और स्थिति को नियंत्रित करने के लिए सिस्टम टूल्स ट्रिगर कर सकता है। आपके एजेंट में कॉन्फ़िगर होने पर ये टूल्स आपके चैट कंप्लीशन अनुरोधों के tools पैरामीटर में अपने-आप शामिल हो जाते हैं।
सिस्टम टूल्स कैसे काम करते हैं
- LLM का निर्णय: आपका कस्टम LLM बातचीत के संदर्भ के आधार पर तय करता है कि इन टूल्स को कब कॉल करना है
- टूल रिस्पॉन्स: LLM मानक OpenAI फ़ॉर्मेट में फ़ंक्शन कॉल के साथ रिस्पॉन्ड करता है
- बैकएंड प्रोसेसिंग: ElevenLabs टूल कॉल्स को प्रोसेस करता है और बातचीत की स्थिति अपडेट करता है
सिस्टम टूल्स के बारे में ज़्यादा जानकारी के लिए, हमारी गाइड देखें
उपलब्ध सिस्टम टूल्स
कॉल समाप्त करें
उद्देश्य: उपयुक्त स्थितियां पूरी होने पर बातचीत को अपने-आप समाप्त करना।
ट्रिगर की स्थितियां: LLM को यह टूल तब कॉल करना चाहिए जब:
- मुख्य काम पूरा हो गया हो और यूज़र संतुष्ट हो
- बातचीत आपसी सहमति के साथ स्वाभाविक निष्कर्ष पर पहुंच गई हो
- यूज़र साफ़ तौर पर बातचीत खत्म करने की इच्छा जताए
पैरामीटर:
reason(string, आवश्यक): कॉल समाप्त करने का कारणmessage(string, वैकल्पिक): कॉल समाप्त करने से पहले यूज़र को भेजने के लिए विदाई संदेश
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: अपने एजेंट की सेटिंग्स में इसे सिस्टम टूल के रूप में कॉन्फ़िगर करें। LLM को यह फ़ंक्शन कब कॉल करना है, इसके बारे में विस्तृत निर्देश मिलेंगे।
और जानें: कॉल समाप्त करने का टूल
भाषा पहचान
उद्देश्य: बातचीत के दौरान यूज़र की पहचानी गई भाषा पर अपने-आप स्विच करना।
ट्रिगर की स्थितियां: LLM को यह टूल तब कॉल करना चाहिए जब:
- यूज़र मौजूदा बातचीत की भाषा से अलग भाषा में बोले
- यूज़र साफ़ तौर पर भाषा बदलने का अनुरोध करे
- बातचीत के लिए बहुभाषी सहायता की ज़रूरत हो
पैरामीटर:
reason(string, आवश्यक): भाषा बदलने का कारणlanguage(string, आवश्यक): जिस भाषा को स्विच करना है उसका भाषा कोड (समर्थित भाषाओं की सूची में होना चाहिए)
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: एजेंट सेटिंग्स में समर्थित भाषाएं कॉन्फ़िगर करें और भाषा पहचान सिस्टम टूल जोड़ें। एजेंट पहचानी गई भाषाओं के अनुसार वॉइस और रिस्पॉन्स अपने-आप बदल देगा।
और जानें: भाषा पहचान टूल
एजेंट ट्रांसफ़र
उद्देश्य: यूज़र की ज़रूरतों के आधार पर विशेषज्ञ AI एजेंटों के बीच बातचीत ट्रांसफ़र करना।
ट्रिगर की स्थितियां: LLM को यह टूल तब कॉल करना चाहिए जब:
- यूज़र के अनुरोध के लिए विशेष जानकारी या अलग एजेंट क्षमताओं की ज़रूरत हो
- मौजूदा एजेंट क्वेरी को पर्याप्त रूप से हैंडल न कर सके
- बातचीत के प्रवाह से अलग प्रकार के एजेंट की ज़रूरत दिखे
पैरामीटर:
reason(string, वैकल्पिक): एजेंट ट्रांसफ़र का कारणagent_number(integer, आवश्यक): जिस एजेंट को ट्रांसफ़र करना है उसका ज़ीरो-इंडेक्स्ड नंबर (कॉन्फ़िगर किए गए ट्रांसफ़र नियमों के आधार पर)
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: स्थितियों को विशिष्ट एजेंट ID से मैप करने वाले ट्रांसफ़र नियम तय करें। कॉन्फ़िगर करें कि मौजूदा एजेंट किन एजेंटों को ट्रांसफ़र कर सकता है। ट्रांसफ़र कॉन्फ़िगरेशन में एजेंटों को ज़ीरो-इंडेक्स्ड नंबरों से रेफ़र किया जाता है।
और जानें: एजेंट ट्रांसफ़र टूल
मानव को ट्रांसफ़र करें
उद्देश्य: जब AI सहायता पर्याप्त न हो, तो बातचीत को सहजता से मानव ऑपरेटरों को सौंपना।
ट्रिगर की स्थितियां: LLM को यह टूल तब कॉल करना चाहिए जब:
- किसी जटिल समस्या के लिए मानवीय निर्णय की ज़रूरत हो
- यूज़र साफ़ तौर पर मानव सहायता मांगे
- AI किसी खास अनुरोध के लिए अपनी क्षमता की सीमा तक पहुंच जाए
- एस्केलेशन प्रोटोकॉल ट्रिगर हों
पैरामीटर:
reason(string, वैकल्पिक): ट्रांसफ़र का कारणtransfer_number(string, आवश्यक): जिस फ़ोन नंबर पर ट्रांसफ़र करना है (कॉन्फ़िगर किए गए नंबरों से मेल खाना चाहिए)client_message(string, आवश्यक): ट्रांसफ़र की प्रतीक्षा के दौरान क्लाइंट को पढ़कर सुनाया जाने वाला संदेशagent_message(string, आवश्यक): कॉल प्राप्त करने वाले मानव ऑपरेटर के लिए संदेश
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: ट्रांसफ़र फ़ोन नंबर और स्थितियां कॉन्फ़िगर करें। ग्राहक और कॉल लेने वाले मानव ऑपरेटर, दोनों के लिए संदेश तय करें। यह Twilio और SIP ट्रंकिंग, दोनों के साथ काम करता है।
और जानें: मानव को ट्रांसफ़र करने का टूल
टर्न छोड़ें
उद्देश्य: एजेंट को बिना बोले रुकने और यूज़र के इनपुट की प्रतीक्षा करने देना।
ट्रिगर की स्थितियां: LLM को यह टूल तब कॉल करना चाहिए जब:
- यूज़र संकेत दे कि उसे एक पल चाहिए (“मुझे एक सेकंड दें”, “मुझे सोचने दें”)
- यूज़र बातचीत के प्रवाह में रुकने का अनुरोध करे
- एजेंट को पता चले कि यूज़र को जानकारी समझने के लिए समय चाहिए
पैरामीटर:
reason(string, वैकल्पिक): रुकने की ज़रूरत का कारण बताने वाला मुक्त-रूप कारण
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: किसी अतिरिक्त कॉन्फ़िगरेशन की ज़रूरत नहीं है। यह टूल सिर्फ़ एजेंट को संकेत देता है कि यूज़र के दोबारा बोलने तक उसे चुप रहना है।
और जानें: टर्न छोड़ने का टूल
वॉइसमेल पहचान
Parameters:
reason(string, आवश्यक): voicemail detect होने का कारण (जैसे, “automated greeting detected”, “no human response”)
Function call format:
और जानें: वॉइसमेल पहचान टूल
सिस्टम टूल्स के साथ उदाहरण अनुरोध
जब सिस्टम टूल्स कॉन्फ़िगर होते हैं, तो आपके कस्टम LLM को ऐसे अनुरोध मिलेंगे जिनमें मानक OpenAI फ़ॉर्मेट में टूल्स शामिल होंगे:
सिस्टम टूल्स इस्तेमाल करने के लिए आपके कस्टम LLM को फ़ंक्शन कॉलिंग सपोर्ट करनी चाहिए। सुनिश्चित करें कि आपका मॉडल OpenAI फ़ॉर्मेट में सही फ़ंक्शन कॉल रिस्पॉन्स जनरेट कर सकता है।
अतिरिक्त सुविधाएं
कस्टम LLM पैरामीटर
आप अपने कस्टम LLM इम्प्लीमेंटेशन में अतिरिक्त पैरामीटर पास कर सकते हैं।