

独自モデルを統合
独自のLLMをエージェントに接続するか、独自のサーバーをホストします。
Custom LLMでは、外部エンドポイントを介して会話を独自のLLMに接続できます。 ElevenLabsはnative統合LLMにも対応しています。
Custom LLMでは、独自のOpenAI APIキーを使用するか、完全にカスタムなLLMサーバーを実行できます。
Custom LLMは、Realtimeモデルと併用できません。
概要
デフォルトでは、OpenAIなどの一般的なモデルに対して内部認証情報を使用します。カスタムLLMサーバーを使用するには、次のいずれかのOpenAI互換リクエスト/レスポンス構造に準拠している必要があります。
- Chat Completions API(
/v1/chat/completions) - Responses API(
/v1/responses)
Responses APIは、追加機能をサポートするOpenAIの新しいAPI形式です。どちらのAPI形式も、Custom LLM統合で完全にサポートされています。
以下のガイドでは、両方のユースケースを扱います。
- 独自のOpenAIキーを使用:独自のOpenAI APIキーをプラットフォームで使用します。
- カスタムLLMサーバー:独自のLLMサーバー実装をホストして接続します。
以下の方法を学べます。
- OpenAI APIキーをElevenLabsに保存する
- OpenAIのChat CompletionsまたはResponsesエンドポイントを再現するサーバーをホストする
- ElevenLabsをカスタムエンドポイントに向ける
- 必要に応じてLLMに追加パラメーターを渡す
推論サマリー
エンドポイントは、最終回答とは別に推論を返す必要があります。ElevenLabsは最終回答から推論を生成しません。
サポートされているエンドポイントから推論をリクエストするには、エージェントのLLM設定で推論サマリーをオンにするか、API経由でenable_reasoning_summaryを設定します。
推論を返す
エンドポイントに対応する形式を使用してください。
Chat Completions API
Responses API
各レスポンスデルタのreasoningまたはreasoning_contentフィールドで推論をストリーミングします。
Gemini互換エンドポイントでは、ElevenLabsはgoogle.thinking_config.include_thoughtsで思考をリクエストし、extra_content.google.thoughtでマークされたコンテンツを読み取ります。
保存、配信、制限事項については、推論サマリーを参照してください。
独自のOpenAIキーを使用する
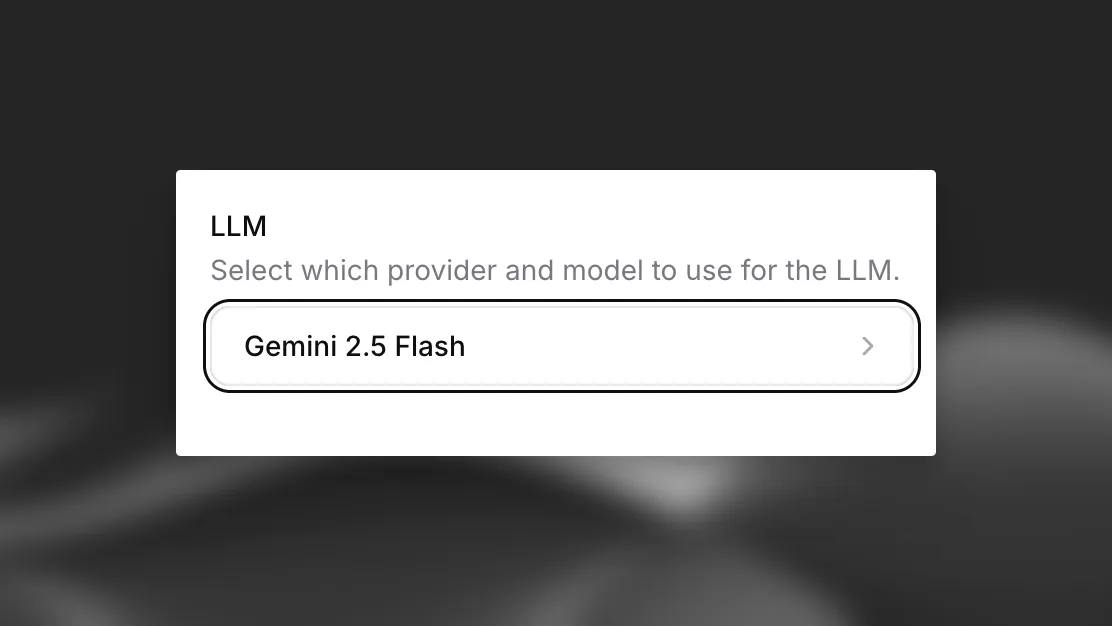
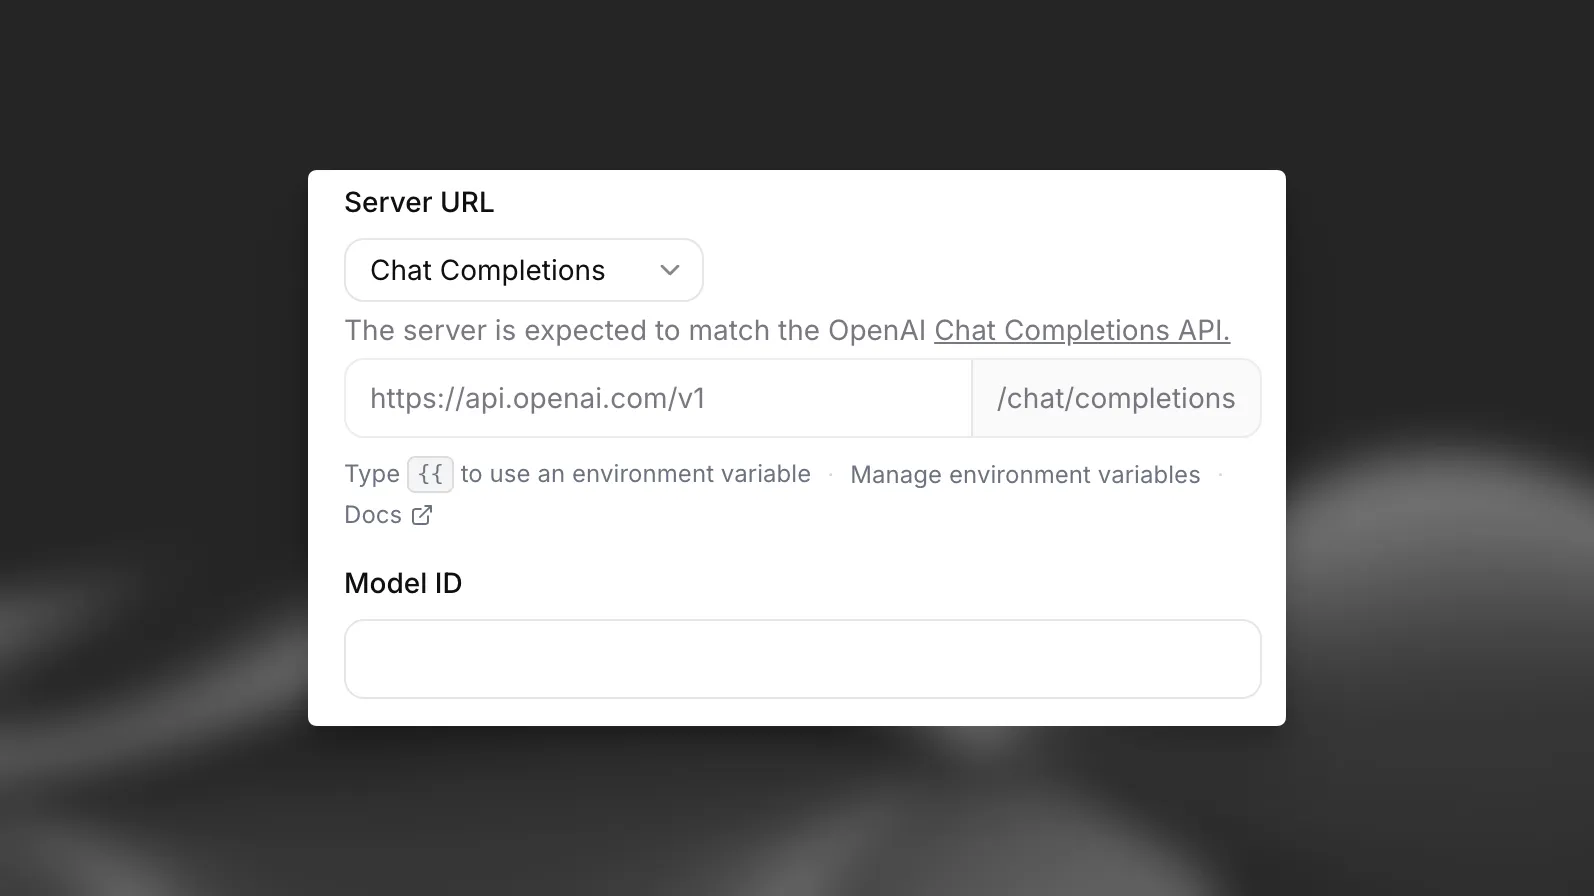
カスタムOpenAIキーを統合するには、ElevenLabsダッシュボードでエージェント設定を更新してカスタムLLMサーバーを指定し、OPENAI_API_KEYを含むシークレットを作成します。
カスタムLLMサーバー
カスタムLLMサーバーを使用するには、OpenAI形式を用いた互換性のあるサーバーエンドポイントをセットアップします。Chat Completions API(/v1/chat/completions)またはResponses API(/v1/responses)のいずれかを実装できます。
どちらのエンドポイントも、Content-Type: text/event-streamを使用したSSE(Server-Sent Events)形式で応答を返す必要があります。
Chat Completions API
Responses API
Chat Completions APIでは、/v1/chat/completionsエンドポイントを使用します。
各チャンクはdata: {json}\n\nの形式にし、ストリームはdata: [DONE]\n\nで終了する必要があります。
以下はサーバー実装の例です。
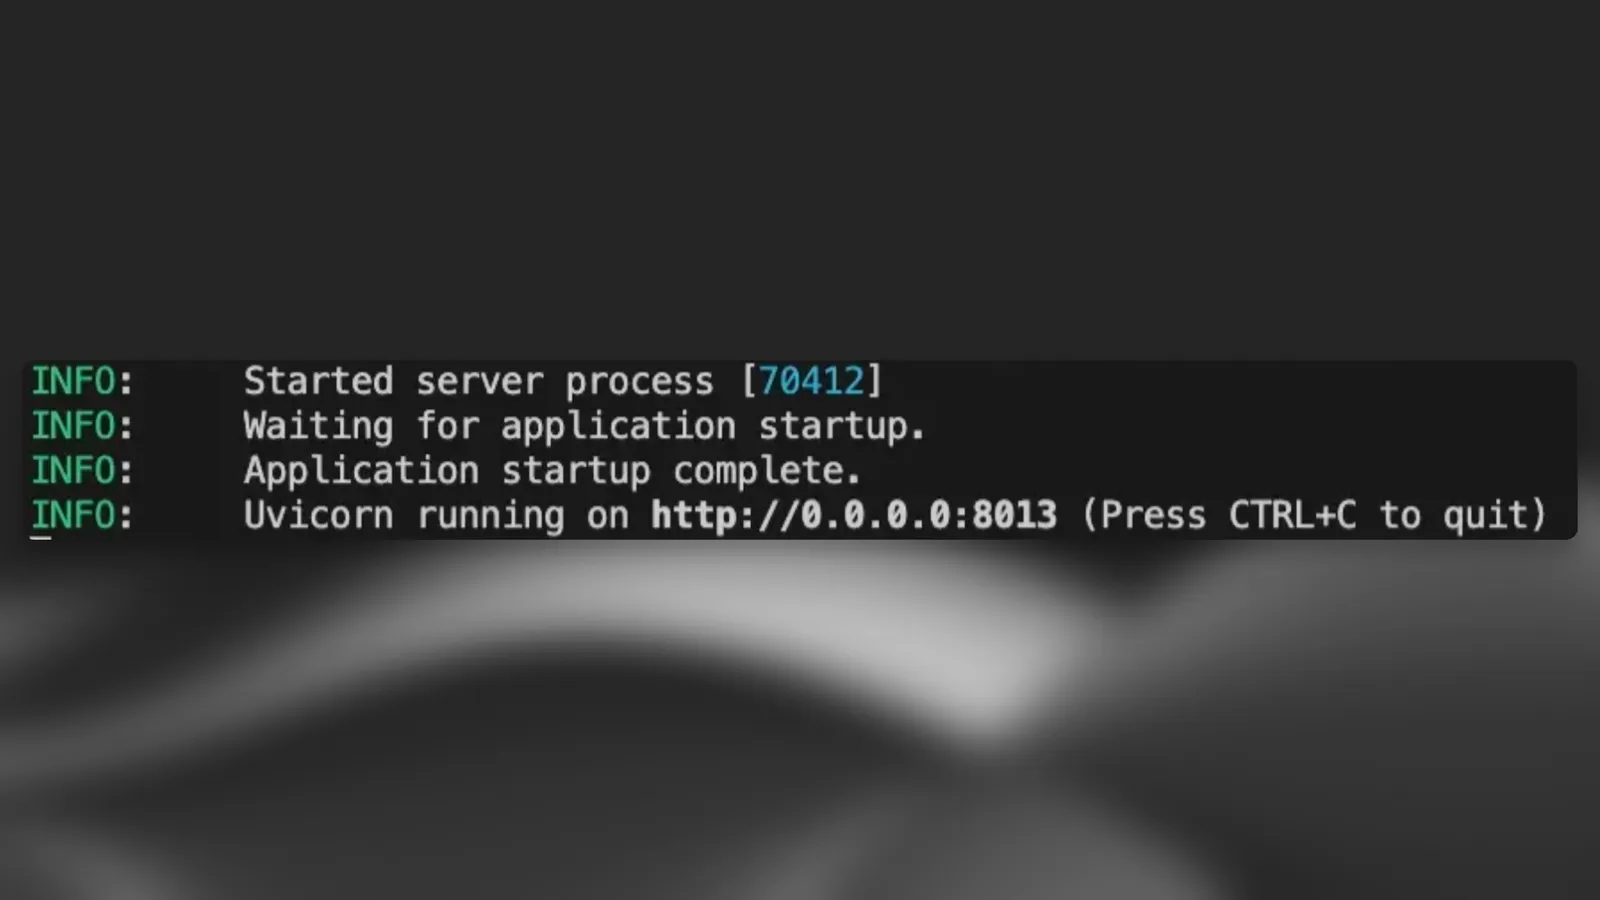
このコード、または独自のサーバーコードを実行します。
サーバー用のパブリックURLを設定する
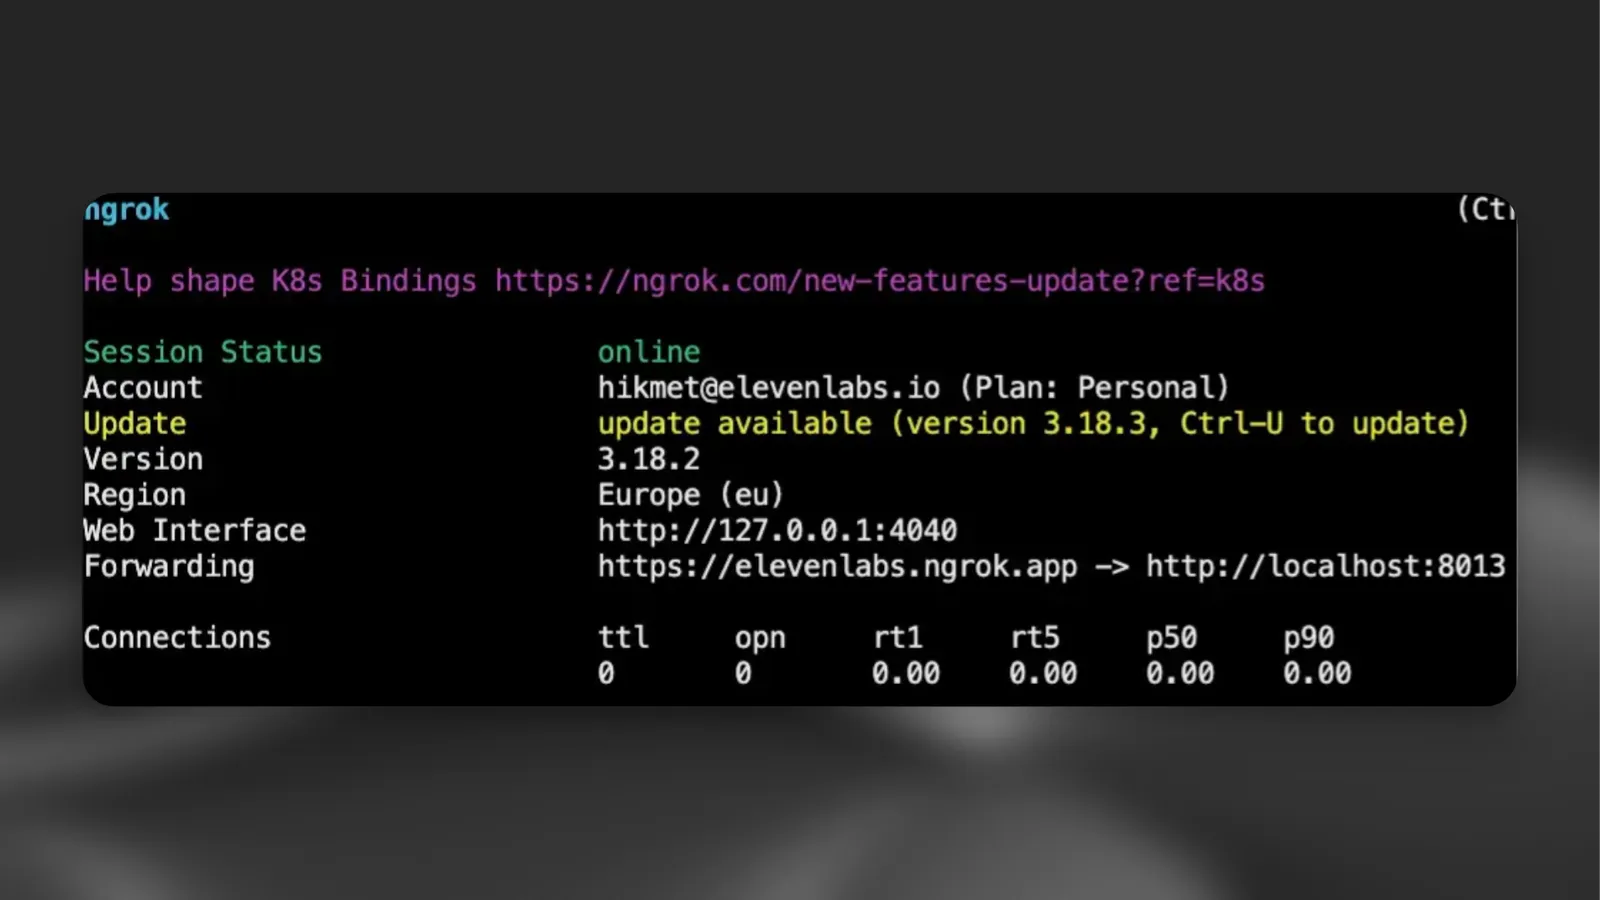
サーバーにアクセスできるようにするには、ngrokなどのトンネリングツールを使用してパブリックURLを作成します。
ElevenLabs CustomLLMを設定する
次に、ElevenLabsダッシュボードでエージェント設定を更新し、カスタムLLMサーバーを指定します。
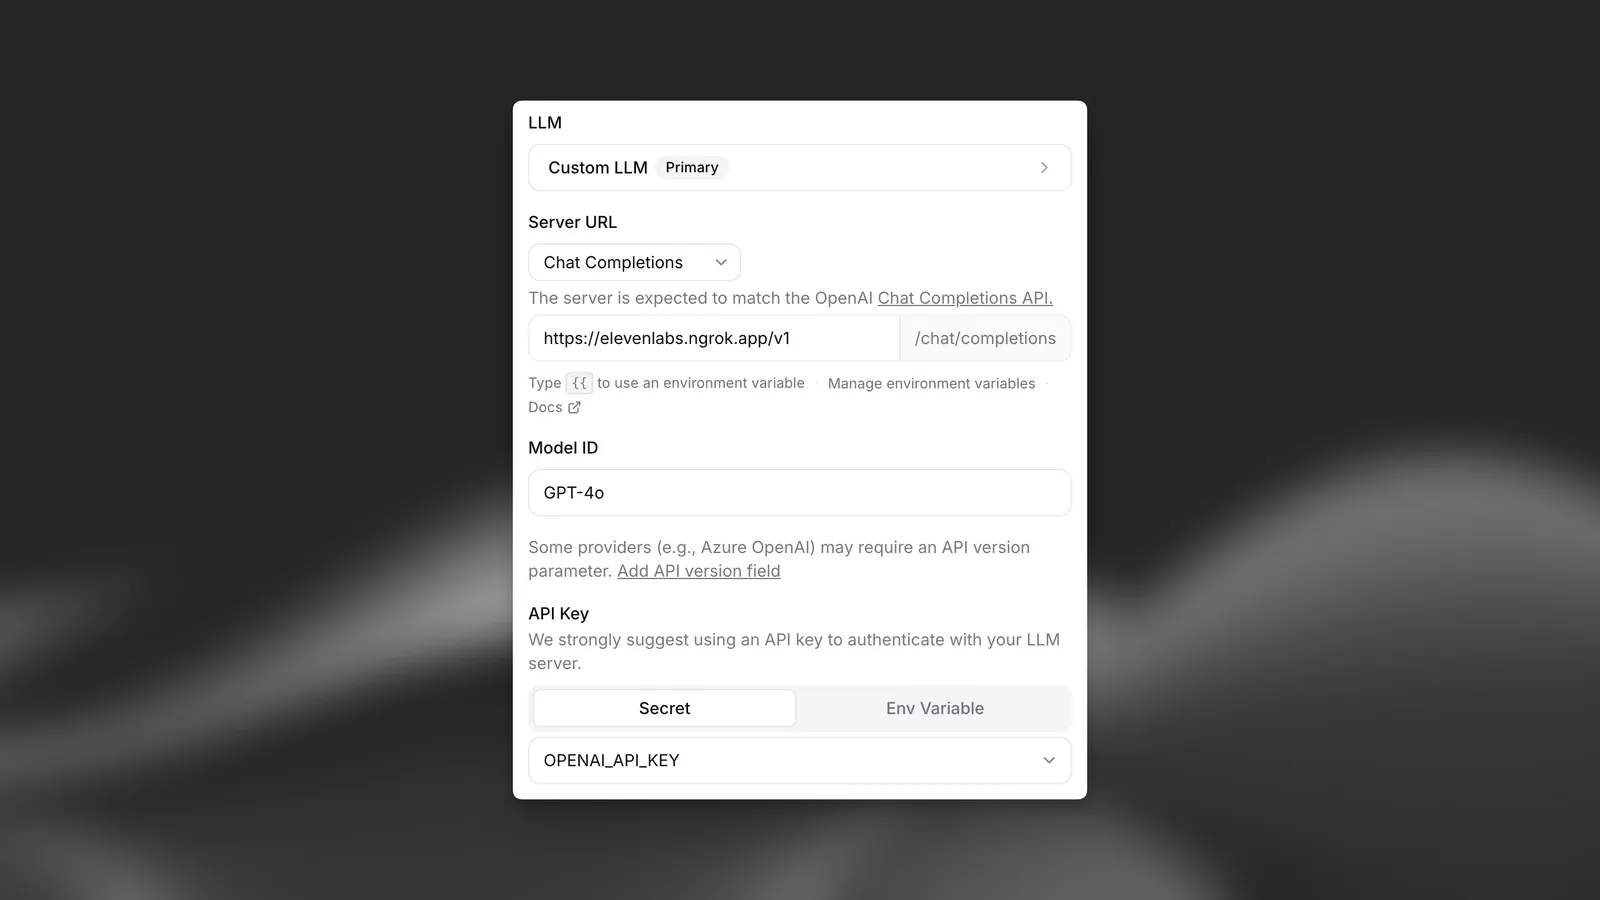
サーバーURLをngrokエンドポイントに指定し、「Limit token usage」を5000に設定します。
これで、独自のLLMサーバーを使用してエージェントとの対話を開始できます。
処理が遅いLLMの最適化
カスタムLLMの処理時間が遅い場合(エージェント型推論や前処理が必要な場合など)、ストリーミングレスポンスにバッファワードを実装することで、会話の流れを改善できます。この手法により、LLMが完全な応答を生成している間も、自然な発話の抑揚を維持できます。
バッファワード
LLMが完全な応答を処理するのにさらに時間が必要な場合は、末尾が"... "(省略記号の後にスペース)となる初期応答を返してください。これにより、テキスト読み上げシステムは自然な流れを維持しつつ、会話の動的な感覚を保てます。
これにより、LLMがより長く推論できる後続コンテンツへ自然につながる間が生まれます。後続コンテンツが"..."に追加されるのを防ぐため、余分なスペースは不可欠です。追加されるとオーディオの歪みにつながることがあります。
実装
バッファワードを実装するためにカスタムLLMサーバーを変更する方法は次のとおりです。
システムツールの統合
カスタムLLMは、システムツールをトリガーして、会話のフローと状態を制御できます。エージェントで設定すると、これらのツールはチャット補完リクエストのtoolsパラメーターに自動的に含まれます。
システムツールの仕組み
- LLMの判断:カスタムLLMは会話のコンテキストに基づいて、これらのツールをいつ呼び出すかを判断します
- ツールの応答:LLMは標準のOpenAI形式で関数呼び出しを返します
- バックエンド処理:ElevenLabsがツール呼び出しを処理し、会話の状態を更新します
システムツールの詳細については、ガイドを参照してください。
利用可能なシステムツール
通話を終了
目的:適切な条件が満たされたときに、会話を自動的に終了します。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- 主なタスクが完了し、ユーザーが満足している
- 双方の合意により、会話が自然な結論に達した
- ユーザーが会話を終了したいと明示的に示した
パラメーター:
reason(string、必須):通話を終了する理由message(string、任意):通話終了前にユーザーへ送る別れのメッセージ
関数呼び出し形式:
実装:エージェント設定でシステムツールとして設定します。LLMは、この関数をいつ呼び出すかについての詳細な指示を受け取ります。
詳細: 通話終了ツール
言語検出
目的:会話中に、検出されたユーザーの言語へ自動的に切り替えます。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーが現在の会話言語とは異なる言語で話している
- ユーザーが言語の切り替えを明示的にリクエストした
- 会話に多言語サポートが必要である
パラメーター:
reason(string、必須):言語を切り替える理由language(string、必須):切り替え先の言語コード(サポート対象言語リストに含まれている必要があります)
関数呼び出し形式:
実装:エージェント設定で対応言語を設定し、言語検出システムツールを追加します。エージェントは、検出された言語に合わせて音声と応答を自動的に切り替えます。
詳細: 言語検出ツール
エージェント転送
目的:ユーザーのニーズに基づいて、専門特化したAIエージェント間で会話を転送します。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーのリクエストに専門知識や別のエージェント機能が必要である
- 現在のエージェントではクエリに適切に対応できない
- 会話の流れから別の種類のエージェントが必要だと判断される
パラメーター:
reason(string、任意):エージェント転送の理由agent_number(integer、必須):転送先エージェントのゼロ始まりの番号(設定された転送ルールに基づく)
関数呼び出し形式:
実装:条件を特定のエージェントIDにマッピングする転送ルールを定義します。現在のエージェントが転送できるエージェントを設定してください。転送設定では、エージェントはゼロ始まりの番号で参照されます。
詳細: エージェント転送ツール
人間の担当者に転送
目的:AIによる支援が十分でない場合に、会話を人間のオペレーターへスムーズに引き継ぎます。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- 人間による判断が必要な複雑な問題
- ユーザーが人間による支援を明示的にリクエストした
- AIの能力では特定のリクエストに対応できない
- エスカレーションプロトコルがトリガーされた
パラメーター:
reason(string、任意):転送の理由transfer_number(string、必須):転送先の電話番号(設定済みの番号と一致している必要があります)client_message(string、必須):転送を待つ間にクライアントへ読み上げるメッセージagent_message(string、必須):通話を受ける人間のオペレーターへのメッセージ
関数呼び出し形式:
実装:転送先の電話番号と条件を設定します。顧客と通話を受ける人間のオペレーターの両方に向けたメッセージを定義します。TwilioとSIPトランキングの両方で動作します。
詳細: 人間の担当者への転送ツール
ターンをスキップ
目的:エージェントが発話せずに一時停止し、ユーザーの入力を待てるようにします。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーが少し時間が必要だと示している(「少し待って」「考えさせて」)
- ユーザーが会話の流れを一時停止するようリクエストした
- エージェントが、ユーザーには情報を処理する時間が必要だと検出した
パラメーター:
reason(string、任意):一時停止が必要な理由を説明する自由形式の理由
関数呼び出し形式:
実装:追加設定は必要ありません。このツールは、ユーザーが再び話すまでエージェントが無言で待機するよう通知するだけです。
詳細: ターンをスキップツール
留守番電話の検出
システムツールを含むリクエスト例
システムツールが設定されている場合、カスタムLLMは標準のOpenAI形式でツールを含むリクエストを受け取ります。
システムツールを使用するには、カスタムLLMが関数呼び出しに対応している必要があります。モデルが OpenAI形式で適切な関数呼び出し応答を生成できることを確認してください。