

Eigenes Modell integrieren
Mit Custom LLM können Sie Ihre Gespräche über einen externen Endpunkt mit Ihrem eigenen LLM verbinden. ElevenLabs unterstützt auch nativ integrierte LLMs
Custom LLMs ermöglichen es Ihnen, Ihren eigenen OpenAI-API-Key zu verwenden oder einen vollständig eigenen LLM-Server zu betreiben.
Ein Custom LLM kann nicht mit einem Realtime-Modell verwendet werden.
Überblick
Standardmäßig verwenden wir für beliebte Modelle wie OpenAI unsere eigenen internen Zugangsdaten. Um einen Custom-LLM-Server zu verwenden, muss er einer der folgenden OpenAI-kompatiblen Anfrage-/Antwortstrukturen entsprechen:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Die Responses API ist das neuere API-Format von OpenAI und unterstützt zusätzliche Funktionen. Beide API-Formate werden vollständig für die Integration von Custom LLMs unterstützt.
Die folgenden Anleitungen behandeln beide Anwendungsfälle:
- Eigenen OpenAI-Key verwenden: Verwenden Sie Ihren eigenen OpenAI-API-Key mit unserer Plattform.
- Custom-LLM-Server: Hosten und verbinden Sie Ihre eigene LLM-Serverimplementierung.
Sie erfahren, wie Sie:
- Ihren OpenAI-API-Key in ElevenLabs speichern
- Einen Server hosten, der den Endpunkt Chat Completions oder Responses von OpenAI nachbildet
- ElevenLabs auf Ihren Custom-Endpunkt verweisen
- Bei Bedarf zusätzliche Parameter an Ihr LLM übergeben
Zusammenfassung der Schlussfolgerungen
Ihr Endpunkt muss Schlussfolgerungen getrennt von der endgültigen Antwort zurückgeben. ElevenLabs generiert keine Schlussfolgerungen aus der endgültigen Antwort.
Um Schlussfolgerungen von einem unterstützten Endpunkt anzufordern, aktivieren Sie Reasoning summary in den LLM-Einstellungen des Agents oder setzen Sie enable_reasoning_summary über die API.
Schlussfolgerungen zurückgeben
Verwenden Sie das Format, das zu Ihrem Endpunkt passt:
Chat Completions API
Responses API
Streamen Sie Schlussfolgerungen im Feld reasoning oder reasoning_content jedes Antwort-Deltas.
Für Gemini-kompatible Endpunkte fordert ElevenLabs Gedanken mit
google.thinking_config.include_thoughts an und liest Inhalte mit der Kennzeichnung
extra_content.google.thought.
Informationen zu Speicherung, Bereitstellung und Einschränkungen finden Sie unter Reasoning summary.
Eigenen OpenAI-Key verwenden
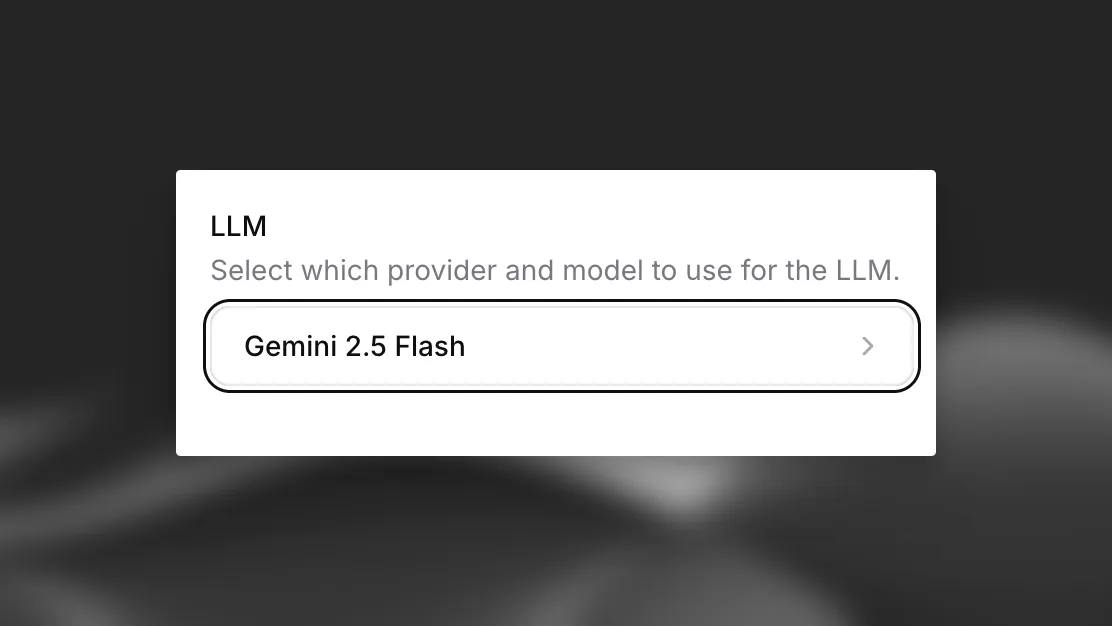
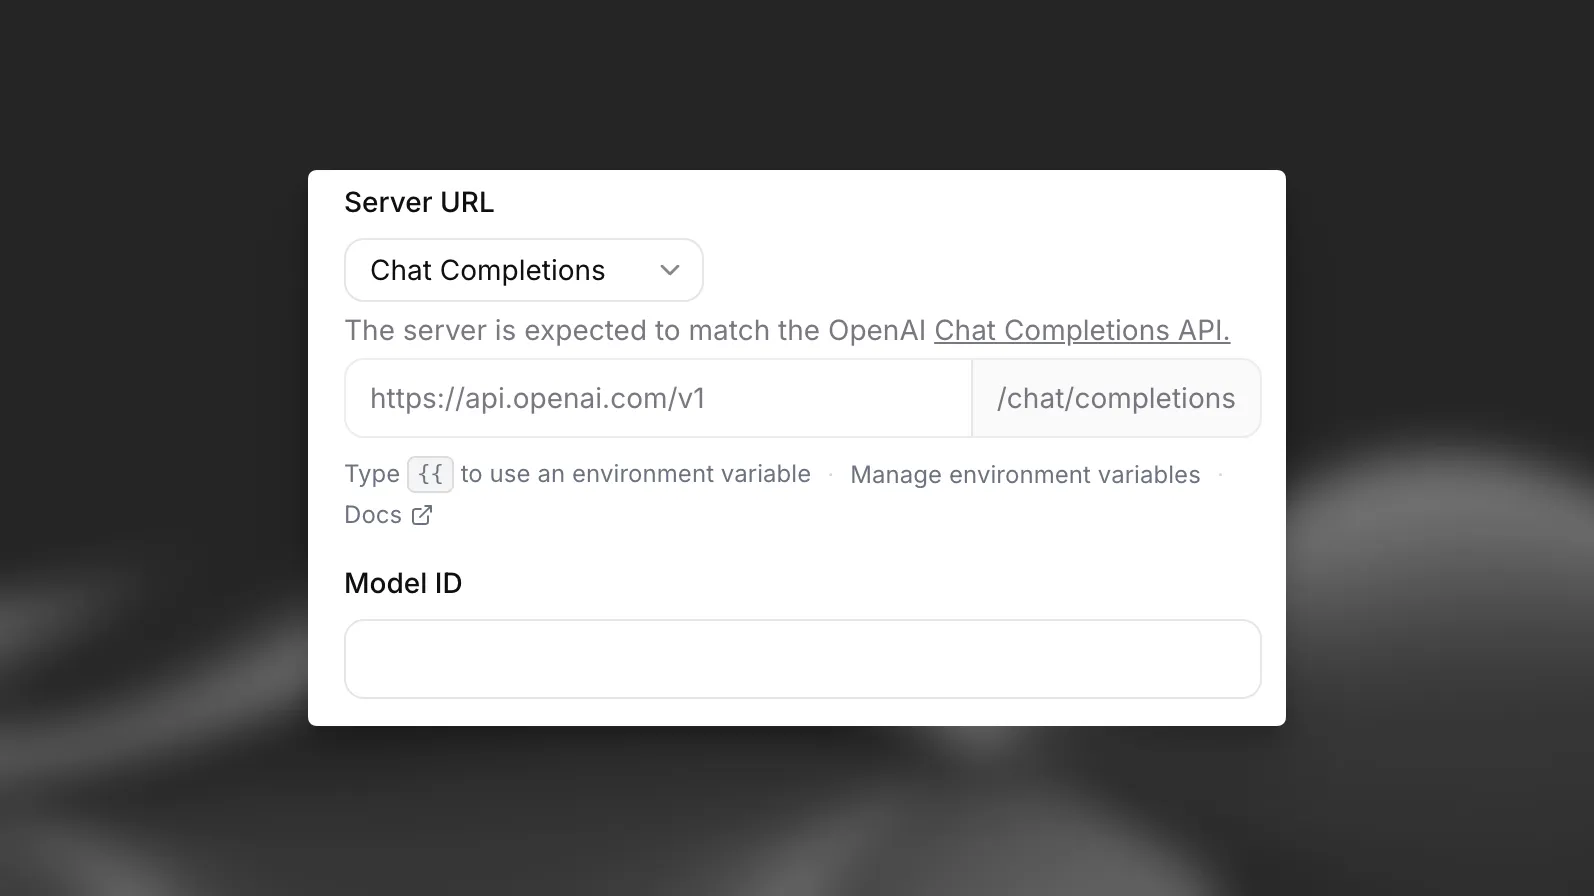
Um einen eigenen OpenAI-Key zu integrieren, aktualisieren Sie die Einstellungen Ihres Agents im ElevenLabs-Dashboard, sodass sie auf Ihren Custom-LLM-Server verweisen, und erstellen Sie ein Secret mit Ihrem OPENAI_API_KEY:
Wählen Sie in den Agent-Einstellungen im ElevenLabs-Dashboard rechts im Dropdown-Menü „LLM“ die Option „Custom LLM“.
Custom-LLM-Server
Um einen eigenen LLM-Server bereitzustellen, richten Sie einen kompatiblen Serverendpunkt im Stil von OpenAI ein. Sie können entweder die Chat Completions API (/v1/chat/completions) oder die Responses API (/v1/responses) implementieren.
Beide Endpunkte müssen Antworten im SSE-Format (Server-Sent Events) mit Content-Type: text/event-stream zurückgeben.
Chat Completions API
Responses API
Die Chat Completions API verwendet den Endpunkt /v1/chat/completions.
Jeder Chunk muss als data: {json}\n\n formatiert sein und der Stream muss mit data: [DONE]\n\n enden.
Hier ist eine beispielhafte Serverimplementierung:
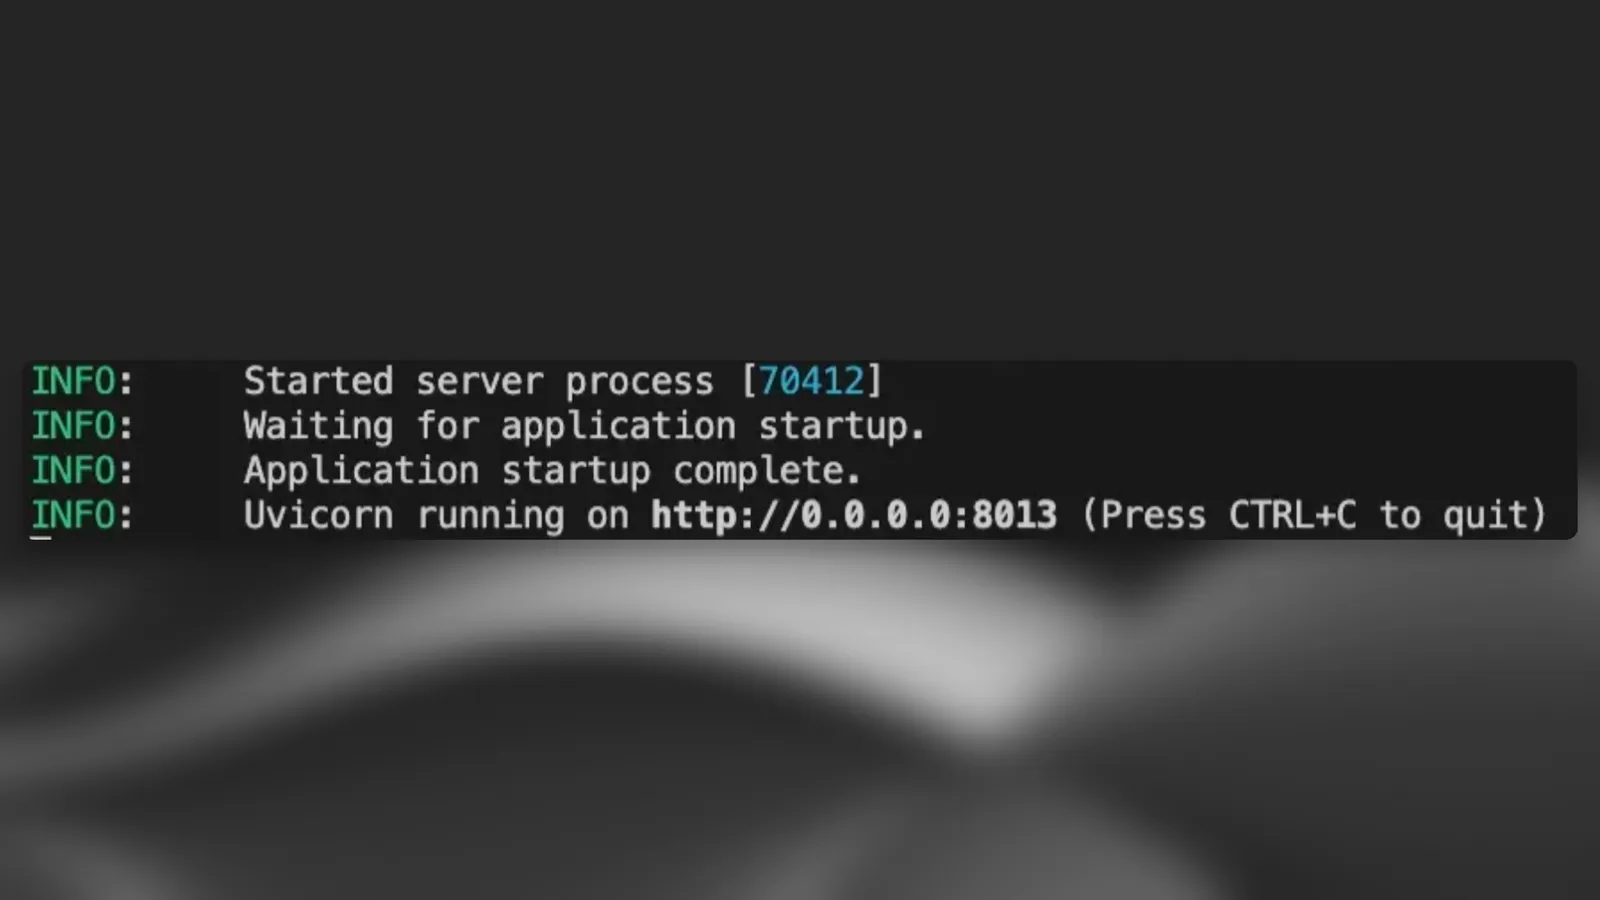
Führen Sie diesen Code oder Ihren eigenen Servercode aus.
Öffentliche URL für Ihren Server einrichten
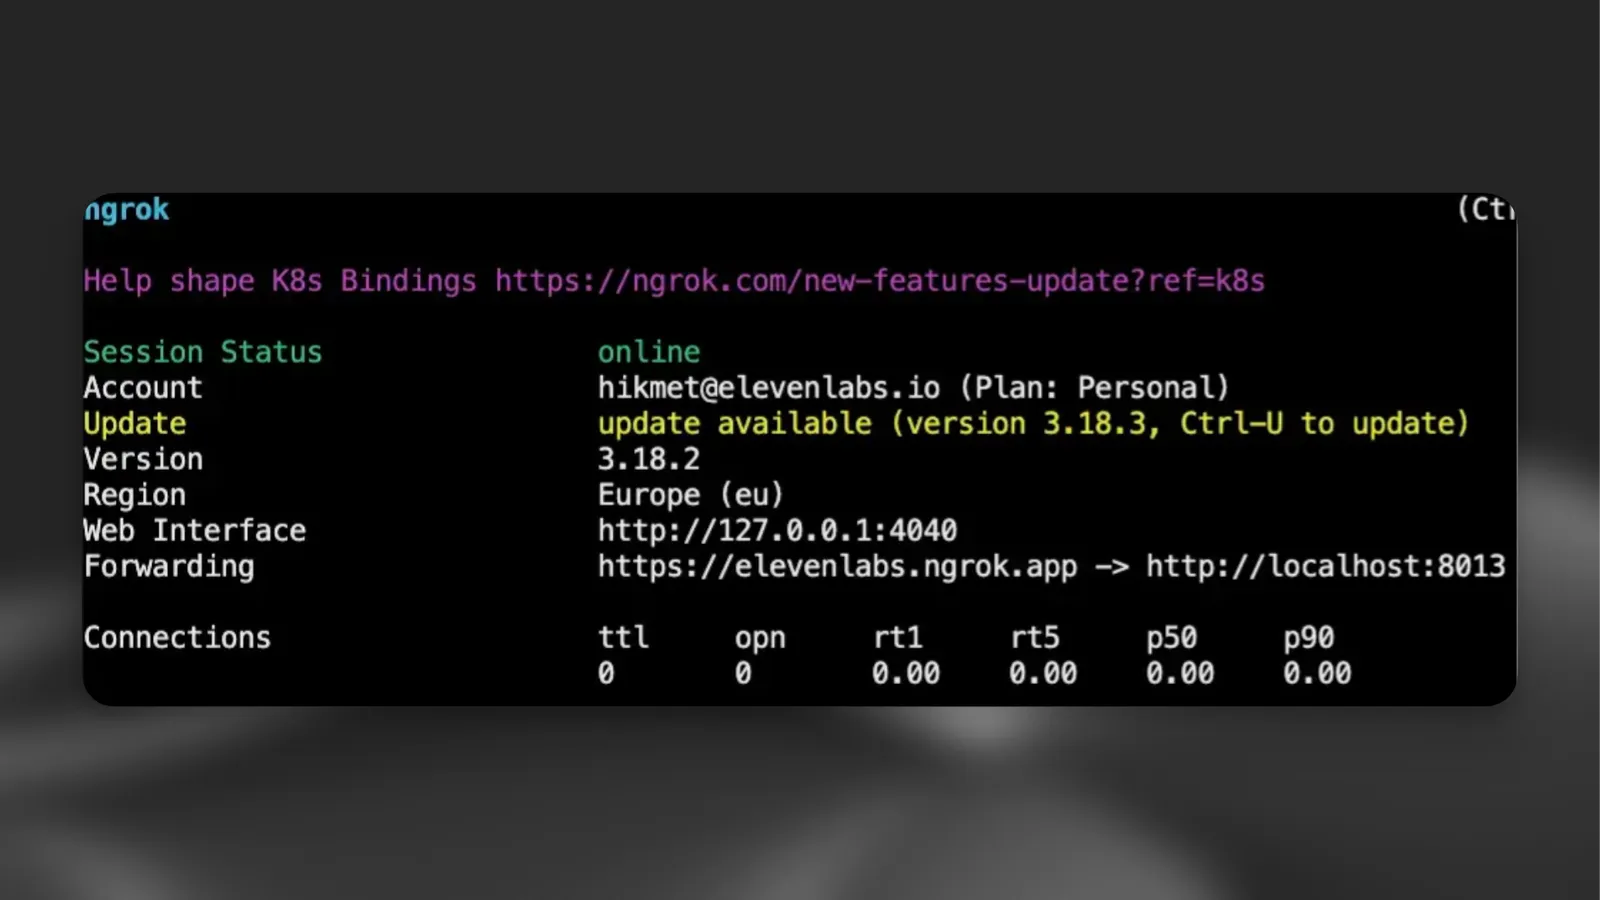
Damit Ihr Server erreichbar ist, erstellen Sie mit einem Tunneling-Tool wie ngrok eine öffentliche URL:
ElevenLabs CustomLLM konfigurieren
Aktualisieren Sie anschließend die Einstellungen Ihres Agents im ElevenLabs-Dashboard, sodass sie auf Ihren Custom-LLM-Server verweisen.
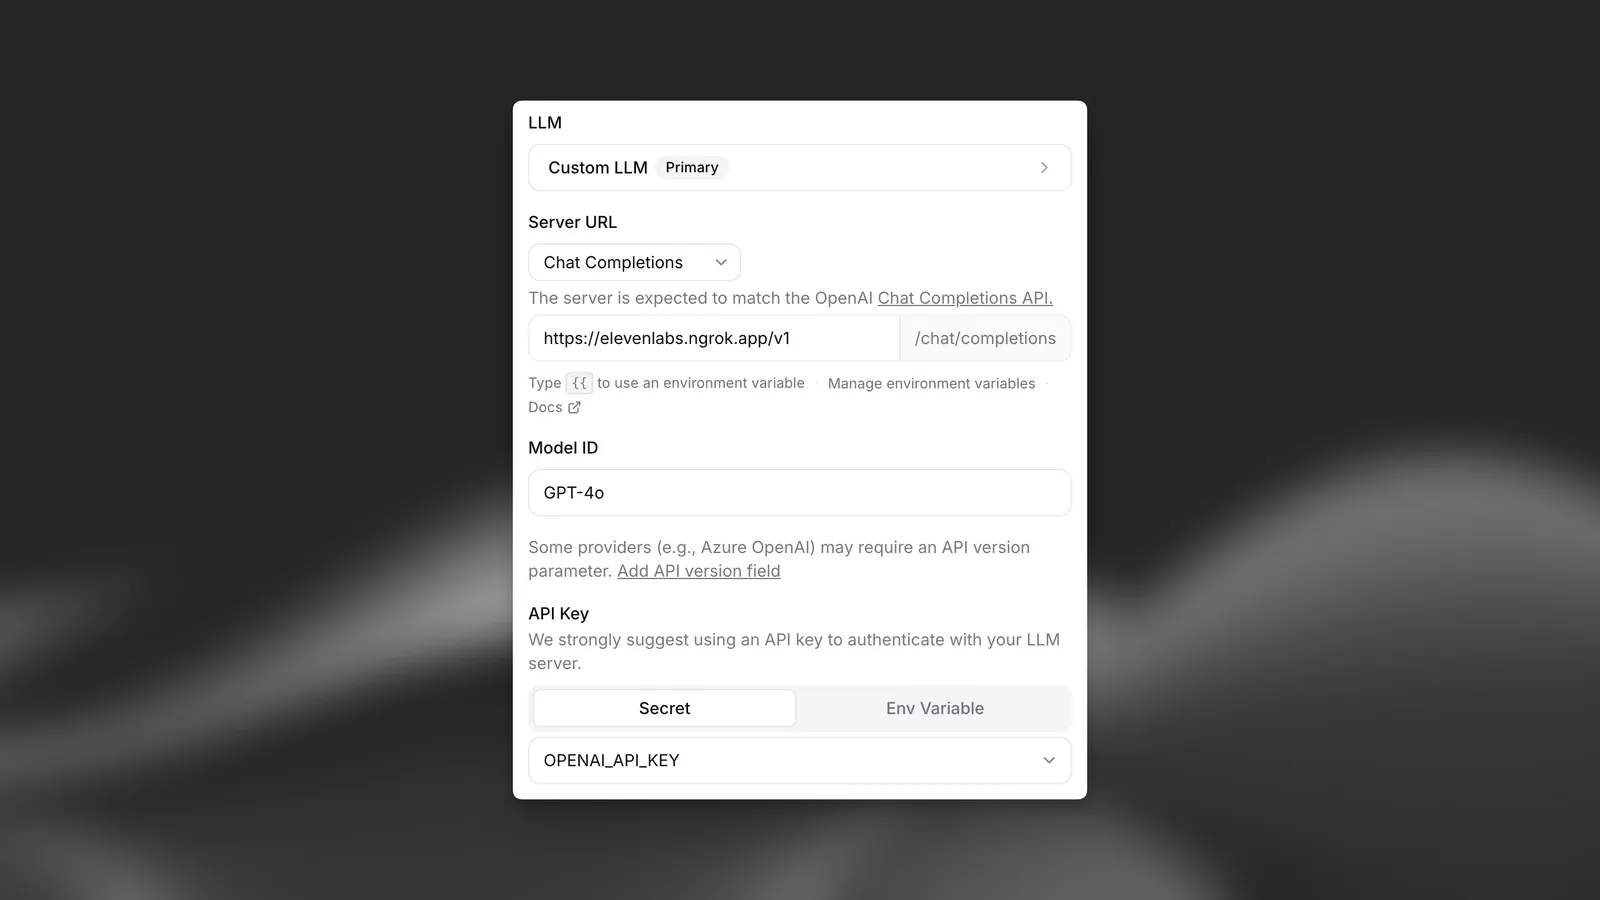
Verweisen Sie Ihre Server-URL auf den ngrok-Endpunkt und setzen Sie „Limit token usage“ auf 5000.
Sie können nun mit Ihrem Agent über Ihren eigenen LLM-Server interagieren.
Optimierung für LLMs mit langsamer Verarbeitung
Wenn Ihr benutzerdefiniertes LLM lange Verarbeitungszeiten hat (etwa aufgrund agentenbasierter Schlussfolgerungen oder Vorverarbeitungsanforderungen), können Sie den Gesprächsfluss verbessern, indem Sie Pufferwörter in Ihren Streaming-Antworten verwenden. Diese Technik trägt dazu bei, eine natürliche Sprachprosodie beizubehalten, während Ihr LLM die vollständige Antwort generiert.
Pufferwörter
Wenn Ihr LLM mehr Zeit benötigt, um die vollständige Antwort zu verarbeiten, geben Sie eine erste Antwort zurück, die mit "... " endet (Auslassungspunkte gefolgt von einem Leerzeichen). So kann das Text to Speech-System den natürlichen Fluss beibehalten, während sich das Gespräch dynamisch anfühlt.
Dadurch entstehen natürliche Pausen, die gut in nachfolgende Inhalte übergehen, über die das LLM länger nachdenken kann. Das zusätzliche Leerzeichen ist entscheidend, damit der nachfolgende Inhalt nicht an die ”…” angehängt wird, was zu Audioverzerrungen führen kann.
Implementierung
So passen Sie Ihren benutzerdefinierten LLM-Server an, um Pufferwörter zu implementieren:
Integration von Systemtools
Ihr benutzerdefiniertes LLM kann Systemtools auslösen, um Gesprächsfluss und -status zu steuern. Diese Tools werden automatisch in den Parameter tools Ihrer Chat-Completion-Anfragen aufgenommen, wenn sie in Ihrem Agenten konfiguriert sind.
Funktionsweise von Systemtools
- LLM-Entscheidung: Ihr benutzerdefiniertes LLM entscheidet anhand des Gesprächskontexts, wann diese Tools aufgerufen werden
- Tool-Antwort: Das LLM antwortet mit Funktionsaufrufen im Standard-OpenAI-Format
- Backend-Verarbeitung: ElevenLabs verarbeitet die Tool-Aufrufe und aktualisiert den Gesprächsstatus
Weitere Informationen zu Systemtools finden Sie in unserem Leitfaden
Verfügbare Systemtools
Anruf beenden
Zweck: Gespräche automatisch beenden, wenn die entsprechenden Bedingungen erfüllt sind.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- die Hauptaufgabe abgeschlossen ist und der Nutzer zufrieden ist
- das Gespräch mit beiderseitigem Einvernehmen natürlich zu Ende gegangen ist
- der Nutzer ausdrücklich angibt, das Gespräch beenden zu wollen
Parameter:
reason(String, erforderlich): Der Grund für das Beenden des Anrufsmessage(String, optional): Eine Abschiedsnachricht, die dem Nutzer vor dem Beenden des Anrufs gesendet wird
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie das Tool als Systemtool in Ihren Agenteneinstellungen. Das LLM erhält detaillierte Anweisungen dazu, wann diese Funktion aufgerufen werden soll.
Mehr erfahren: Tool zum Beenden von Anrufen
Spracherkennung
Zweck: Während Gesprächen automatisch zur erkannten Sprache des Nutzers wechseln.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- der Nutzer eine andere Sprache als die aktuelle Gesprächssprache spricht
- der Nutzer ausdrücklich darum bittet, die Sprache zu wechseln
- das Gespräch Unterstützung für mehrere Sprachen benötigt
Parameter:
reason(String, erforderlich): Der Grund für den Sprachwechsellanguage(String, erforderlich): Der Sprachcode, zu dem gewechselt werden soll (muss in der Liste der unterstützten Sprachen enthalten sein)
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie unterstützte Sprachen in den Agenteneinstellungen und fügen Sie das Systemtool für die Spracherkennung hinzu. Der Agent wechselt Stimme und Antworten automatisch passend zu den erkannten Sprachen.
Mehr erfahren: Tool zur Spracherkennung
Agentenübergabe
Zweck: Gespräche je nach Nutzerbedarf zwischen spezialisierten KI-Agenten übertragen.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- die Nutzeranfrage Spezialwissen oder andere Agentenfähigkeiten erfordert
- der aktuelle Agent die Anfrage nicht angemessen bearbeiten kann
- der Gesprächsverlauf auf den Bedarf eines anderen Agententyps hinweist
Parameter:
reason(String, optional): Der Grund für die Agentenübergabeagent_number(Ganzzahl, erforderlich): Nullbasierte Nummer des Agenten, an den übergeben werden soll (basierend auf den konfigurierten Übergaberegeln)
Format des Funktionsaufrufs:
Implementierung: Definieren Sie Übergaberegeln, die Bedingungen bestimmten Agenten-IDs zuordnen. Konfigurieren Sie, an welche Agenten der aktuelle Agent übergeben kann. Agenten werden in der Übergabekonfiguration über nullbasierte Nummern referenziert.
Mehr erfahren: Tool zur Agentenübergabe
An Menschen übergeben
Zweck: Gespräche nahtlos an menschliche Mitarbeitende übergeben, wenn KI-Unterstützung nicht ausreicht.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- komplexe Probleme menschliches Urteilsvermögen erfordern
- der Nutzer ausdrücklich menschliche Unterstützung anfordert
- die KI bei der konkreten Anfrage an die Grenzen ihrer Fähigkeiten stößt
- Eskalationsprotokolle ausgelöst werden
Parameter:
reason(String, optional): Der Grund für die Übergabetransfer_number(String, erforderlich): Die Telefonnummer, an die übergeben werden soll (muss mit den konfigurierten Nummern übereinstimmen)client_message(String, erforderlich): Nachricht, die dem Kunden während des Wartens auf die Übergabe vorgelesen wirdagent_message(String, erforderlich): Nachricht für den menschlichen Mitarbeitenden, der den Anruf entgegennimmt
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie Telefonnummern und Bedingungen für Übergaben. Definieren Sie Nachrichten für Kunden und den übernehmenden menschlichen Mitarbeitenden. Funktioniert sowohl mit Twilio als auch mit SIP-Trunking.
Mehr erfahren: Tool zur Übergabe an Menschen
Zug überspringen
Zweck: Dem Agenten ermöglichen, zu pausieren und ohne zu sprechen auf Nutzereingaben zu warten.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- der Nutzer angibt, einen Moment zu brauchen (“Geben Sie mir eine Sekunde”, “Lassen Sie mich nachdenken”)
- der Nutzer eine Pause im Gesprächsverlauf anfordert
- der Agent erkennt, dass der Nutzer Zeit braucht, um Informationen zu verarbeiten
Parameter:
reason(String, optional): Freitext-Grund, der erklärt, warum die Pause benötigt wird
Format des Funktionsaufrufs:
Implementierung: Keine zusätzliche Konfiguration erforderlich. Das Tool signalisiert dem Agenten lediglich, still zu bleiben, bis der Nutzer erneut spricht.
Mehr erfahren: Tool zum Überspringen eines Zugs
Mailbox-Erkennung
Parameter:
reason(string, erforderlich): Der Grund für die Erkennung einer Mailbox (z. B. „automatische Begrüßung erkannt“, „keine menschliche Antwort“)
Format des Funktionsaufrufs:
Mehr erfahren: Tool zur Mailbox-Erkennung
Beispielanfrage mit Systemtools
Wenn Systemtools konfiguriert sind, erhält Ihr benutzerdefiniertes LLM Anfragen, die die Tools im Standard-OpenAI-Format enthalten:
Ihr benutzerdefiniertes LLM muss Funktionsaufrufe unterstützen, um Systemtools zu verwenden. Stellen Sie sicher, dass Ihr Modell korrekte Antworten auf Funktionsaufrufe im OpenAI-Format generieren kann.
Zusätzliche Funktionen
Benutzerdefinierte LLM-Parameter
Sie können zusätzliche Parameter an Ihre benutzerdefinierte LLM-Implementierung übergeben.
Python
Beispielanfrage
Mit dieser benutzerdefinierten Nachrichteneinrichtung erhält Ihr LLM Anfragen in diesem Format: