

Integre seu próprio modelo
Conecte um agente ao seu próprio LLM ou hospede seu próprio servidor.
O LLM personalizado permite conectar suas conversas ao seu próprio LLM por meio de um endpoint externo. A ElevenLabs também oferece suporte a LLMs integrados nativamente
Os LLMs personalizados permitem que você use sua própria chave de API da OpenAI ou execute um servidor de LLM totalmente personalizado.
Um LLM personalizado não pode ser usado com um modelo em tempo real.
Visão geral
Por padrão, usamos nossas próprias credenciais internas para modelos populares, como OpenAI. Para usar um servidor de LLM personalizado, ele deve seguir uma das seguintes estruturas de solicitação/resposta compatíveis com a OpenAI:
- API Chat Completions (
/v1/chat/completions) - API Responses (
/v1/responses)
A API Responses é o formato de API mais recente da OpenAI e oferece suporte a recursos adicionais. Os dois formatos de API têm suporte completo para integração com LLMs personalizados.
Os guias a seguir abrangem os dois casos de uso:
- Use sua própria chave da OpenAI: use sua própria chave de API da OpenAI com nossa plataforma.
- Servidor de LLM personalizado: hospede e conecte sua própria implementação de servidor de LLM.
Você aprenderá a:
- Armazenar sua chave de API da OpenAI na ElevenLabs
- Hospedar um servidor que replique o endpoint Chat Completions ou Responses da OpenAI
- Direcionar a ElevenLabs ao seu endpoint personalizado
- Enviar parâmetros extras ao seu LLM conforme necessário
Resumo do raciocínio
Seu endpoint deve retornar o raciocínio separadamente da resposta final. A ElevenLabs não gera o raciocínio a partir da resposta final.
Para solicitar o raciocínio de um endpoint compatível, ative Resumo do raciocínio nas configurações de LLM do agente ou defina enable_reasoning_summary pela API.
Retornar raciocínio
Use o formato correspondente ao seu endpoint:
API Chat Completions
API Responses
Transmita o raciocínio no campo reasoning ou reasoning_content de cada delta de resposta.
Para endpoints compatíveis com Gemini, a ElevenLabs solicita pensamentos com
google.thinking_config.include_thoughts e lê o conteúdo marcado com
extra_content.google.thought.
Consulte Resumo do raciocínio para saber sobre armazenamento, entrega e limitações.
Usando sua própria chave da OpenAI
Para integrar uma chave personalizada da OpenAI, atualize as configurações do seu agente no painel da ElevenLabs para apontar para seu servidor de LLM personalizado e crie um segredo com sua OPENAI_API_KEY:
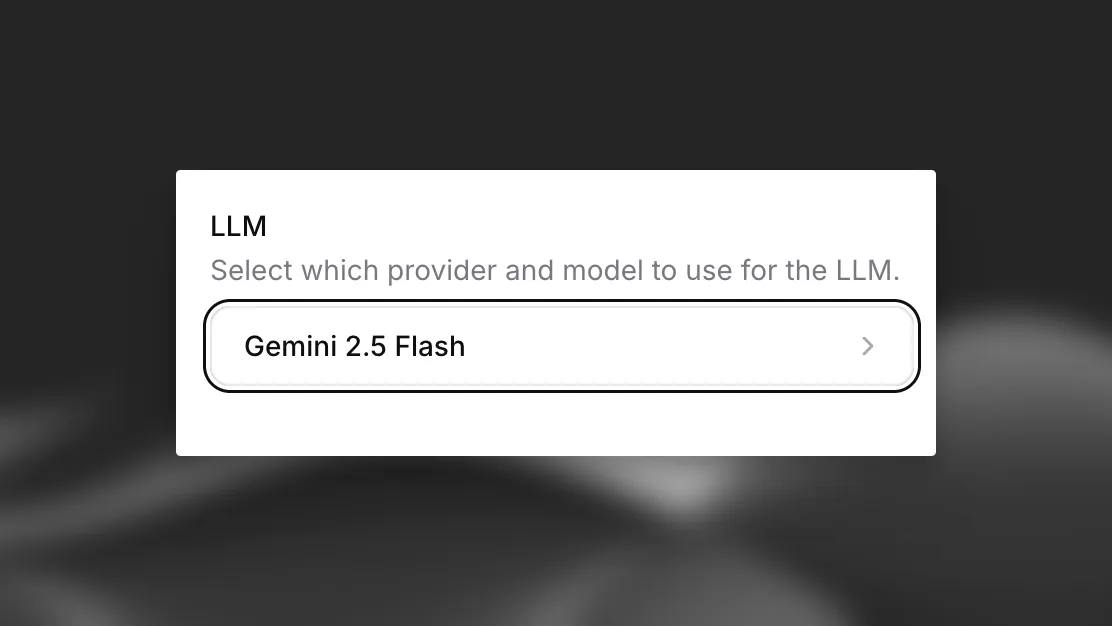
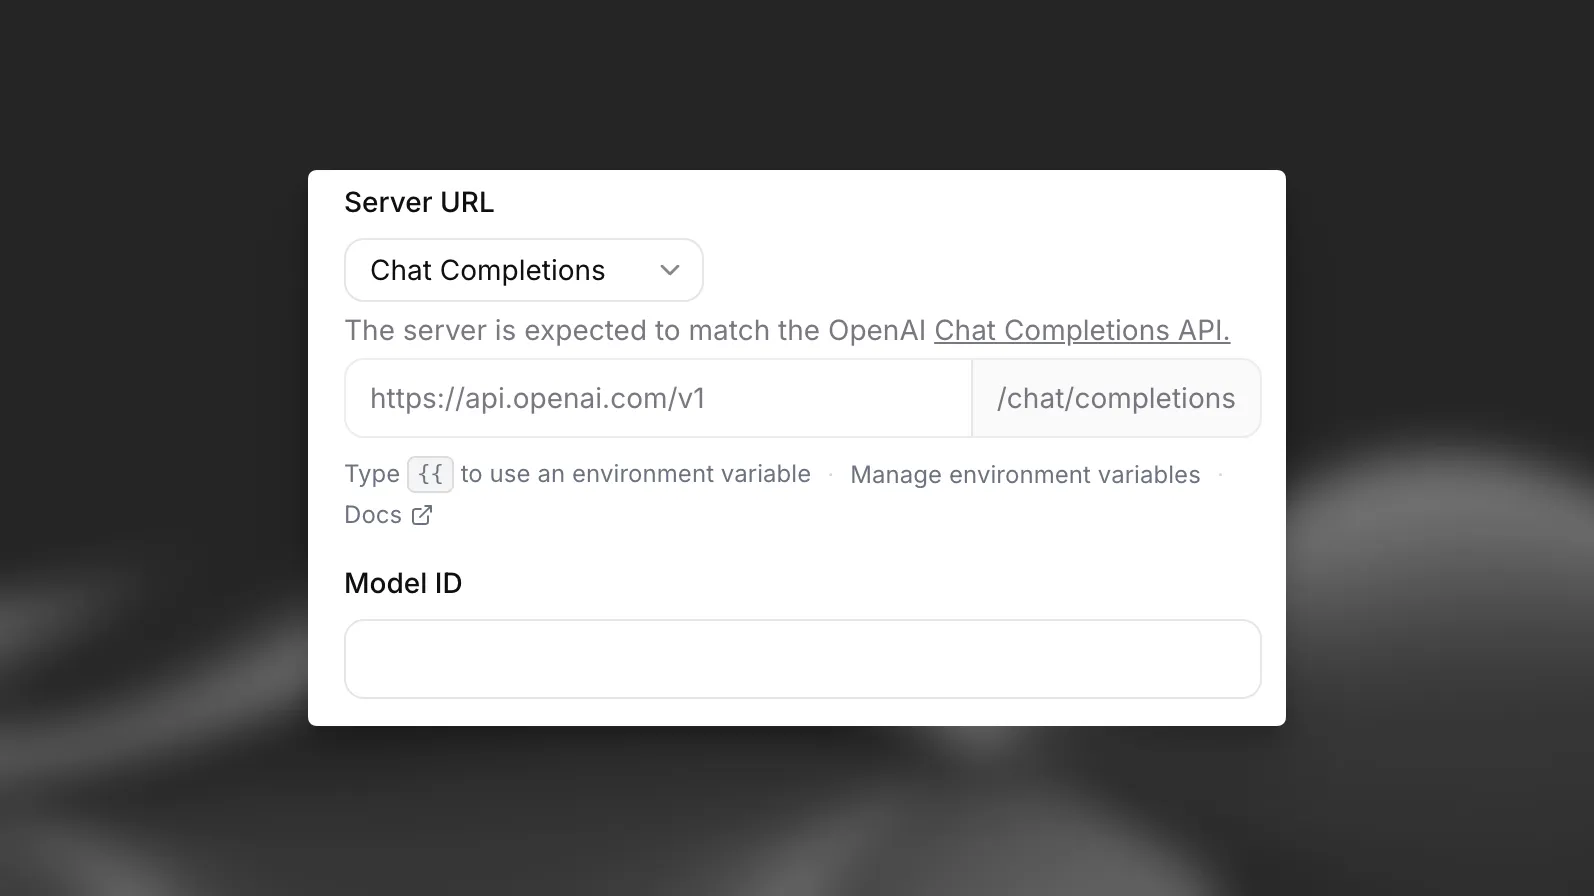
Nas configurações do Agente no painel da ElevenLabs, selecione “Custom LLM” no menu suspenso “LLM” à direita.
Servidor de LLM personalizado
Para usar um servidor de LLM personalizado, configure um endpoint de servidor compatível no estilo da OpenAI. Você pode implementar a API Chat Completions (/v1/chat/completions) ou a API Responses (/v1/responses).
Ambos os endpoints devem retornar respostas no formato SSE (Server-Sent Events), com Content-Type: text/event-stream.
API Chat Completions
API Responses
A API Chat Completions usa o endpoint /v1/chat/completions.
Cada bloco deve ser formatado como data: {json}\n\n, e o stream deve terminar com data: [DONE]\n\n.
Veja um exemplo de implementação de servidor:
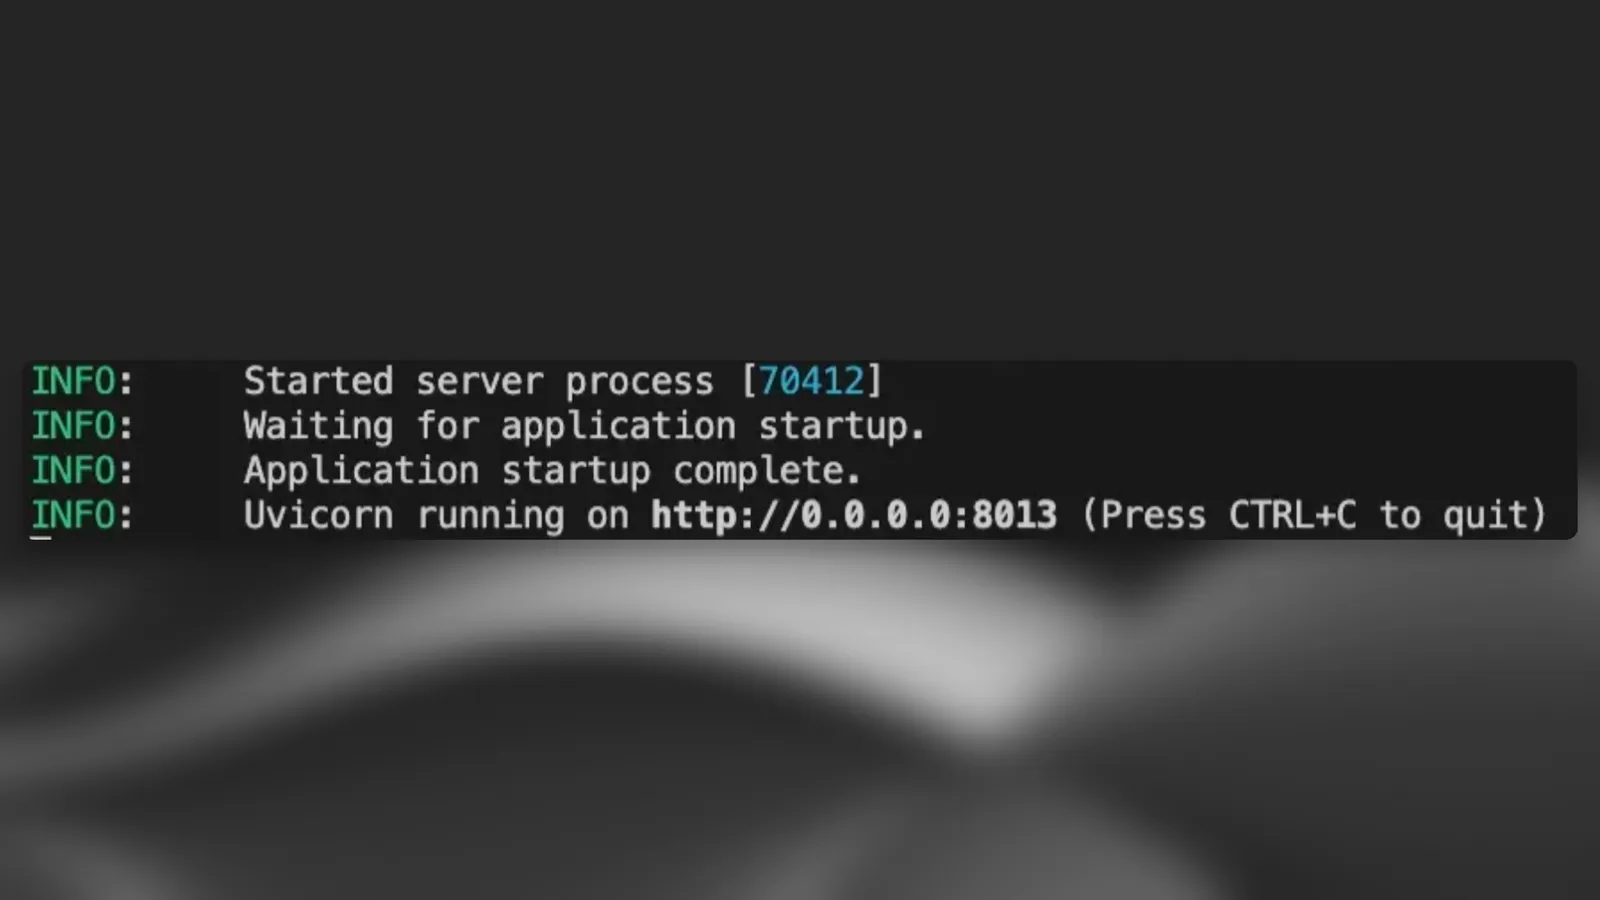
Execute esse código ou o código do seu próprio servidor.
Configurar uma URL pública para seu servidor
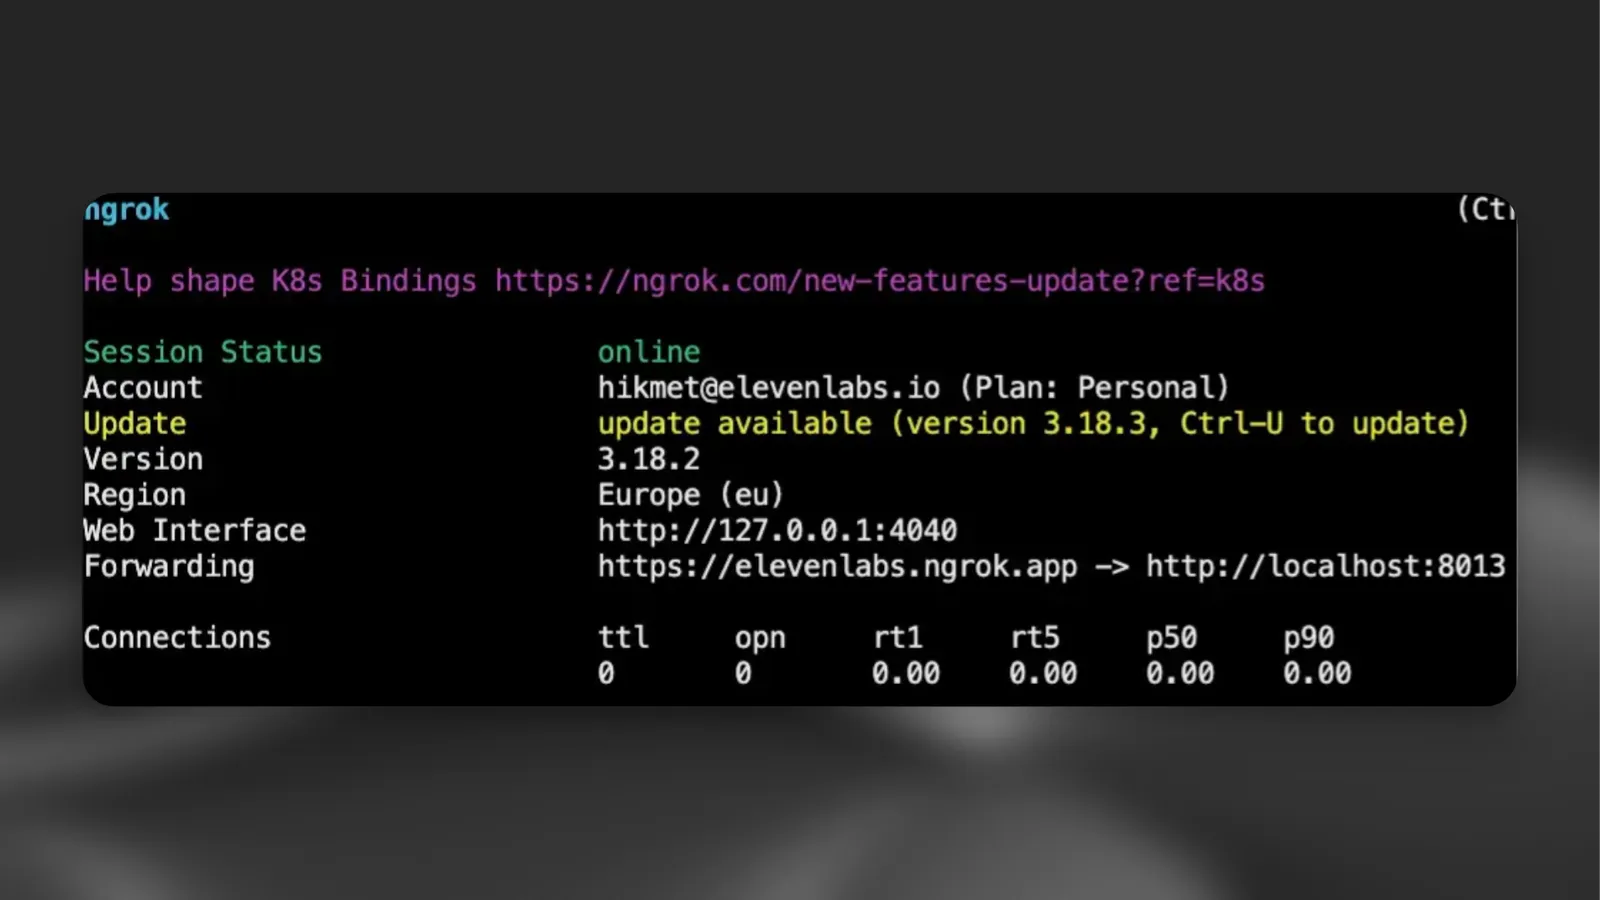
Para tornar seu servidor acessível, crie uma URL pública usando uma ferramenta de tunelamento como o ngrok:
Configurar o CustomLLM da ElevenLabs
Em seguida, atualize as configurações do seu agente no painel da ElevenLabs para apontar para seu servidor de LLM personalizado.
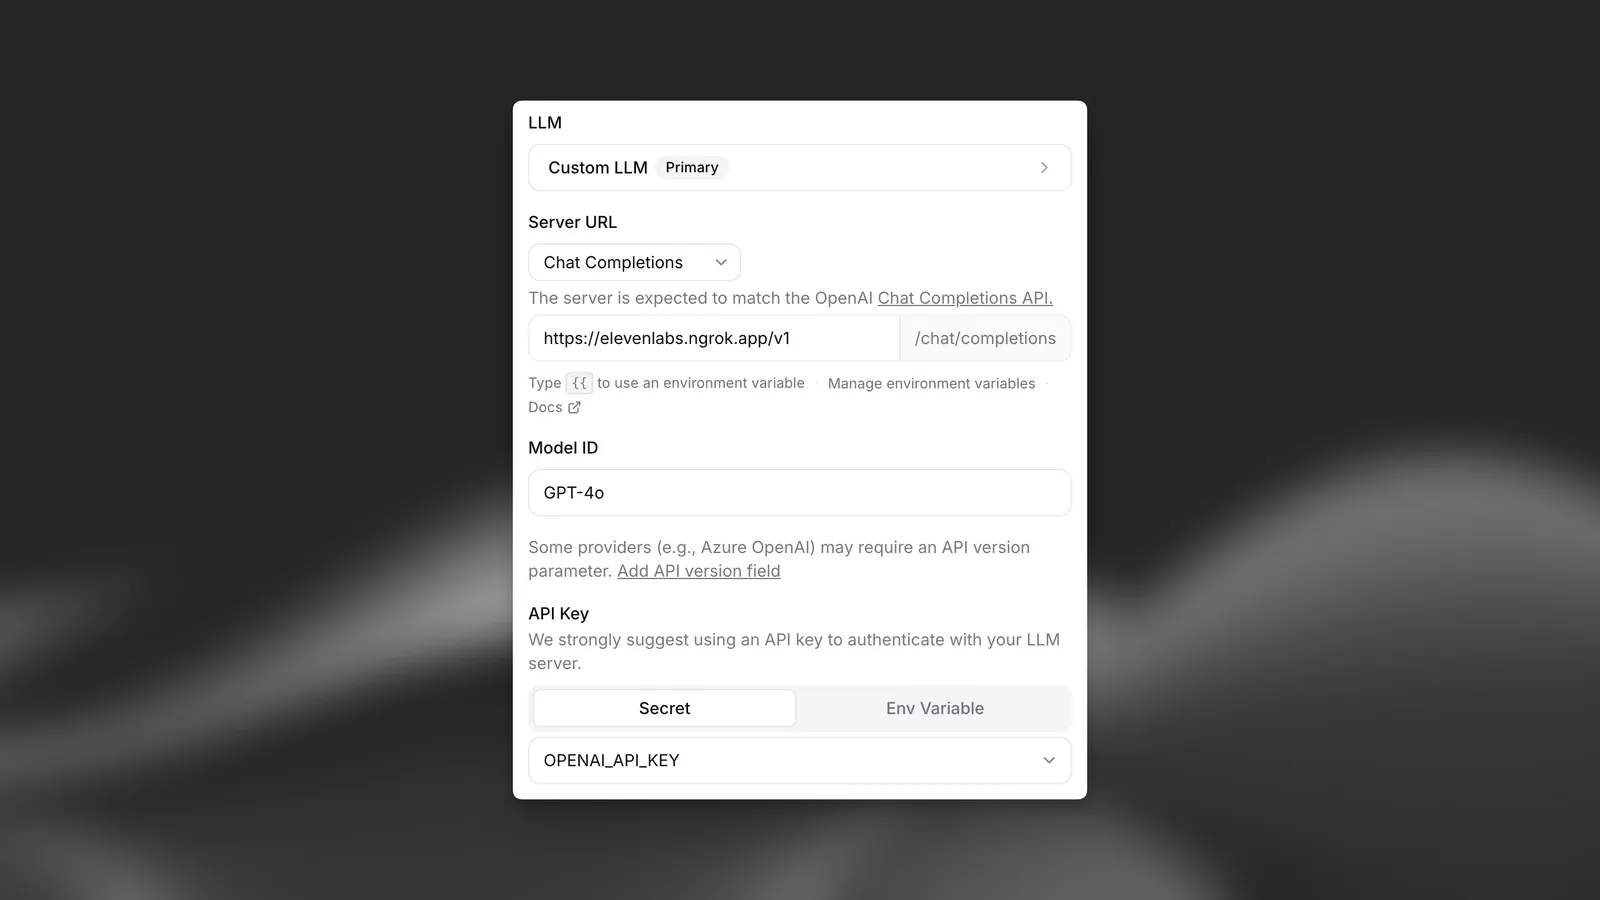
Direcione a URL do seu servidor ao endpoint do ngrok e defina “Limit token usage” como 5000.
Agora você pode começar a interagir com seu agente usando seu próprio servidor de LLM.
Otimização para LLMs com processamento lento
Se o seu LLM personalizado tiver tempos de processamento lentos (talvez devido a raciocínio agêntico ou requisitos de pré-processamento), você poderá melhorar o fluxo da conversa implementando palavras de preenchimento nas suas respostas em streaming. Essa técnica ajuda a manter a prosódia natural da fala enquanto o LLM gera a resposta completa.
Palavras de preenchimento
Quando o LLM precisar de mais tempo para processar a resposta completa, retorne uma resposta inicial terminando com "... " (reticências seguidas de um espaço). Isso permite que o sistema de Text to Speech mantenha um fluxo natural e deixe a conversa dinâmica.
Isso cria pausas naturais que se conectam bem ao conteúdo subsequente sobre o qual o LLM pode raciocinar por mais tempo. O espaço extra é essencial para garantir que o conteúdo subsequente não seja anexado a "...", o que pode causar distorções no áudio.
Implementação
Veja como modificar seu servidor de LLM personalizado para implementar palavras de preenchimento:
Integração de ferramentas do sistema
Seu LLM personalizado pode acionar ferramentas do sistema para controlar o fluxo e o estado da conversa. Essas ferramentas são incluídas automaticamente no parâmetro tools das suas solicitações de conclusão de chat quando configuradas no seu agente.
Como as ferramentas do sistema funcionam
- Decisão do LLM: seu LLM personalizado decide quando chamar essas ferramentas com base no contexto da conversa
- Resposta da ferramenta: o LLM responde com chamadas de função no formato padrão da OpenAI
- Processamento de backend: a ElevenLabs processa as chamadas de ferramenta e atualiza o estado da conversa
Para mais informações sobre ferramentas do sistema, consulte nosso guia
Ferramentas do sistema disponíveis
Encerrar chamada
Objetivo: encerrar automaticamente conversas quando as condições adequadas forem atendidas.
Condições de acionamento: o LLM deve chamar esta ferramenta quando:
- A tarefa principal foi concluída e o usuário está satisfeito
- A conversa chegou a uma conclusão natural com concordância mútua
- O usuário indica explicitamente que deseja encerrar a conversa
Parâmetros:
reason(string, obrigatório): o motivo para encerrar a chamadamessage(string, opcional): uma mensagem de despedida para enviar ao usuário antes de encerrar a chamada
Formato da chamada de função:
Implementação: configure como uma ferramenta do sistema nas configurações do seu agente. O LLM receberá instruções detalhadas sobre quando chamar esta função.
Saiba mais: ferramenta de encerramento de chamada
Detecção de idioma
Objetivo: mudar automaticamente para o idioma detectado do usuário durante as conversas.
Condições de acionamento: o LLM deve chamar esta ferramenta quando:
- O usuário fala em um idioma diferente do idioma atual da conversa
- O usuário solicita explicitamente a troca de idioma
- É necessário suporte a vários idiomas para a conversa
Parâmetros:
reason(string, obrigatório): o motivo para a troca de idiomalanguage(string, obrigatório): o código do idioma para o qual mudar (deve estar na lista de idiomas compatíveis)
Formato da chamada de função:
Implementação: configure os idiomas compatíveis nas configurações do agente e adicione a ferramenta do sistema de detecção de idioma. O agente mudará automaticamente a voz e as respostas para corresponder aos idiomas detectados.
Saiba mais: ferramenta de detecção de idioma
Transferência de agente
Objetivo: transferir conversas entre agentes de IA especializados com base nas necessidades do usuário.
Condições de acionamento: o LLM deve chamar esta ferramenta quando:
- A solicitação do usuário exigir conhecimento especializado ou recursos de outro agente
- O agente atual não puder lidar adequadamente com a consulta
- O fluxo da conversa indicar a necessidade de outro tipo de agente
Parâmetros:
reason(string, opcional): o motivo da transferência de agenteagent_number(integer, obrigatório): número com índice zero do agente para o qual transferir (com base nas regras de transferência configuradas)
Formato da chamada de função:
Implementação: defina regras de transferência que mapeiem condições para IDs específicos de agentes. Configure para quais agentes o agente atual pode transferir. Os agentes são referenciados por números com índice zero na configuração de transferência.
Saiba mais: ferramenta de transferência de agente
Transferir para um humano
Objetivo: encaminhar conversas sem interrupções para operadores humanos quando a assistência de IA não for suficiente.
Condições de acionamento: o LLM deve chamar esta ferramenta quando:
- Houver problemas complexos que exijam julgamento humano
- O usuário solicitar explicitamente assistência humana
- A IA atingir os limites de capacidade para a solicitação específica
- Protocolos de escalonamento forem acionados
Parâmetros:
reason(string, opcional): o motivo da transferênciatransfer_number(string, obrigatório): o número de telefone para o qual transferir (deve corresponder aos números configurados)client_message(string, obrigatório): mensagem lida ao cliente enquanto aguarda a transferênciaagent_message(string, obrigatório): mensagem para o operador humano que recebe a chamada
Formato da chamada de função:
Implementação: configure números de telefone e condições de transferência. Defina mensagens tanto para o cliente quanto para o operador humano que receberá a chamada. Funciona com Twilio e entroncamento SIP.
Saiba mais: ferramenta de transferência para humano
Pular turno
Objetivo: permitir que o agente pause e aguarde a entrada do usuário sem falar.
Condições de acionamento: o LLM deve chamar esta ferramenta quando:
- O usuário indicar que precisa de um momento (“Me dê um segundo”, “Deixe-me pensar”)
- O usuário solicitar uma pausa no fluxo da conversa
- O agente detectar que o usuário precisa de tempo para processar informações
Parâmetros:
reason(string, opcional): motivo livre que explica por que a pausa é necessária
Formato da chamada de função:
Implementação: nenhuma configuração adicional é necessária. A ferramenta apenas sinaliza para o agente permanecer em silêncio até que o usuário fale novamente.
Saiba mais: ferramenta de pular turno
Detecção de caixa postal
Parâmetros:
reason(string, obrigatório): o motivo para detectar a caixa postal (por exemplo, “saudação automática detectada”, “nenhuma resposta humana”)
Formato de chamada da função:
Saiba mais: ferramenta de detecção de caixa postal
Exemplo de solicitação com ferramentas do sistema
Quando as ferramentas do sistema estiverem configuradas, seu LLM personalizado receberá solicitações que incluem as ferramentas no formato padrão da OpenAI:
Seu LLM personalizado deve oferecer suporte a chamadas de função para usar ferramentas do sistema. Garanta que seu modelo possa gerar respostas adequadas de chamada de função no formato da OpenAI.
Recursos adicionais
Parâmetros de LLM personalizado
Você pode passar parâmetros adicionais para sua implementação de LLM personalizado.
Python
Exemplo de solicitação
Com essa configuração de mensagem personalizada, seu LLM receberá solicitações neste formato: