

Integreer je eigen model
Met Custom LLM kun je je gesprekken via een extern endpoint koppelen aan je eigen LLM. ElevenLabs ondersteunt ook native geïntegreerde LLM’s
Met Custom LLM’s kun je je eigen OpenAI API-sleutel gebruiken of een volledig eigen LLM-server uitvoeren.
Een custom LLM kan niet worden gebruikt met een Realtime model.
Overzicht
Standaard gebruiken we onze eigen interne credentials voor populaire modellen zoals OpenAI. Om een custom LLM-server te gebruiken, moet deze voldoen aan een van de volgende OpenAI-compatibele request-/responsestructuren:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
De Responses API is de nieuwere API-indeling van OpenAI die aanvullende functies ondersteunt. Beide API-indelingen worden volledig ondersteund voor custom LLM-integratie.
De volgende handleidingen behandelen beide use cases:
- Gebruik je eigen OpenAI-sleutel: Gebruik je eigen OpenAI API-sleutel met ons platform.
- Custom LLM-server: Host en koppel je eigen implementatie van een LLM-server.
Je leert hoe je:
- Je OpenAI API-sleutel opslaat in ElevenLabs
- Een server host die het Chat Completions- of Responses-endpoint van OpenAI nabootst
- ElevenLabs naar je custom endpoint verwijst
- Naar behoefte extra parameters doorgeeft aan je LLM
Samenvatting van redenering
Je endpoint moet de redenering los van het definitieve antwoord retourneren. ElevenLabs genereert geen redenering op basis van het definitieve antwoord.
Om redenering aan te vragen bij een ondersteund endpoint, schakel je Samenvatting van redenering in bij de LLM-instellingen van de agent of stel je enable_reasoning_summary in via de API.
Redenering retourneren
Gebruik de indeling die bij je endpoint past:
Chat Completions API
Responses API
Stream redenering in het veld reasoning of reasoning_content van elke responsdelta.
Voor Gemini-compatibele endpoints vraagt ElevenLabs gedachten op met
google.thinking_config.include_thoughts en leest het inhoud die is gemarkeerd met
extra_content.google.thought.
Zie Samenvatting van redenering voor opslag, levering en beperkingen.
Je eigen OpenAI-sleutel gebruiken
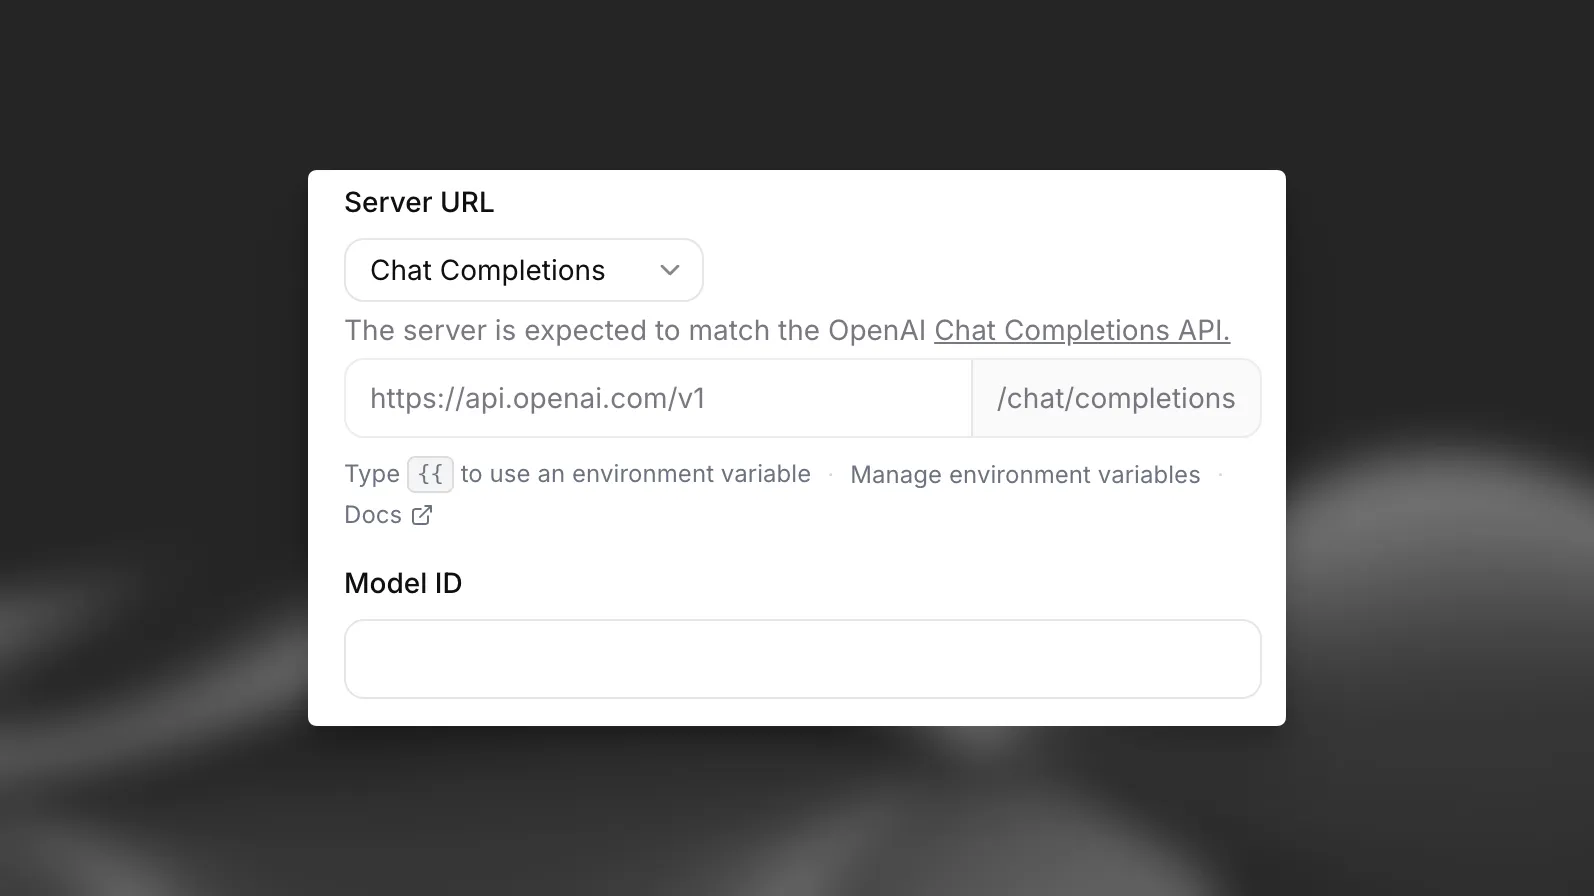
Om een custom OpenAI-sleutel te integreren, werk je de instellingen van je agent in het ElevenLabs-dashboard bij zodat deze naar je custom LLM-server verwijzen, en maak je een secret met je OPENAI_API_KEY:
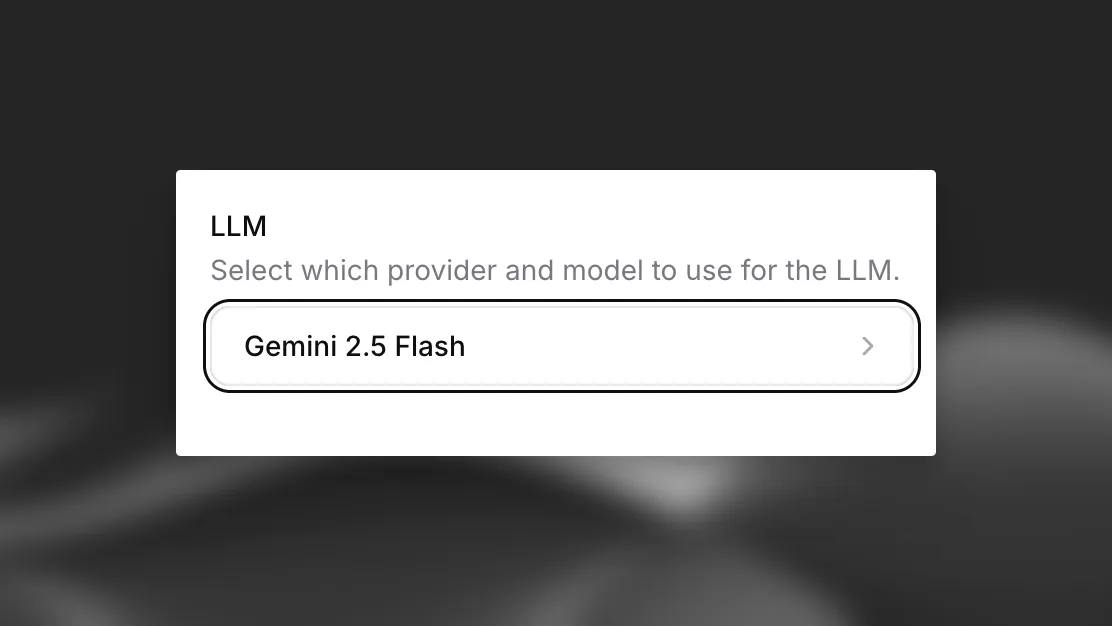
Selecteer in de Agent-instellingen in het ElevenLabs-dashboard “Custom LLM” in het dropdownmenu “LLM” aan de rechterkant.
Custom LLM-server
Om een custom LLM-server te gebruiken, stel je een compatibel serverendpoint in volgens de stijl van OpenAI. Je kunt de Chat Completions API (/v1/chat/completions) of de Responses API (/v1/responses) implementeren.
Beide endpoints moeten reacties retourneren in SSE-indeling (Server-Sent Events) met Content-Type: text/event-stream.
Chat Completions API
Responses API
De Chat Completions API gebruikt het endpoint /v1/chat/completions.
Elk chunk moet de indeling data: {json}\n\n hebben en de stream moet eindigen met data: [DONE]\n\n.
Hier is een voorbeeld van een serverimplementatie:
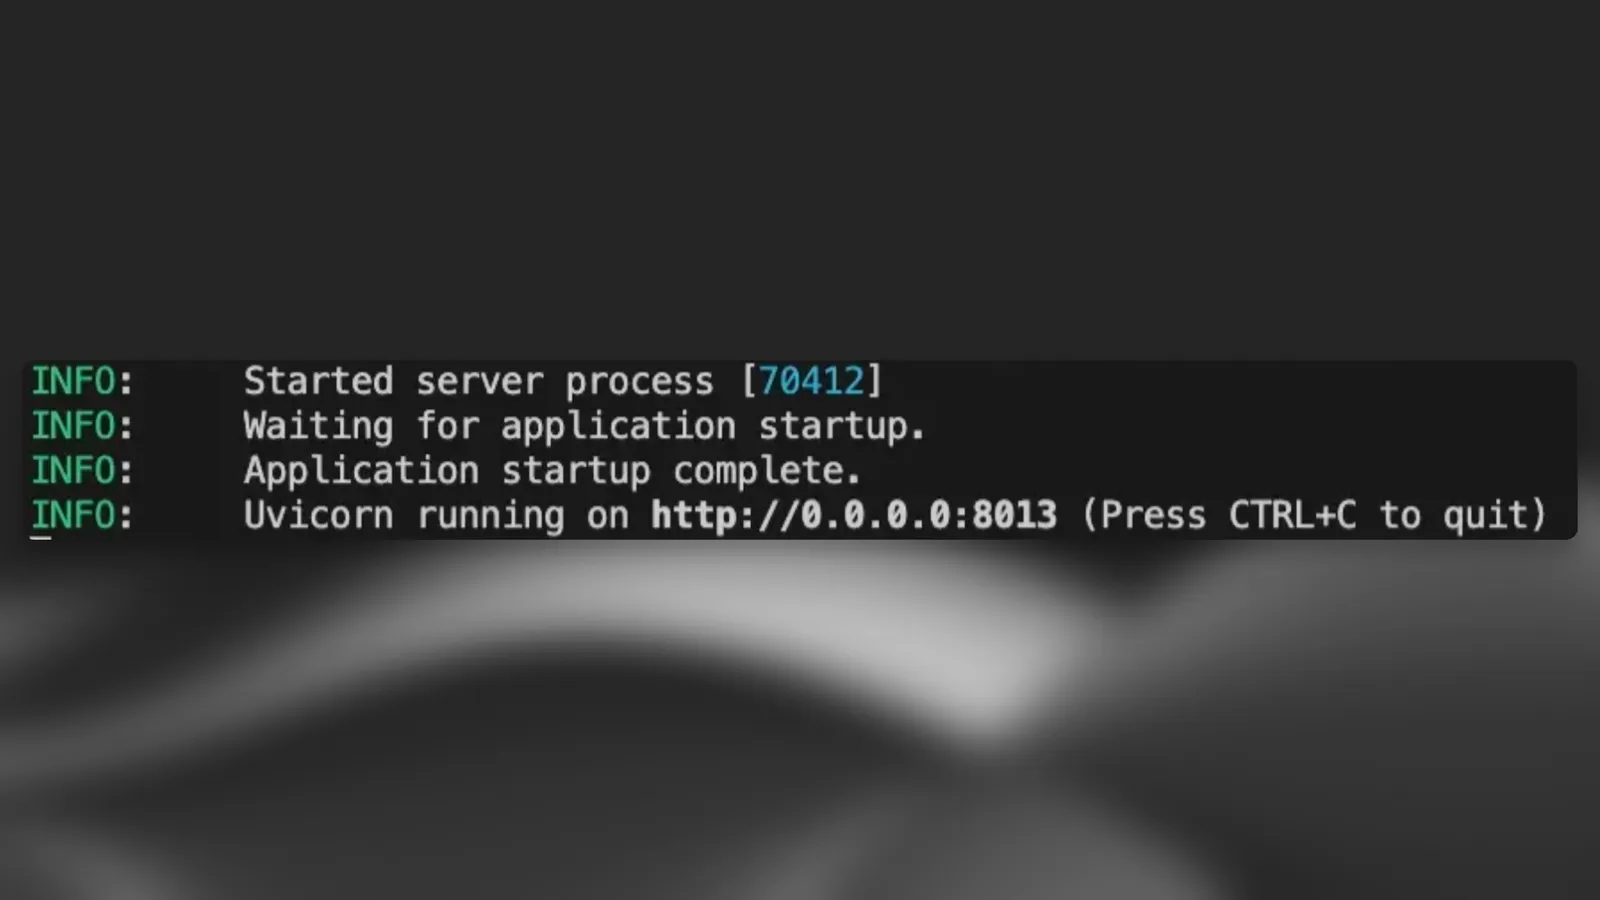
Voer deze code of je eigen servercode uit.
Een openbare URL instellen voor je server
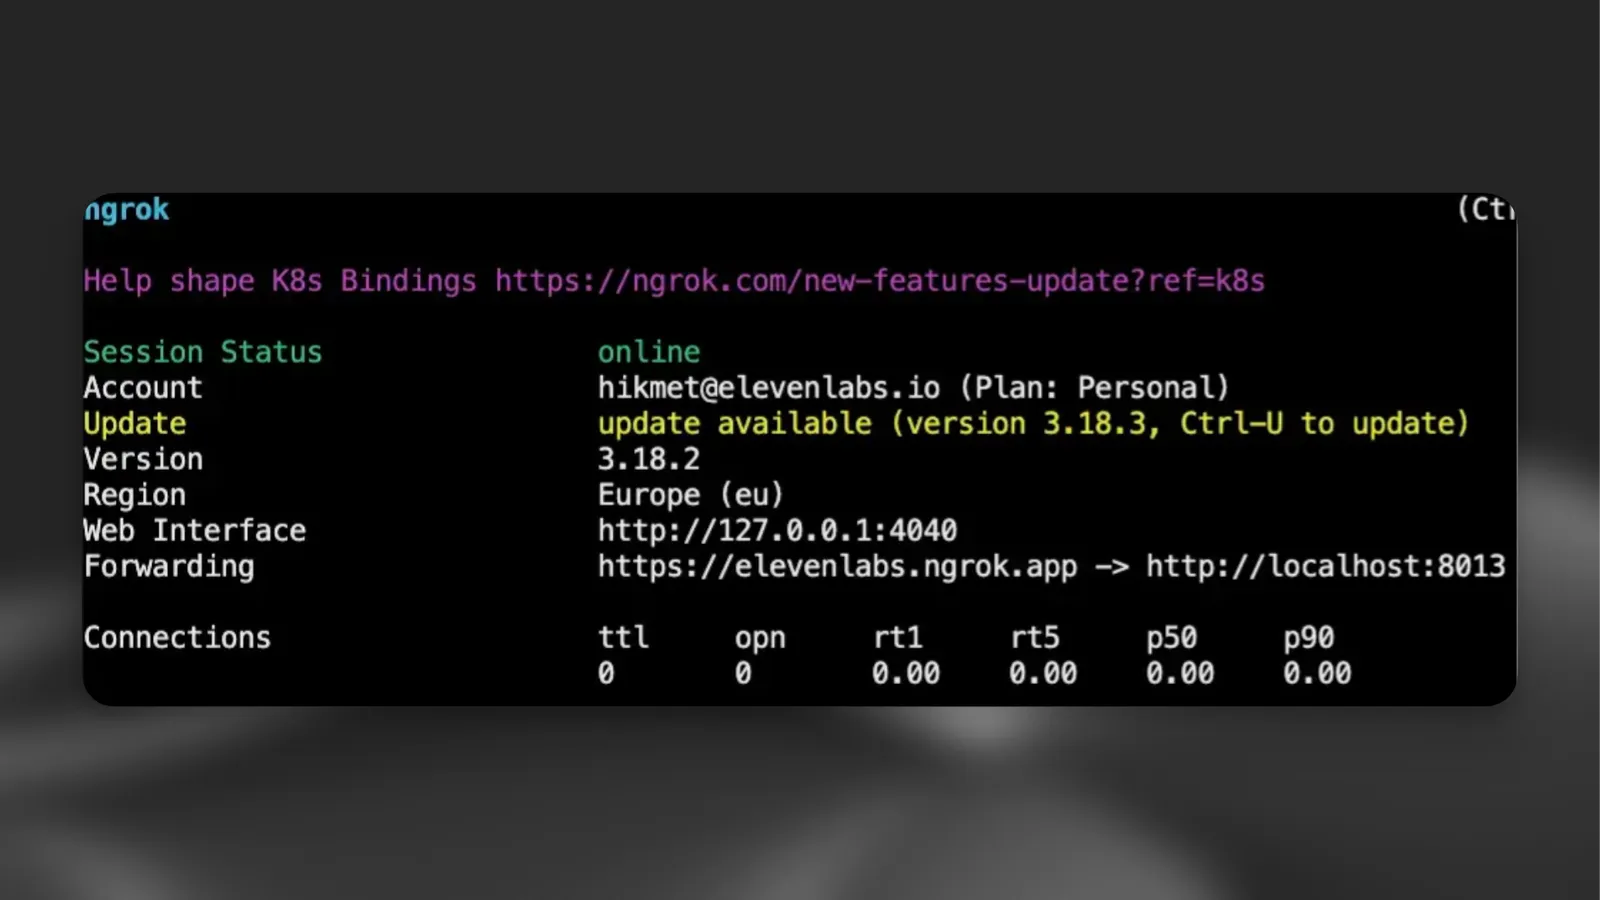
Maak je server toegankelijk door met een tunnelingtool zoals ngrok een openbare URL te maken:
ElevenLabs CustomLLM configureren
Werk vervolgens de instellingen van je agent in het ElevenLabs-dashboard bij zodat deze naar je custom LLM-server verwijzen.
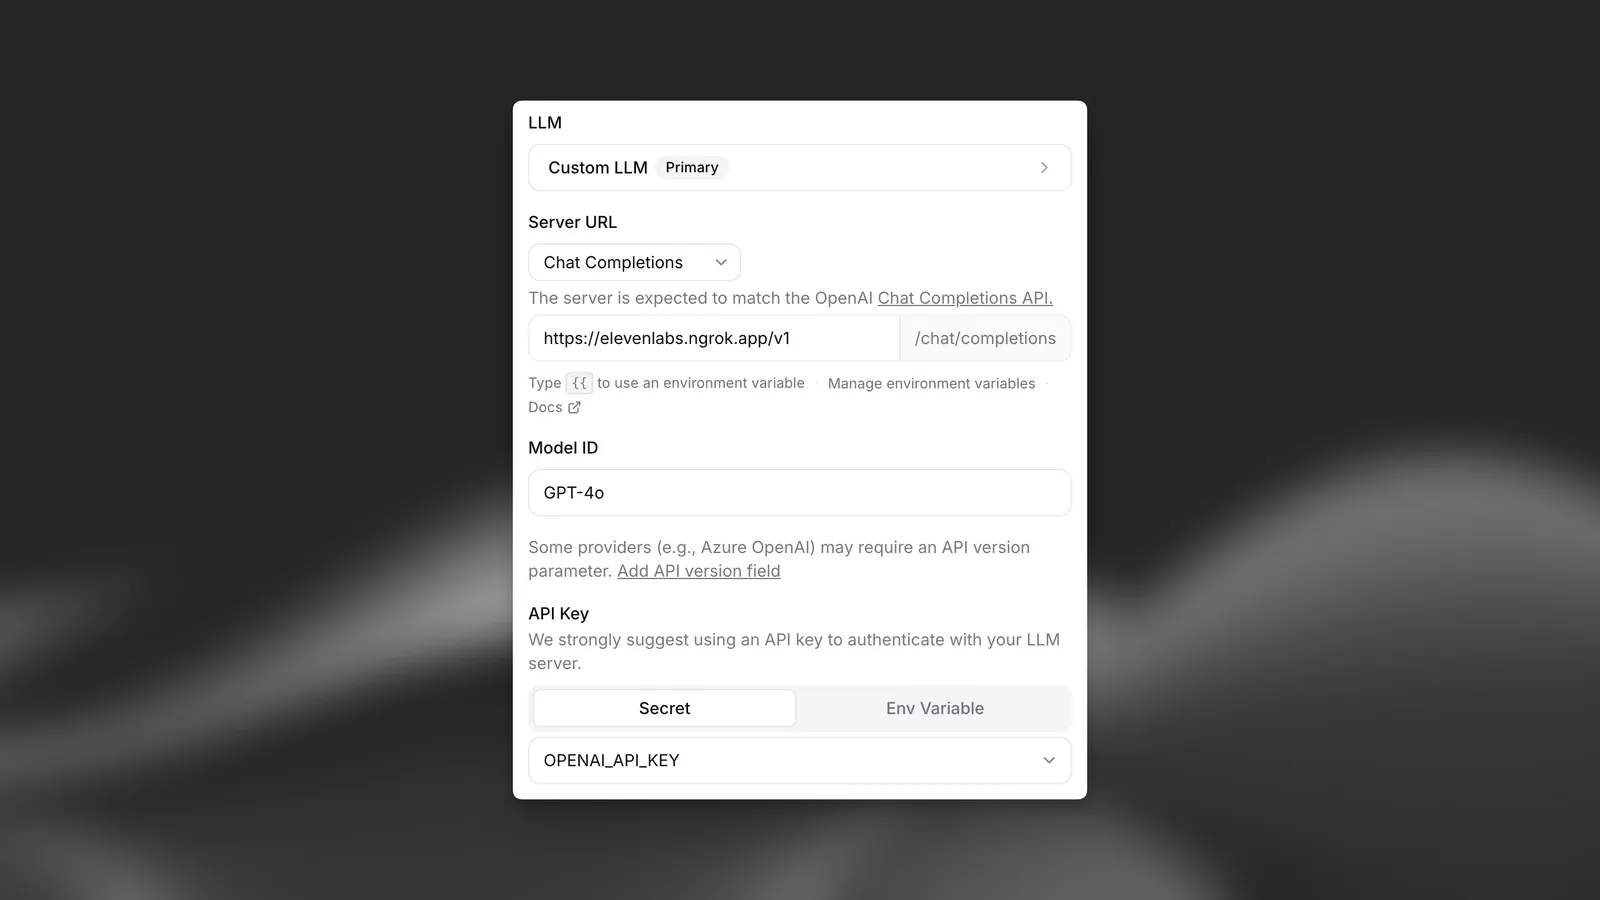
Verwijs je server-URL naar het ngrok-endpoint en stel “Limit token usage” in op 5000.
Je kunt nu met je agent communiceren via je eigen LLM-server.
Optimaliseren voor LLM’s met trage verwerking
Als je aangepaste LLM trage verwerkingstijden heeft (bijvoorbeeld door agentisch redeneren of vereisten voor voorverwerking), kun je de gespreksflow verbeteren door bufferwoorden in je streamingreacties te implementeren. Deze techniek helpt de natuurlijke spraakprosodie te behouden terwijl je LLM de volledige reactie genereert.
Bufferwoorden
Wanneer je LLM meer tijd nodig heeft om de volledige reactie te verwerken, retourneer je een eerste reactie die eindigt op "... " (beletselteken gevolgd door een spatie). Zo kan het Text to Speech-systeem de natuurlijke flow behouden en blijft het gesprek dynamisch aanvoelen.
Hierdoor ontstaan natuurlijke pauzes die goed overgaan in volgende content waarover de LLM langer kan redeneren. De extra spatie is cruciaal om te voorkomen dat de volgende content aan de ”…” wordt toegevoegd, wat tot audiovervormingen kan leiden.
Implementatie
Zo pas je je aangepaste LLM-server aan om bufferwoorden te implementeren:
Integratie van systeemtools
Je aangepaste LLM kan systeemtools activeren om de gespreksflow en -status te beheren. Deze tools worden automatisch opgenomen in de parameter tools van je chat completion-requests wanneer ze in je agent zijn geconfigureerd.
Hoe systeemtools werken
- LLM-beslissing: Je aangepaste LLM bepaalt op basis van de gesprekscontext wanneer deze tools moeten worden aangeroepen
- Toolreactie: De LLM reageert met functieaanroepen in de standaardindeling van OpenAI
- Backendverwerking: ElevenLabs verwerkt de toolaanroepen en werkt de gespreksstatus bij
Zie voor meer informatie over systeemtools onze gids
Beschikbare systeemtools
Gesprek beëindigen
Doel: Gesprekken automatisch beëindigen wanneer aan de juiste voorwaarden is voldaan.
Voorwaarden voor activering: De LLM moet deze tool aanroepen wanneer:
- De hoofdtaak is voltooid en de gebruiker tevreden is
- Het gesprek op natuurlijke wijze en met wederzijdse instemming is afgerond
- De gebruiker expliciet aangeeft het gesprek te willen beëindigen
Parameters:
reason(string, vereist): De reden om het gesprek te beëindigenmessage(string, optioneel): Een afscheidsbericht dat vóór het beëindigen van het gesprek naar de gebruiker wordt gestuurd
Indeling van functieaanroep:
Implementatie: Configureer deze als systeemtool in je agentinstellingen. De LLM ontvangt gedetailleerde instructies over wanneer deze functie moet worden aangeroepen.
Meer informatie: Tool voor gesprek beëindigen
Taaldetectie
Doel: Tijdens gesprekken automatisch overschakelen naar de gedetecteerde taal van de gebruiker.
Voorwaarden voor activering: De LLM moet deze tool aanroepen wanneer:
- De gebruiker in een andere taal spreekt dan de huidige gesprekstaal
- De gebruiker expliciet vraagt om van taal te wisselen
- Meertalige ondersteuning nodig is voor het gesprek
Parameters:
reason(string, vereist): De reden voor de taalwissellanguage(string, vereist): De taalcode om naar over te schakelen (moet in de lijst met ondersteunde talen staan)
Indeling van functieaanroep:
Implementatie: Configureer ondersteunde talen in de agentinstellingen en voeg de systeemtool voor taaldetectie toe. De agent schakelt automatisch van stem en reacties om overeen te komen met de gedetecteerde talen.
Meer informatie: Tool voor taaldetectie
Agentoverdracht
Doel: Gesprekken overdragen tussen gespecialiseerde AI-agents op basis van de behoeften van de gebruiker.
Voorwaarden voor activering: De LLM moet deze tool aanroepen wanneer:
- Het verzoek van de gebruiker gespecialiseerde kennis of andere agentmogelijkheden vereist
- De huidige agent de vraag niet adequaat kan afhandelen
- De gespreksflow aangeeft dat een ander agenttype nodig is
Parameters:
reason(string, optioneel): De reden voor de agentoverdrachtagent_number(integer, vereist): Het vanaf nul geïndexeerde nummer van de agent waarnaar moet worden overgedragen (op basis van geconfigureerde overdrachtsregels)
Indeling van functieaanroep:
Implementatie: Definieer overdrachtsregels die voorwaarden aan specifieke agent-ID’s koppelen. Configureer naar welke agents de huidige agent kan overdragen. Agents worden in de overdrachtsconfiguratie aangeduid met vanaf nul geïndexeerde nummers.
Meer informatie: Tool voor agentoverdracht
Overdragen aan een medewerker
Doel: Gesprekken soepel doorgeven aan menselijke medewerkers wanneer AI-ondersteuning niet toereikend is.
Voorwaarden voor activering: De LLM moet deze tool aanroepen wanneer:
- Er complexe problemen zijn die menselijk oordeel vereisen
- De gebruiker expliciet om menselijke hulp vraagt
- AI de grenzen van zijn mogelijkheden voor het specifieke verzoek bereikt
- Escalatieprotocollen worden geactiveerd
Parameters:
reason(string, optioneel): De reden voor de overdrachttransfer_number(string, vereist): Het telefoonnummer waarnaar moet worden doorverbonden (moet overeenkomen met geconfigureerde nummers)client_message(string, vereist): Bericht dat aan de klant wordt voorgelezen tijdens het wachten op de overdrachtagent_message(string, vereist): Bericht voor de menselijke medewerker die het gesprek ontvangt
Indeling van functieaanroep:
Implementatie: Configureer telefoonnummers en voorwaarden voor overdracht. Definieer berichten voor zowel de klant als de ontvangende menselijke medewerker. Werkt met zowel Twilio als SIP trunking.
Meer informatie: Tool voor overdragen aan een medewerker
Beurt overslaan
Doel: De agent laten pauzeren en op invoer van de gebruiker laten wachten zonder te spreken.
Voorwaarden voor activering: De LLM moet deze tool aanroepen wanneer:
- De gebruiker aangeeft een moment nodig te hebben (“Geef me even”, “Laat me nadenken”)
- De gebruiker vraagt om een pauze in de gespreksflow
- De agent detecteert dat de gebruiker tijd nodig heeft om informatie te verwerken
Parameters:
reason(string, optioneel): Vrije tekst die uitlegt waarom de pauze nodig is
Indeling van functieaanroep:
Implementatie: Er is geen aanvullende configuratie nodig. De tool geeft de agent alleen het signaal stil te blijven totdat de gebruiker opnieuw spreekt.
Meer informatie: Tool voor beurt overslaan
Voicemaildetectie
Parameters:
reason(string, verplicht): De reden voor het detecteren van voicemail (bijvoorbeeld “geautomatiseerde begroeting gedetecteerd”, “geen menselijke reactie”)
Indeling van functieaanroep:
Meer informatie: Tool voor voicemaildetectie
Voorbeeldrequest met systeemtools
Wanneer systeemtools zijn geconfigureerd, ontvangt je aangepaste LLM requests die de tools in de standaardindeling van OpenAI bevatten:
Je aangepaste LLM moet functieaanroepen ondersteunen om systeemtools te gebruiken. Zorg dat je model correcte reacties voor functieaanroepen in OpenAI-indeling kan genereren.
Aanvullende functies
Aangepaste LLM-parameters
Je kunt aanvullende parameters doorgeven aan je aangepaste LLM-implementatie.