

Integra tu propio modelo
Custom LLM te permite conectar tus conversaciones a tu propio LLM mediante una ruta de API externa. ElevenLabs también admite LLM integrados de forma nativa
Los LLM personalizados te permiten usar tu propia clave de API de OpenAI o ejecutar un servidor LLM totalmente personalizado.
No puedes usar un LLM personalizado con un modelo Realtime.
Información general
De forma predeterminada, usamos nuestras propias credenciales internas para modelos populares como OpenAI. Para usar un servidor LLM personalizado, debe ajustarse a una de las siguientes estructuras de solicitud/respuesta compatibles con OpenAI:
- API de Chat Completions (
/v1/chat/completions) - API de Responses (
/v1/responses)
La API de Responses es el formato de API más reciente de OpenAI y admite funciones adicionales. Ambos formatos de API son totalmente compatibles con la integración de LLM personalizados.
Las siguientes guías abarcan ambos casos de uso:
- Usa tu propia clave de OpenAI: Usa tu propia clave de API de OpenAI con nuestra plataforma.
- Servidor LLM personalizado: Aloja y conecta tu propia implementación de servidor LLM.
Aprenderás a:
- Guardar tu clave de API de OpenAI en ElevenLabs
- Alojar un servidor que replique la ruta de API Chat Completions o Responses de OpenAI
- Dirigir ElevenLabs a tu ruta de API personalizada
- Pasar parámetros adicionales a tu LLM según sea necesario
Resumen del razonamiento
Tu ruta de API debe devolver el razonamiento por separado de la respuesta final. ElevenLabs no genera razonamiento a partir de la respuesta final.
Para solicitar razonamiento a una ruta de API compatible, activa Resumen del razonamiento en los ajustes de LLM del agente o configura enable_reasoning_summary mediante la API.
Devolver razonamiento
Usa el formato que corresponda a tu ruta de API:
API de Chat Completions
API de Responses
Transmite el razonamiento en el campo reasoning o reasoning_content de cada delta de respuesta.
Para rutas de API compatibles con Gemini, ElevenLabs solicita pensamientos con
google.thinking_config.include_thoughts y lee el contenido marcado con
extra_content.google.thought.
Consulta Resumen del razonamiento para conocer el almacenamiento, la entrega y las limitaciones.
Usar tu propia clave de OpenAI
Para integrar una clave de OpenAI personalizada, actualiza los ajustes de tu agente en el panel de ElevenLabs para que apunten a tu servidor LLM personalizado y crea un secreto que contenga tu OPENAI_API_KEY:
En los ajustes de tu agente del panel de ElevenLabs, selecciona “Custom LLM” en el menú desplegable “LLM” de la derecha.
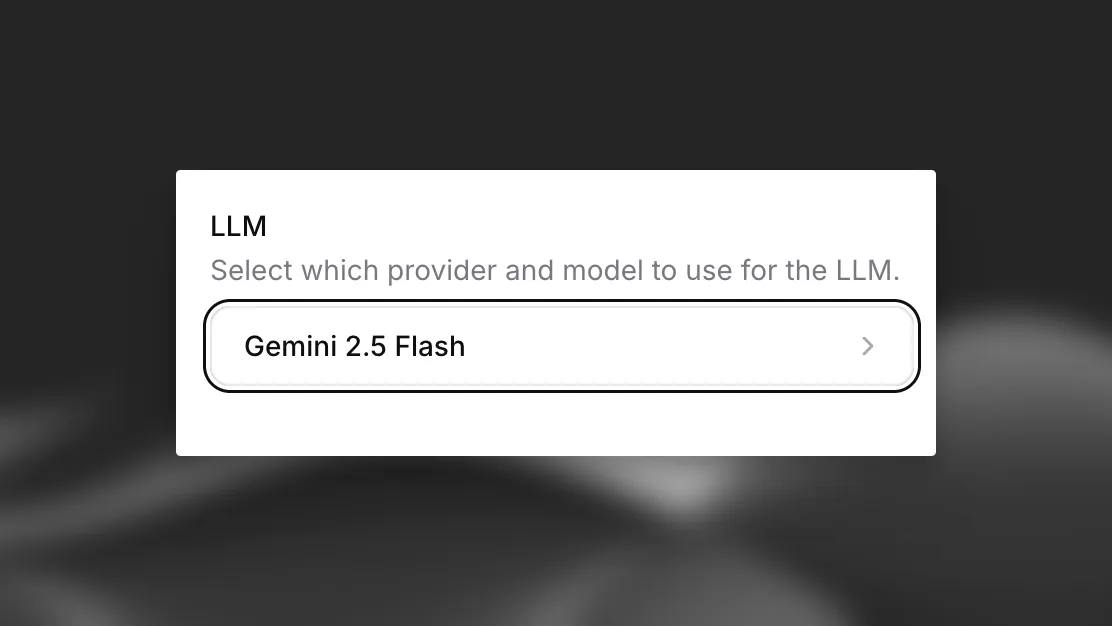
Haz clic en el campo situado debajo de “LLM” y desplázate hacia abajo para seleccionar “Custom LLM”.
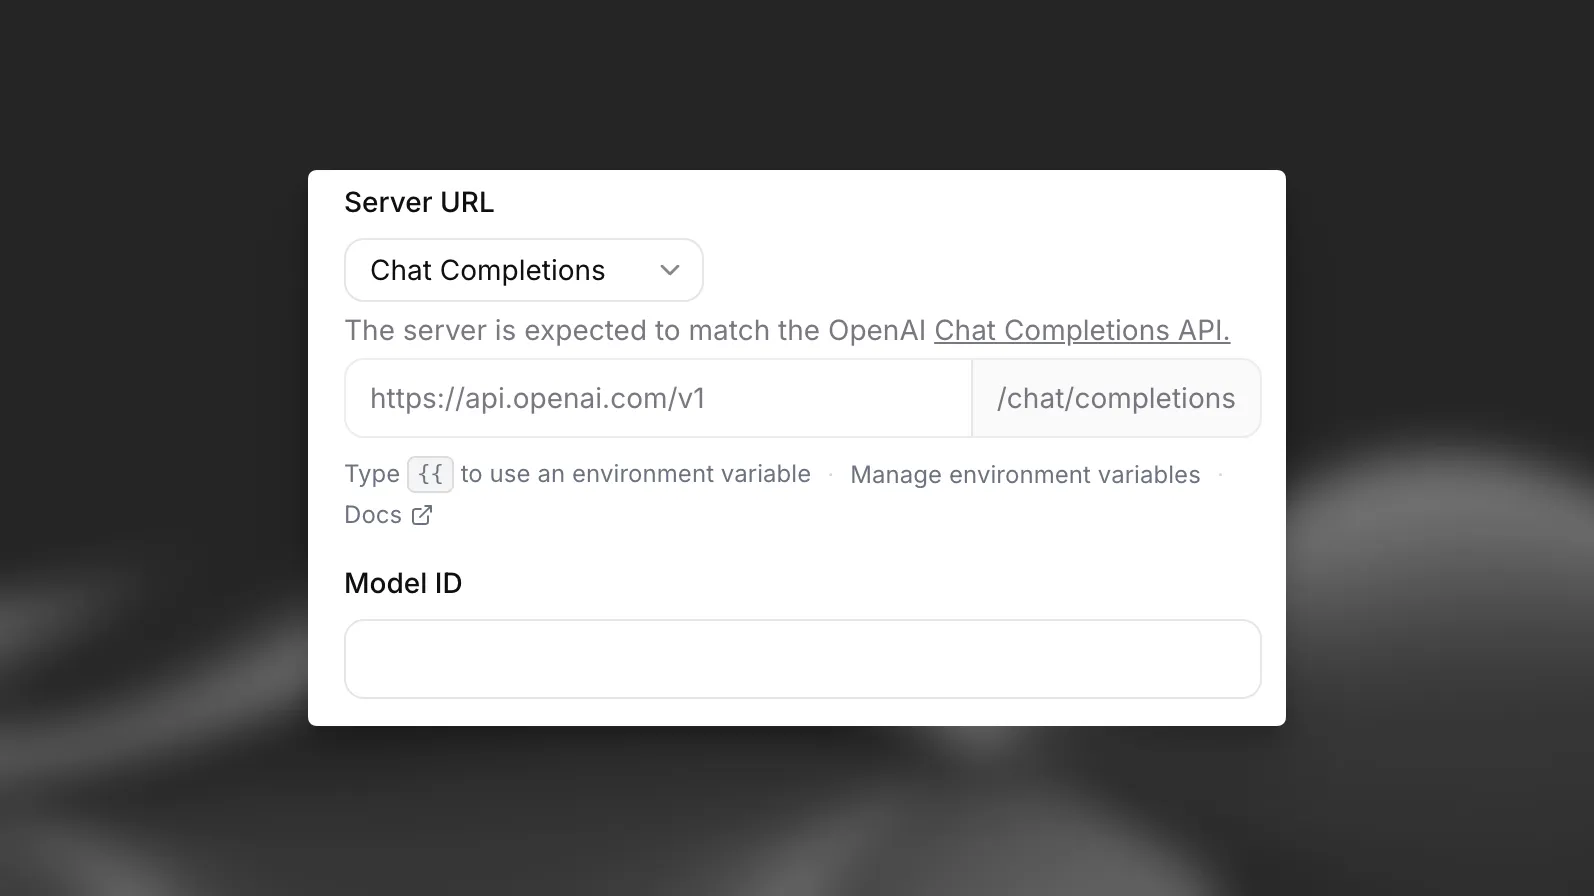
Servidor LLM personalizado
Para usar un servidor LLM personalizado, configura una ruta de API de servidor compatible con el estilo de OpenAI. Puedes implementar la API de Chat Completions (/v1/chat/completions) o la API de Responses (/v1/responses).
Ambas rutas de API deben devolver respuestas en formato SSE (eventos enviados por el servidor) con Content-Type: text/event-stream.
API de Chat Completions
API de Responses
La API de Chat Completions utiliza la ruta de API /v1/chat/completions.
Cada fragmento debe tener el formato data: {json}\n\n y la transmisión debe terminar con data: [DONE]\n\n.
Aquí tienes un ejemplo de implementación de servidor:
Ejecuta este código o el código de tu propio servidor.
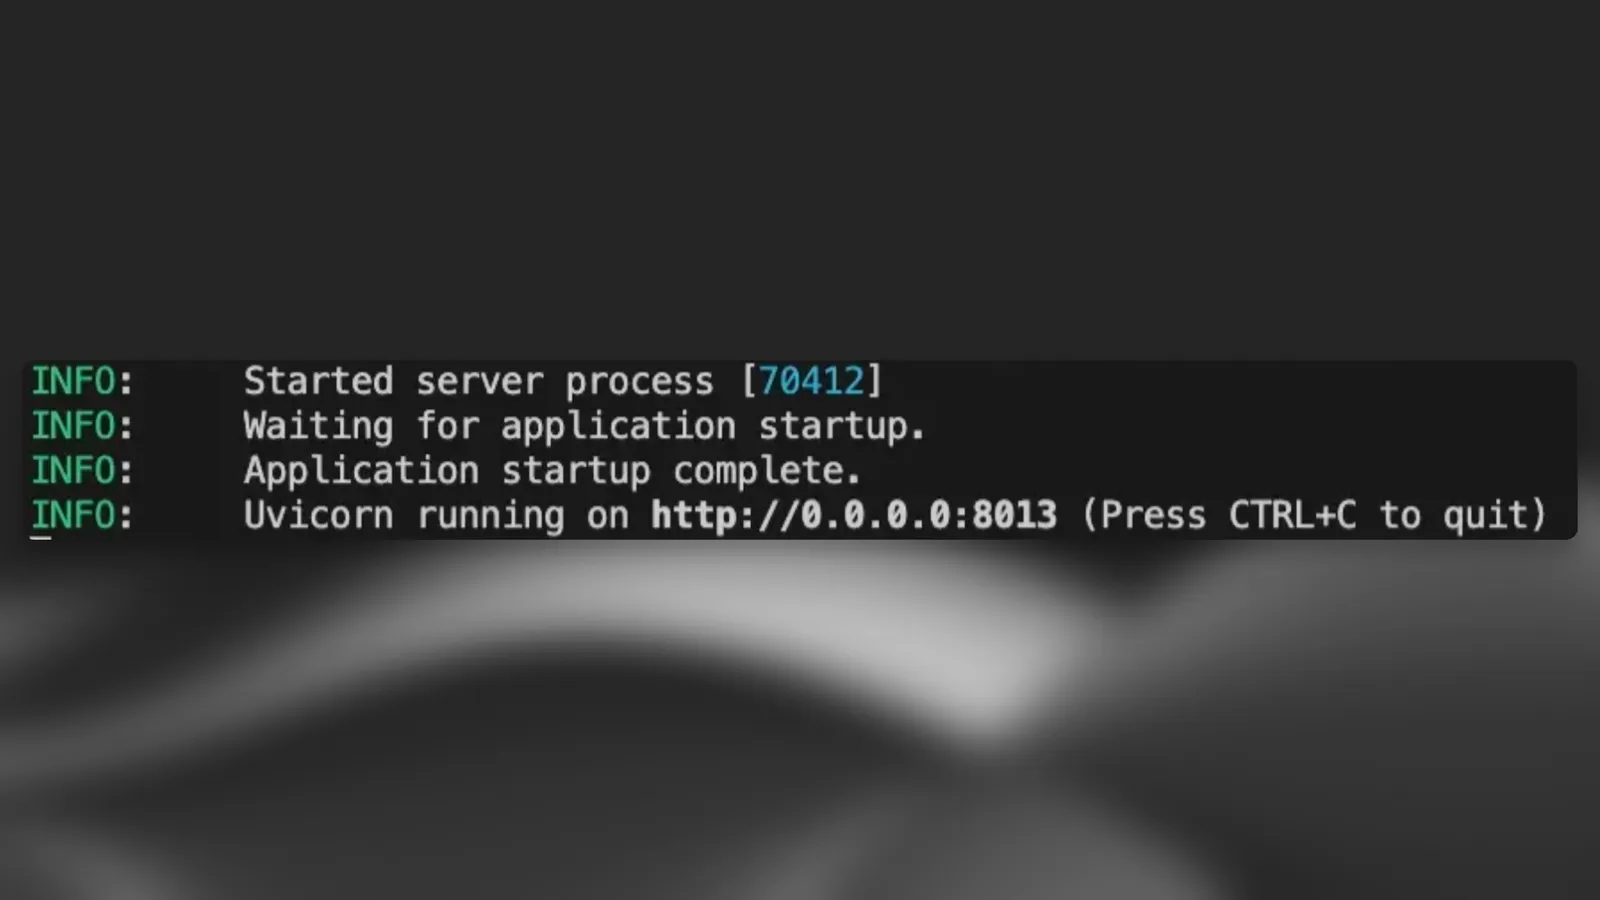
Configurar una URL pública para tu servidor
Para que tu servidor sea accesible, crea una URL pública con una herramienta de tunelización como ngrok:
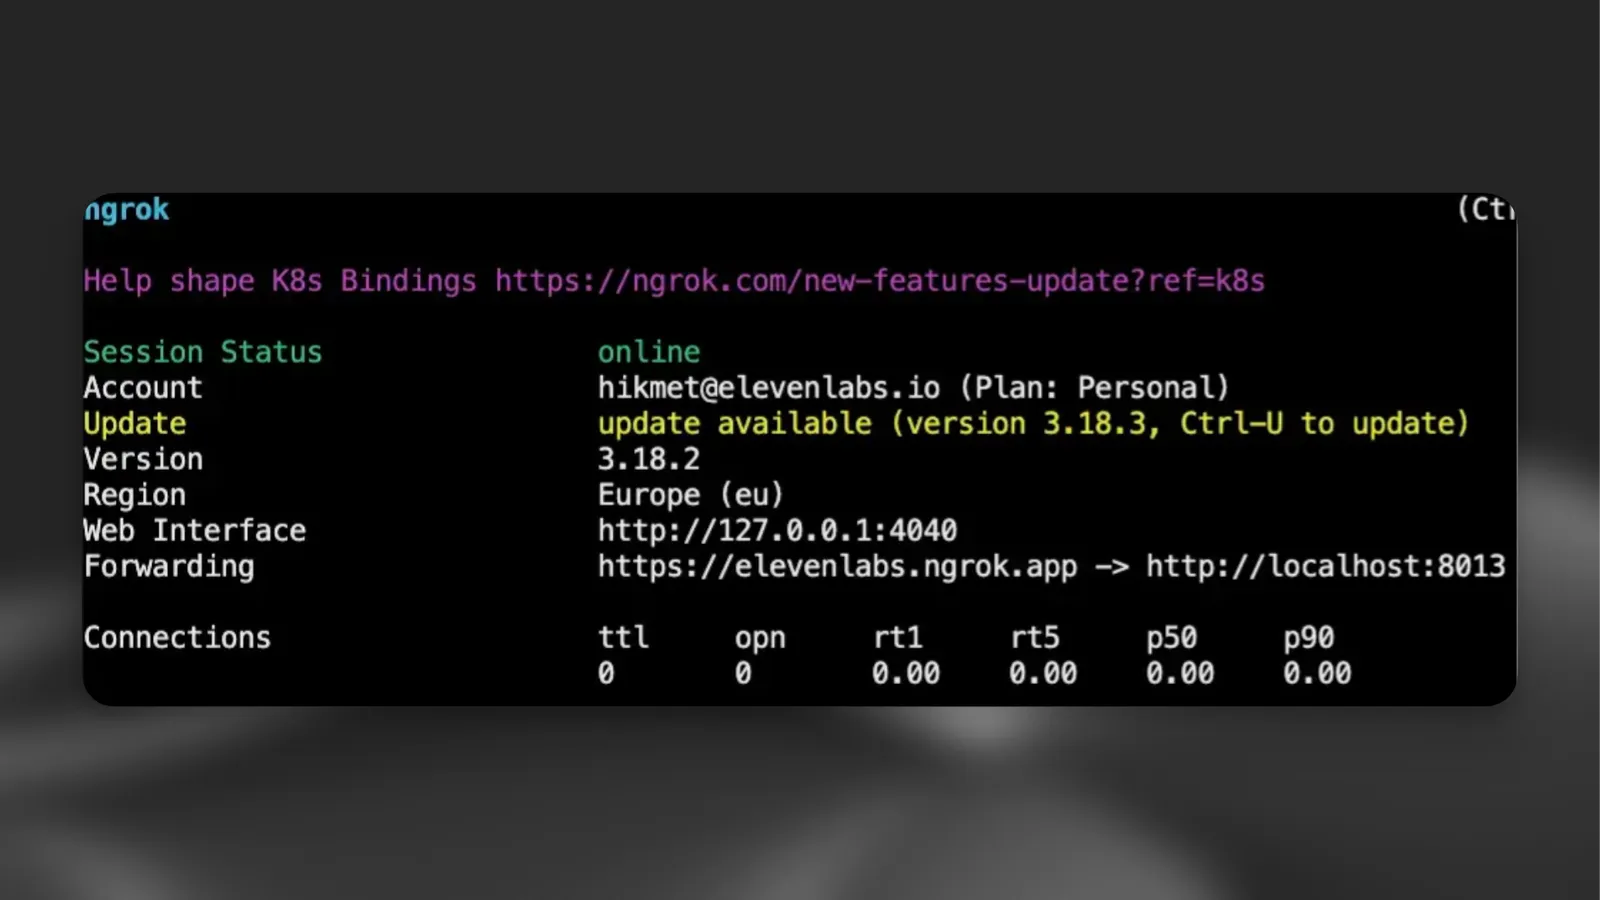
Configurar CustomLLM de ElevenLabs
A continuación, actualiza los ajustes de tu agente en el panel de ElevenLabs para que apunten a tu servidor LLM personalizado.
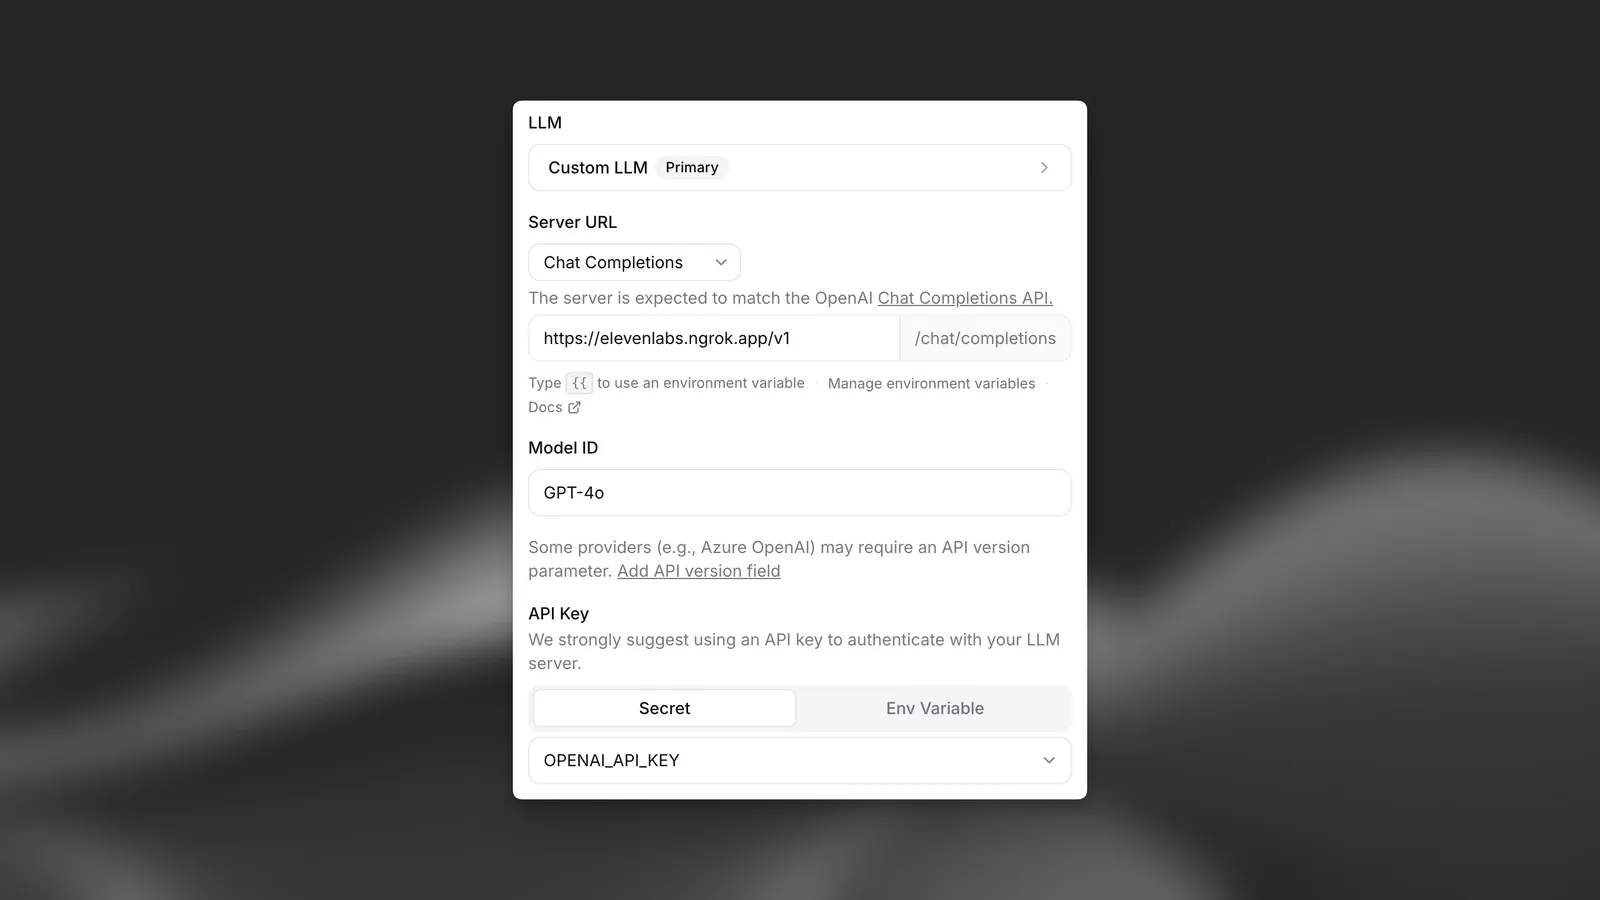
Dirige la URL de tu servidor a la ruta de API de ngrok y configura “Limit token usage” en 5000.
Ahora puedes empezar a interactuar con tu agente usando tu propio servidor LLM.
Optimizar para LLM con procesamiento lento
Si tu LLM personalizado tiene tiempos de procesamiento lentos (quizá debido al razonamiento agéntico o a requisitos de preprocesamiento), puedes mejorar el flujo de la conversación implementando palabras de relleno en tus respuestas transmitidas. Esta técnica ayuda a mantener una prosodia natural mientras tu LLM genera la respuesta completa.
Palabras de relleno
Cuando tu LLM necesite más tiempo para procesar la respuesta completa, devuelve una respuesta inicial que termine con "... " (puntos suspensivos seguidos de un espacio). Esto permite que el sistema de Texto a Voz mantenga un flujo natural y que la conversación siga siendo dinámica.
Así se crean pausas naturales que enlazan bien con el contenido posterior sobre el que el LLM puede razonar durante más tiempo. El espacio adicional es crucial para garantizar que el contenido posterior no se añada a ”…”, lo que puede provocar distorsiones de audio.
Implementación
A continuación te mostramos cómo modificar tu servidor LLM personalizado para implementar palabras de relleno:
Integración de herramientas del sistema
Tu LLM personalizado puede activar herramientas del sistema para controlar el flujo y el estado de la conversación. Estas herramientas se incluyen automáticamente en el parámetro tools de tus solicitudes de finalización de chat cuando están configuradas en tu agente.
Cómo funcionan las herramientas del sistema
- Decisión del LLM: Tu LLM personalizado decide cuándo llamar a estas herramientas según el contexto de la conversación
- Respuesta de la herramienta: El LLM responde con llamadas a funciones en formato estándar de OpenAI
- Procesamiento del backend: ElevenLabs procesa las llamadas a herramientas y actualiza el estado de la conversación
Para obtener más información sobre las herramientas del sistema, consulta nuestra guía
Herramientas del sistema disponibles
Finalizar llamada
Finalidad: Finalizar automáticamente las conversaciones cuando se cumplan las condiciones adecuadas.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- Se haya completado la tarea principal y el usuario esté satisfecho
- La conversación haya llegado a una conclusión natural con acuerdo mutuo
- El usuario indique explícitamente que quiere terminar la conversación
Parámetros:
reason(cadena, obligatorio): El motivo para finalizar la llamadamessage(cadena, opcional): Un mensaje de despedida que se envía al usuario antes de finalizar la llamada
Formato de llamada de función:
Implementación: Configúrala como una herramienta del sistema en los ajustes de tu agente. El LLM recibirá instrucciones detalladas sobre cuándo llamar a esta función.
Más información: Herramienta para finalizar llamada
Detección de idioma
Finalidad: Cambiar automáticamente al idioma detectado del usuario durante las conversaciones.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- El usuario hable en un idioma distinto al idioma actual de la conversación
- El usuario solicite explícitamente cambiar de idioma
- La conversación necesite compatibilidad con varios idiomas
Parámetros:
reason(cadena, obligatorio): El motivo del cambio de idiomalanguage(cadena, obligatorio): El código del idioma al que cambiar (debe estar en la lista de idiomas compatibles)
Formato de llamada de función:
Implementación: Configura los idiomas compatibles en los ajustes del agente y añade la herramienta del sistema de detección de idioma. El agente cambiará automáticamente la voz y las respuestas para adaptarse a los idiomas detectados.
Más información: Herramienta de detección de idioma
Transferencia de agente
Finalidad: Transferir conversaciones entre agentes de IA especializados según las necesidades del usuario.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- La solicitud del usuario requiera conocimientos especializados u otras capacidades del agente
- El agente actual no pueda gestionar adecuadamente la consulta
- El flujo de la conversación indique que se necesita otro tipo de agente
Parámetros:
reason(cadena, opcional): El motivo de la transferencia de agenteagent_number(entero, obligatorio): Número con índice desde cero del agente al que se transfiere (según las reglas de transferencia configuradas)
Formato de llamada de función:
Implementación: Define reglas de transferencia que asignen condiciones a ID de agente específicos. Configura a qué agentes puede transferir el agente actual. Los agentes se identifican mediante números con índice desde cero en la configuración de transferencia.
Más información: Herramienta de transferencia de agente
Transferir a una persona
Finalidad: Derivar conversaciones sin interrupciones a operadores humanos cuando la asistencia de IA no sea suficiente.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- Haya problemas complejos que requieran criterio humano
- El usuario solicite explícitamente asistencia humana
- La IA alcance los límites de su capacidad para la solicitud específica
- Se activen protocolos de escalado
Parámetros:
reason(cadena, opcional): El motivo de la transferenciatransfer_number(cadena, obligatorio): El número de teléfono al que transferir (debe coincidir con los números configurados)client_message(cadena, obligatorio): Mensaje que se lee al cliente mientras espera la transferenciaagent_message(cadena, obligatorio): Mensaje para el operador humano que recibe la llamada
Formato de llamada de función:
Implementación: Configura los números de teléfono y las condiciones de transferencia. Define mensajes tanto para el cliente como para el operador humano que recibe la llamada. Funciona con Twilio y con trunking SIP.
Más información: Herramienta para transferir a una persona
Omitir turno
Finalidad: Permitir que el agente haga una pausa y espere la intervención del usuario sin hablar.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- El usuario indique que necesita un momento (“Dame un segundo”, “Déjame pensar”)
- El usuario solicite pausar el flujo de la conversación
- El agente detecte que el usuario necesita tiempo para procesar la información
Parámetros:
reason(cadena, opcional): Motivo libre que explica por qué se necesita la pausa
Formato de llamada de función:
Implementación: No se necesita configuración adicional. La herramienta simplemente indica al agente que permanezca en silencio hasta que el usuario vuelva a hablar.
Más información: Herramienta para omitir turno
Detección de buzón de voz
Parámetros:
reason(cadena, obligatorio): El motivo para detectar el buzón de voz (por ejemplo, «se ha detectado un saludo automatizado», «no hay respuesta humana»)
Formato de llamada de función:
Más información: Herramienta de detección de buzón de voz
Ejemplo de solicitud con herramientas del sistema
Cuando se configuren herramientas del sistema, tu LLM personalizado recibirá solicitudes que incluyan las herramientas en el formato estándar de OpenAI:
Tu LLM personalizado debe admitir llamadas a funciones para usar herramientas del sistema. Asegúrate de que tu modelo pueda generar respuestas de llamada a función adecuadas en formato de OpenAI.
Funciones adicionales
Parámetros de LLM personalizado
Puedes pasar parámetros adicionales a tu implementación de LLM personalizado.
Python
Ejemplo de solicitud
Con esta configuración de mensajes personalizados, tu LLM recibirá solicitudes con este formato: