

Voice Design
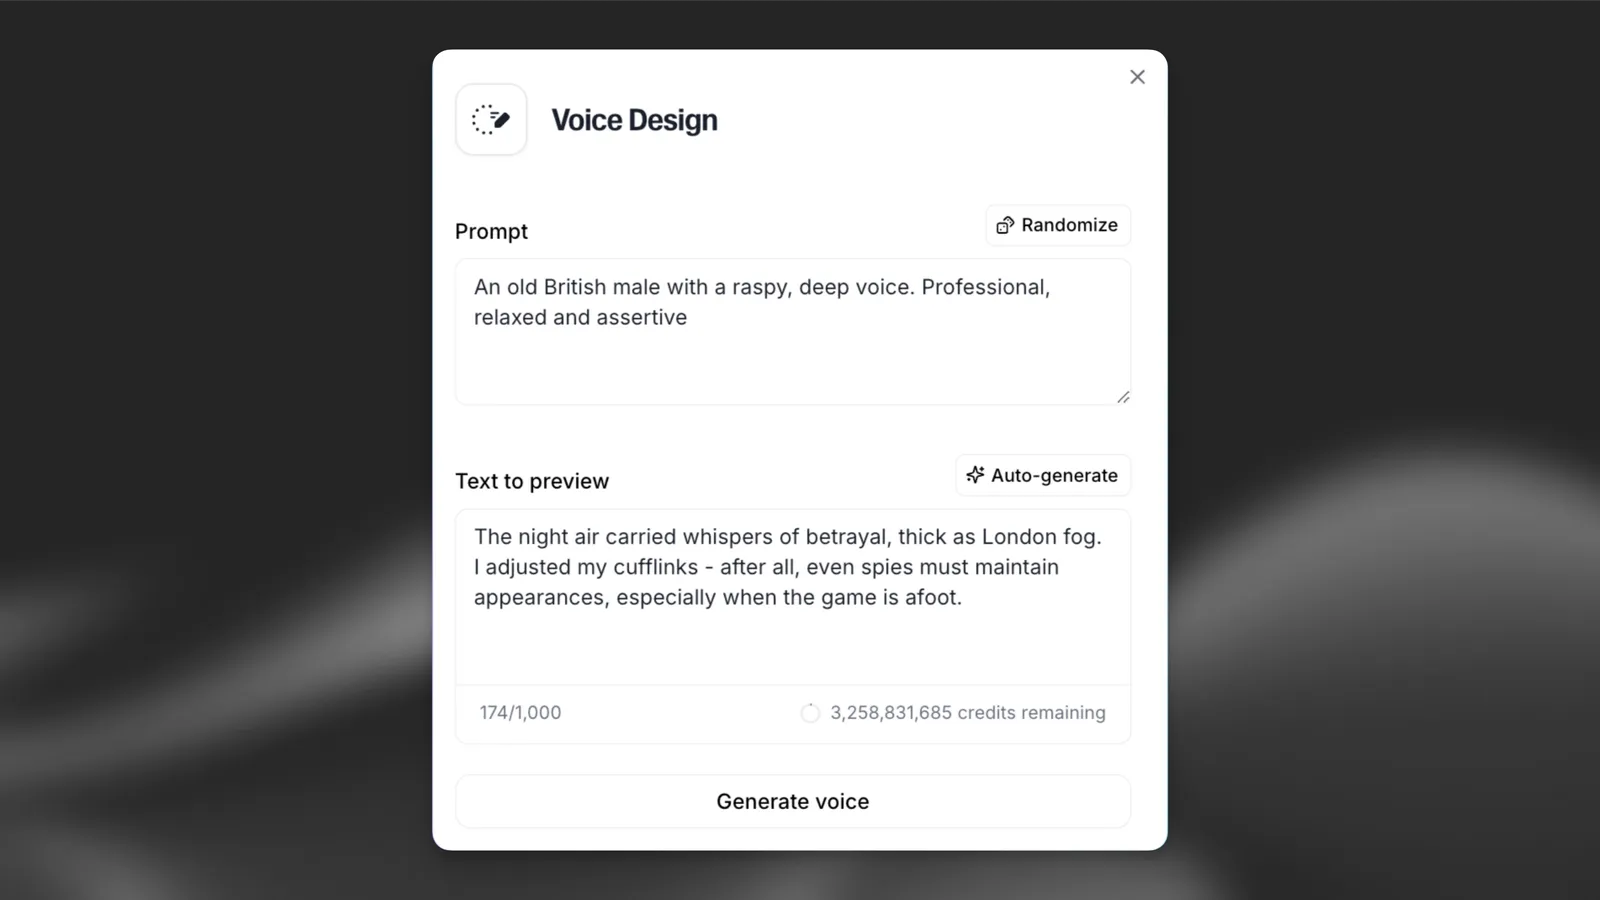
Overzicht
Voice Design helpt creators de gaten op te vullen wanneer de exacte stem die ze zoeken niet beschikbaar is in de Voice Library. Kun je geen geschikte stem voor je project vinden, dan kun je er zelf een maken. Voice Design is het meest geschikt voor snelle verkenning en iteratie, en de kwaliteit van de output kan variëren afhankelijk van je prompt en use case. Als je de meest consistente, productierijpe kwaliteit nodig hebt, zijn Professional Voice Clones (PVC) momenteel de stemmen van de hoogste kwaliteit op ons platform. Is er dus een PVC beschikbaar in onze bibliotheek die aan je behoeften voldoet, dan raden we aan die te gebruiken.
Je vindt Voice Design via Voices -> My Voices -> Add a new voice -> Voice Design in de ElevenLabs-app of via de API.
Wanneer je op genereren klikt, genereren we drie stemopties voor je. De enige kosten voor het gebruik van Voice Design zijn het aantal credits voor het genereren van je previewtekst. Die brengen we slechts één keer in rekening, ook al genereren we drie voorbeelden voor je. In het tekstvak “Text to preview” zie je hoeveel tekens worden afgetrokken.
Na het genereren kun je een van de gegenereerde stemmen selecteren en opslaan. Die neemt één van je stemslots in beslag.
Gids voor prompts
De prompt is de basis van je stem. Hiermee vertel je het model wat voor stem je wilt maken — van het accent en het type personage tot het geslacht en de sfeer van de stem. Een goed opgestelde prompt kan het verschil maken tussen een algemene stem en een stem die echt bij je visie past. Over het algemeen leveren meer beschrijvende en gedetailleerde prompts nauwkeurigere en genuanceerdere resultaten op. Hoe meer details je geeft — waaronder leeftijd, geslacht, toon, accent, tempo, emotie, stijl en meer — hoe beter het model een stem kan interpreteren en leveren die bewust ontworpen en op maat gemaakt voelt.
Soms kunnen korte en eenvoudige prompts echter ook werken, vooral als je een neutralere of breed inzetbare stem wilt. Zo kan “A calm male narrator” je precies geven wat je nodig hebt zonder in detail te treden — vooral als je geen heel specifiek personage of specifieke stijl wilt creëren. Het juiste detailniveau hangt af van je use case. Bouw je een fantasiepersonage? Een virtuele assistent? Een vermoeide New Yorker van in de zestig met een droog gevoel voor humor? Hoe duidelijker je dit in je prompt definieert, hoe dichter de output bij je voorstelling komt.
Aanbevolen promptindeling
Structureer je prompt voor consistente resultaten als volgt:
Voorbeeld:
Native Spanish, español europeo (sin rasgos de español latinoamericano). Female, 35–40. Ok quality. Persona: operadora de soporte confiable. Emotion: reassuring, attentive, confident. Smooth, natural timbre with gentle intonation, forward proximity, and a noise-free signal. Delivers updates at a relaxed pace with clear emphasis on helpful information, projecting empathy and professionalism.
Veelvoorkomende valkuilen om te vermijden
- Gebruik geen “accent” als je intonatie bedoelt — dit kan ongewenste verschuivingen in dialect veroorzaken. Beschrijf in plaats daarvan intonatie, nadruk of patronen in de voordracht.
- Vermijd woorden voor effecten — termen als “reverb”, “echo”, “phone” of “tape” kunnen de kwaliteit van de output negatief beïnvloeden.
- Wees expliciet over taal en dialect — specificeer altijd de taal en regionale variant in de eerste zin om afwijkingen te voorkomen.
Audiokwaliteit
Audiokwaliteit verwijst naar de helderheid, zuiverheid en algehele getrouwheid van de gegenereerde stem. Standaard streeft ElevenLabs ernaar schone, natuurlijk klinkende audio te produceren. Als je project een specifiek kwaliteitsniveau vereist, kun je dit het beste expliciet in je prompt opnemen.
Voor resultaten van hoge kwaliteit kun je het model helpen door een frase als “perfect audio quality” of “studio-quality recording” aan je stembeschrijving toe te voegen. Dit helpt ervoor te zorgen dat de stem wordt gerenderd met maximale helderheid, minimale vervorming en een verzorgde afwerking.
Je kunt ook specifieke kwaliteitsomschrijvingen gebruiken die consistente resultaten opleveren:
- Ok quality
- Good quality
- Very good quality
- Excellent quality
- Studio quality
- Broadcast quality
Deze omschrijvingen helpen de hoogst mogelijke audiokwaliteit te bereiken wanneer je ze in je prompt opneemt.
Het opnemen van dit soort frasen kan soms de nauwkeurigheid van de prompt in het algemeen verminderen als de stem heel specifiek of niche is.
Er kunnen ook creatieve situaties zijn waarin een lagere audiokwaliteit bewust gewenst is, bijvoorbeeld bij het simuleren van een telefoongesprek, een oude radio-uitzending of gevonden beeldmateriaal. Laat in die situaties kwaliteitsomschrijvingen helemaal weg, of gebruik expliciet frasen als:
- “Low-fidelity audio”
- “Poor audio quality”
- “Sounds like a voicemail”
- “Muffled and distant, like on an old tape recorder”
Waar je deze frase in je prompt plaatst, maakt niet uit — deze kan aan het begin of einde staan; volgens onze ervaring werkt beide goed.
Leeftijd, toon/timbre en geslacht
Deze drie kenmerken vormen de basis van stemontwerp en bepalen de algehele identiteit en emotionele uitstraling van de stem. Hoe meer details je geeft, hoe makkelijker het voor de AI is om een stem te produceren die bij je creatieve visie past — of je nu een geloofwaardig personage bouwt, een overtuigende verteller creëert of een virtuele assistent ontwerpt.
Leeftijd
Het beschrijven van de waargenomen leeftijd van de stem helpt bij het bepalen van de volwassenheid, vocale textuur en energie ervan. Gebruik specifieke termen om de AI naar de juiste stemkwaliteit te sturen.
Handige omschrijvingen:
- “Old man” / “old woman”
- “Young adult” / “in their 20s” / “early 30s”
- “Middle-aged man” / “woman in her 40s”
- “Elderly man” / “older woman” / “man in his 80s”
Toon/timbre
Verwijst naar de fysieke kwaliteit van de stem, gevormd door toonhoogte, resonantie en vocale textuur. Dit staat los van emotionele voordracht of houding.
Veelvoorkomende omschrijvingen voor toon/timbre:
- “Deep” / “low-pitched”
- “Smooth” / “rich”
- “Gravelly” / “raspy”
- “Nasally” / “shrill”
- “Airy” / “breathy”
- “Booming” / “resonant”
- “Light” / “thin”
- “Warm” / “mellow”
- “Tinny” / “metallic”
Geslacht
Geslacht beïnvloedt vaak de toonhoogte, het vocale gewicht en de tonale aanwezigheid, maar je kunt verder gaan dan eenvoudige categorieën door het geluid te beschrijven in plaats van de identiteit.
Voorbeelden:
- “A lower-pitched, husky female voice”
- “A masculine male voice, deep and resonant”
- “A neutral gender — soft and mid-pitched”
Accent
Accent speelt een cruciale rol bij het bepalen van de regionale, culturele en emotionele identiteit van een stem. Als je project afhankelijk is van een authentiek geluid — of het nu realistisch is of gestileerd voor een personage — is het essentieel om duidelijk en bewust te zijn over het gewenste accent.
De woordkeuze is belangrijk: bepaalde termen leveren doorgaans consistentere resultaten op. Zo geeft “thick” vaak betere resultaten dan “strong” wanneer je beschrijft hoe opvallend een accent moet zijn. Er is veel ruimte voor uitproberen, en we moedigen je aan om met de formulering te experimenteren en zo creatief en beschrijvend mogelijk te zijn.
Wees voorzichtig met het woord “accent” — als je intonatie- of nadrukpatronen bedoelt in plaats van een regionaal dialect, gebruik dan die termen. Als je “accent” gebruikt terwijl je intonatie bedoelt, kan dat ongewenste verschuivingen in dialect veroorzaken.
- Voorbeelden van duidelijke accentprompts:
- “A middle-aged man with a thick French accent”
- “A young woman with a slight Southern drawl”
- “An old man with a heavy Eastern European accent”
- “A cheerful woman speaking with a crisp British accent”
- “A younger male with a soft Irish lilt”
- “An authoritative voice with a neutral American accent”
- “A man with a regional Australian accent, laid-back and nasal”
Vermijd al te vage omschrijvingen zoals “foreign” of “exotic” — ze zijn onnauwkeurig en kunnen inconsistente resultaten opleveren.
Combineer accent met andere kenmerken zoals toon, leeftijd of tempo voor meer controle. Bijvoorbeeld: “A sarcastic old woman with a thick New York accent, speaking slowly.”
Voor fantasie- of fictieve stemmen kun je accenten uit de echte wereld als inspiratie gebruiken:
- “An elf with a proper thick British accent. He is regal and lyrical.”
- “A goblin with a raspy Eastern European accent.”
Tempo
Tempo verwijst naar de snelheid en het ritme waarmee een stem spreekt. Het is een belangrijk onderdeel bij het vormen van de persoonlijkheid, emotionele toon en helderheid van de stem. Het is essentieel om expliciet te zijn over het tempo, vooral bij het ontwerpen van stemmen voor specifieke use cases zoals verhalen vertellen, reclame, personagedialogen of instructieve content.
Gebruik duidelijke taal om te beschrijven hoe snel of langzaam de stem moet spreken. Je kunt ook beschrijven hoe het tempo aanvoelt — of het stabiel, onregelmatig, bedachtzaam of luchtig is. Als het tempo verandert, geef dan duidelijk aan waar en waarom.
Voorbeelden van tempo-omschrijvingen:
- “Speaking quickly” / “at a fast pace”
- “At a normal pace” / “speaking normally”
- “Speaking slowly” / “with a slow rhythm”
- “Deliberate and measured pacing”
- “Drawn out, as if savoring each word”
- “With a hurried cadence, like they’re in a rush”
- “Relaxed and conversational pacing”
- “Rhythmic and musical in pace”
- “Erratic pacing, with abrupt pauses and bursts”
- “Even pacing, with consistent timing between words”
- “Staccato delivery”
Tekst voor preview
Zodra je een sterke stemprompt hebt geschreven, speelt de tekst die je gebruikt om die stem te beluisteren een cruciale rol bij het bepalen van hoe deze daadwerkelijk klinkt. De previewtekst werkt als een performancescript — deze bepaalt de toon, het tempo en de emotionele voordracht die de stem probeert te volgen.
Voor de beste resultaten moet je previewtekst de stembeschrijving aanvullen, niet tegenspreken. Als je prompt bijvoorbeeld een “calm and reflective younger female voice with a slight Japanese accent” beschrijft, botst een zin als “Hey! I can’t stand what you’ve done with the darn place!!!” met die intentie. Het model probeert die tegenstrijdigheid op te lossen, wat vaak tot onnatuurlijke of inconsistente resultaten leidt.
Gebruik in plaats daarvan voorbeeldtekst die de beoogde persoonlijkheid en emotionele toon van de stem weerspiegelt. Voor het bovenstaande voorbeeld ondersteunt iets als “It’s been quiet lately… I’ve had time to think, and maybe that’s what I needed most.” de prompt en helpt het een natuurlijkere, samenhangende stem te genereren.
Daarnaast hebben we gemerkt dat langere previewteksten doorgaans stabielere en expressievere resultaten opleveren. Korte frasen kunnen soms abrupt of inconsistent klinken, vooral bij het testen van subtiele eigenschappen zoals toon of tempo. Door het model meer context te geven — een volledige zin of zelfs een korte alinea — kan het een vloeiendere en nauwkeurigere weergave van de stem leveren.
Parameters
Volume
Regelt het volume van de Text to Preview-generatie en uiteindelijk van de stem nadat deze is opgeslagen.
Guidance Scale
Bepaalt hoe nauwkeurig de prompt wordt gevolgd. Hogere waarden houden zich strikter aan de prompt, maar kunnen leiden tot een lagere audiokwaliteit als de prompt heel niche is. Lagere waarden geven het model meer ruimte voor creativiteit, ten koste van de nauwkeurigheid van de prompt. Gebruik een lagere waarde als de performance en audiokwaliteit over het algemeen belangrijker zijn dan dat de prompt perfect wordt gevolgd. Hoge waarden worden aanbevolen wanneer de nauwkeurigheid van accent of toon van het grootste belang is.
Kenmerken en voorbeelden
Experimenteer met de manier waarop je deze omschrijvingen formuleert. Zo kan “Perfect audio quality” ook worden geschreven als “the audio quality is perfect”. Soms leveren deze verschillende resultaten op!