

रिट्रीवल-ऑगमेंटेड जेनरेशन
RAG का इस्तेमाल करके अपने एजेंट को बड़े नॉलेज बेस से बेहतर बनाएं।
ओवरव्यू
रिट्रीवल-ऑगमेंटेड जेनरेशन (RAG) आपके एजेंट को बातचीत के दौरान बड़े नॉलेज बेस का ऐक्सेस लेने और उनका इस्तेमाल करने देता है। पूरे दस्तावेज़ों को कॉन्टेक्स्ट विंडो में लोड करने के बजाय, RAG हर यूज़र क्वेरी के लिए सिर्फ़ सबसे प्रासंगिक जानकारी ढूंढता है, जिससे आपका एजेंट:
- प्रॉम्प्ट में समा सकने वाले आकार से कहीं बड़े नॉलेज बेस का ऐक्सेस ले सकता है
- ज़्यादा सटीक, जानकारी पर आधारित जवाब दे सकता है
- स्रोत सामग्री का संदर्भ देकर हैलुसिनेशन कम कर सकता है
- कई विशेष एजेंट बनाए बिना जानकारी को स्केल कर सकता है
RAG उन एजेंट्स के लिए आदर्श है जिन्हें बड़े दस्तावेज़ों, तकनीकी मैनुअल या विस्तृत नॉलेज बेस का संदर्भ लेना होता है, जो पारंपरिक प्रॉम्प्टिंग की कॉन्टेक्स्ट विंडो सीमाओं से अधिक हों। RAG आपके एजेंट के जवाब के समय में लगभग 250ms की थोड़ी देरी जोड़ता है।
यह वीडियो डैशबोर्ड के पुराने वर्शन के साथ रिकॉर्ड किया गया था। RAG कॉन्फ़िगरेशन के चरण नहीं बदले हैं, लेकिन कुछ इंटरफ़ेस एलिमेंट्स अलग दिख सकते हैं।
RAG कैसे काम करता है
RAG सक्षम होने पर, आपका एजेंट इन चरणों के ज़रिए यूज़र क्वेरी प्रोसेस करता है:
- क्वेरी प्रोसेसिंग: यूज़र के सवाल का विश्लेषण किया जाता है और बेहतर रिट्रीवल के लिए उसे दोबारा तैयार किया जाता है।
- एम्बेडिंग जनरेशन: प्रोसेस की गई क्वेरी को वेक्टर एम्बेडिंग में बदला जाता है, जो यूज़र के सवाल को दर्शाती है।
- रिट्रीवल: सिस्टम आपके नॉलेज बेस से अर्थ की दृष्टि से सबसे मिलती-जुलती सामग्री ढूंढता है।
- जवाब जनरेशन: एजेंट बातचीत के कॉन्टेक्स्ट और रिट्रीव की गई जानकारी, दोनों का इस्तेमाल करके जवाब तैयार करता है।
यह प्रक्रिया सुनिश्चित करती है कि यूज़र की क्वेरी से जुड़ी प्रासंगिक जानकारी तथ्यात्मक रूप से सही जवाब बनाने के लिए LLM को भेजी जाए।
गाइड
ज़रूरी शर्तें
- एक ElevenLabs अकाउंट
- कॉन्फ़िगर किया गया ElevenLabs कन्वर्सेशनल एजेंट
- आपके एजेंट के नॉलेज बेस में जोड़ा गया कम से कम एक दस्तावेज़
अपने एजेंट के लिए RAG सक्षम करें
डैशबोर्ड से अपडेट करें
CLI से अपडेट करें
API से अपडेट करें
अपने एजेंट की सेटिंग्स में Knowledge Base खोलें और Retrieval टैब चुनें। Retrieval mode में, हर टर्न पर नॉलेज बेस खोजने के लिए Every turn चुनें, या एजेंट को सिर्फ़ ज़रूरत पड़ने पर खोजने देने के लिए On demand चुनें। Prompt only रिट्रीवल बंद कर देता है।
Semantic search में एम्बेडिंग मॉडल, वेक्टर डिस्टेंस लिमिट और कैंडिडेट्स की संख्या कॉन्फ़िगर करें, और Retrieval limits में कैरेक्टर व चंक लिमिट सेट करें।
नॉलेज बेस इंडेक्सिंग
RAG के साथ इस्तेमाल होने से पहले, आपके नॉलेज बेस के हर दस्तावेज़ को इंडेक्स करना ज़रूरी है। यह प्रक्रिया RAG सक्षम एजेंट में दस्तावेज़ जोड़े जाने पर अपने-आप होती है।
बड़े दस्तावेज़ों के लिए इंडेक्सिंग में कुछ मिनट लग सकते हैं। आप नॉलेज बेस सूची में इंडेक्सिंग स्टेटस देख सकते हैं।
दस्तावेज़ इस्तेमाल मोड कॉन्फ़िगर करें (वैकल्पिक)
अपने नॉलेज बेस के हर दस्तावेज़ के लिए, आप चुन सकते हैं कि उसका इस्तेमाल कैसे हो:
- Auto (डिफ़ॉल्ट): दस्तावेज़ सिर्फ़ क्वेरी से प्रासंगिक होने पर रिट्रीव किया जाता है
- Prompt: प्रासंगिकता की परवाह किए बिना, दस्तावेज़ हमेशा सिस्टम प्रॉम्प्ट में शामिल किया जाता है
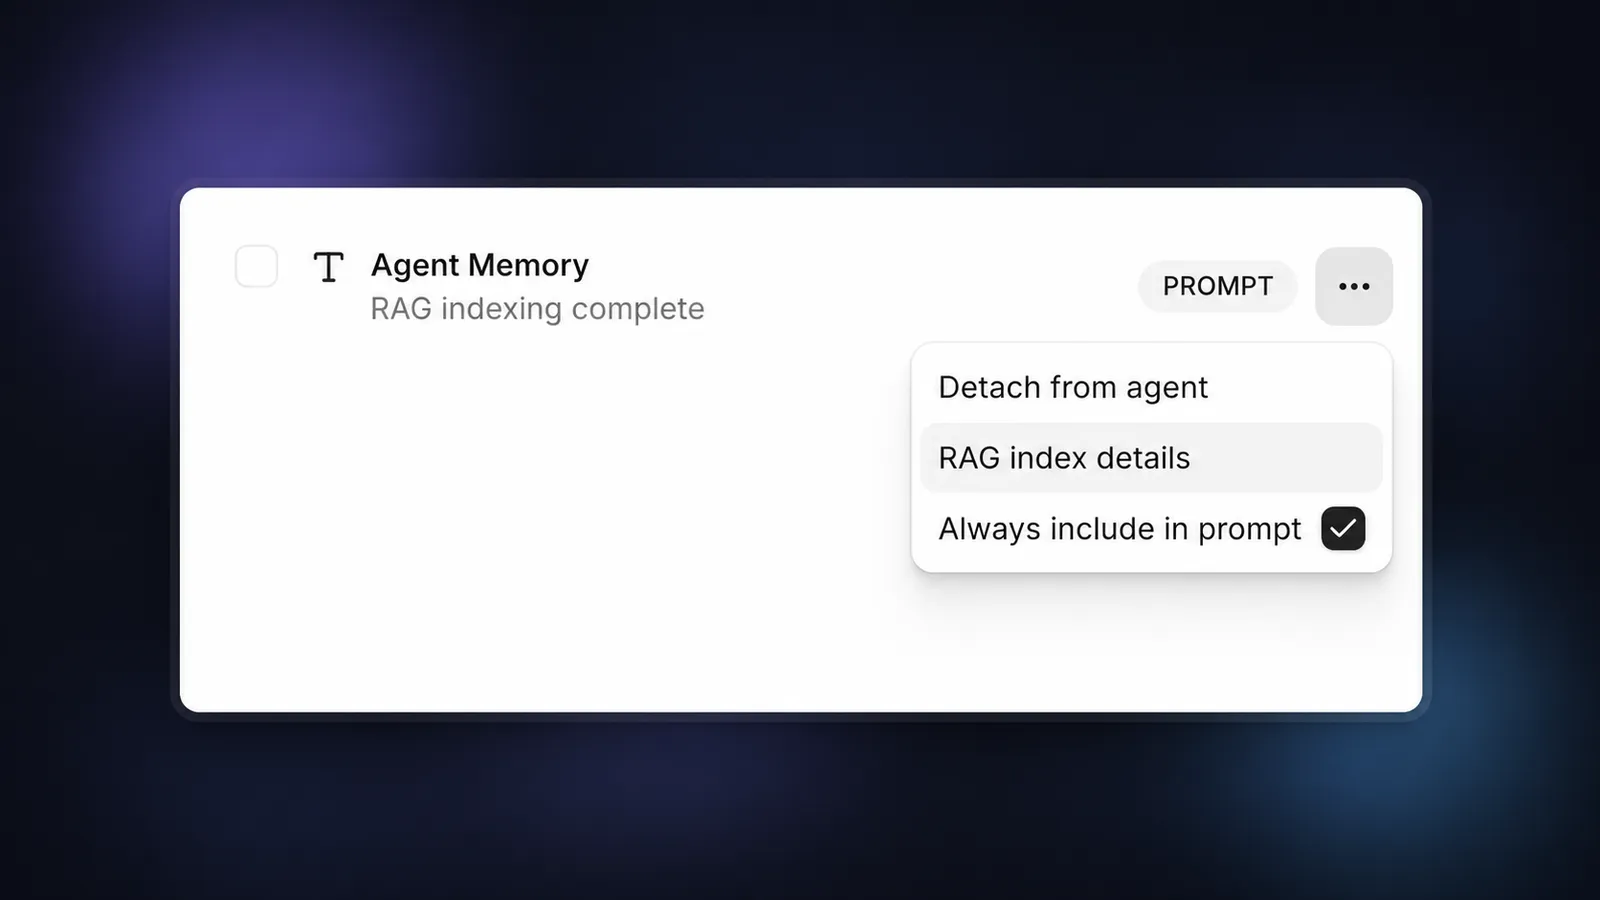
बहुत ज़्यादा दस्तावेज़ों को “Prompt” मोड पर सेट करने से कॉन्टेक्स्ट सीमाएं पार हो सकती हैं। इस विकल्प का इस्तेमाल महत्वपूर्ण जानकारी के लिए कम ही करें।
अपने RAG-सक्षम एजेंट को टेस्ट करें
अपना कॉन्फ़िगरेशन सेव करने के बाद, अपने नॉलेज बेस से जुड़े सवाल पूछकर एजेंट को टेस्ट करें। अब एजेंट आपके दस्तावेज़ों से खास जानकारी रिट्रीव कर सकेगा और उसका संदर्भ दे सकेगा।
इस्तेमाल की सीमाएं
संसाधनों का उचित आवंटन सुनिश्चित करने के लिए, ElevenLabs सब्सक्रिप्शन टियर के आधार पर हर वर्कस्पेस में RAG के लिए इंडेक्स किए जा सकने वाले दस्तावेज़ों के कुल आकार पर सीमाएं लागू करता है।
सीमाएं इस प्रकार हैं:
नोट:
- ये सीमाएं RAG के लिए इंडेक्स किए गए दस्तावेज़ों के कुल मूल फ़ाइल आकार पर लागू होती हैं, RAG इंडेक्स के आंतरिक स्टोरेज आकार पर नहीं (जो काफ़ी बड़ा हो सकता है)।
- 500 बाइट से छोटे दस्तावेज़ों को RAG के लिए इंडेक्स नहीं किया जा सकता और उनकी जगह अपने-आप प्रॉम्प्ट में इस्तेमाल किया जाएगा।
API इम्प्लीमेंटेशन
आप API के ज़रिए भी RAG इम्प्लीमेंट कर सकते हैं: