

Generación aumentada por recuperación
Descripción general
La generación aumentada por recuperación (RAG) permite a tu agente acceder a grandes bases de conocimiento y utilizarlas durante las conversaciones. En lugar de cargar documentos completos en la ventana de contexto, RAG recupera solo la información más relevante para cada consulta de usuario, lo que permite a tu agente:
- Acceder a bases de conocimiento mucho más grandes de lo que cabría en un prompt
- Ofrecer respuestas más precisas y fundamentadas en conocimientos
- Reducir las alucinaciones al consultar material de referencia
- Ampliar los conocimientos sin crear varios agentes especializados
RAG es ideal para agentes que necesitan consultar documentos extensos, manuales técnicos o grandes bases de conocimiento que superarían los límites de la ventana de contexto de los prompts tradicionales. RAG añade una ligera latencia al tiempo de respuesta de tu agente, de unos 250 ms.
Este vídeo se grabó con una versión anterior del panel. Los pasos de configuración de RAG no han cambiado, pero algunos elementos de la interfaz pueden tener un aspecto diferente.
Cómo funciona RAG
Cuando RAG está activado, tu agente procesa las consultas de usuario mediante estos pasos:
- Procesamiento de consultas: La pregunta del usuario se analiza y reformula para optimizar la recuperación.
- Generación de embeddings: La consulta procesada se convierte en un embedding vectorial que representa la pregunta del usuario.
- Recuperación: El sistema encuentra el contenido semánticamente más similar de tu base de conocimiento.
- Generación de respuestas: El agente genera una respuesta utilizando tanto el contexto de la conversación como la información recuperada.
Este proceso garantiza que la información relevante para la consulta del usuario se envíe al LLM para generar una respuesta factualmente correcta.
Guía
Requisitos previos
- Una cuenta de ElevenLabs
- Un agente conversacional de ElevenLabs configurado
- Al menos un documento añadido a la base de conocimiento de tu agente
Activa RAG para tu agente
Actualizar desde el panel
Actualizar mediante la CLI
Actualizar mediante la API
En los ajustes de tu agente, abre Base de conocimiento y selecciona la pestaña Recuperación. En Modo de recuperación, elige En cada turno para buscar en la base de conocimiento en cada turno, o Bajo demanda para que el agente busque solo cuando decida que lo necesita. Solo prompt desactiva la recuperación.
Configura el modelo de embeddings, el límite de distancia vectorial y el número de candidatos en Búsqueda semántica, y los límites de caracteres y fragmentos en Límites de recuperación.
Indexación de la base de conocimiento
Cada documento de tu base de conocimiento debe indexarse antes de poder utilizarse con RAG. Este proceso ocurre automáticamente cuando se añade un documento a un agente con RAG activado.
La indexación de documentos grandes puede tardar unos minutos. Puedes comprobar el estado de indexación en la lista de la base de conocimiento.
Configura los modos de uso de documentos (opcional)
Para cada documento de tu base de conocimiento, puedes elegir cómo se utiliza:
- Automático (predeterminado): El documento solo se recupera cuando es relevante para la consulta
- Prompt: El documento siempre se incluye en el prompt del sistema, independientemente de su relevancia
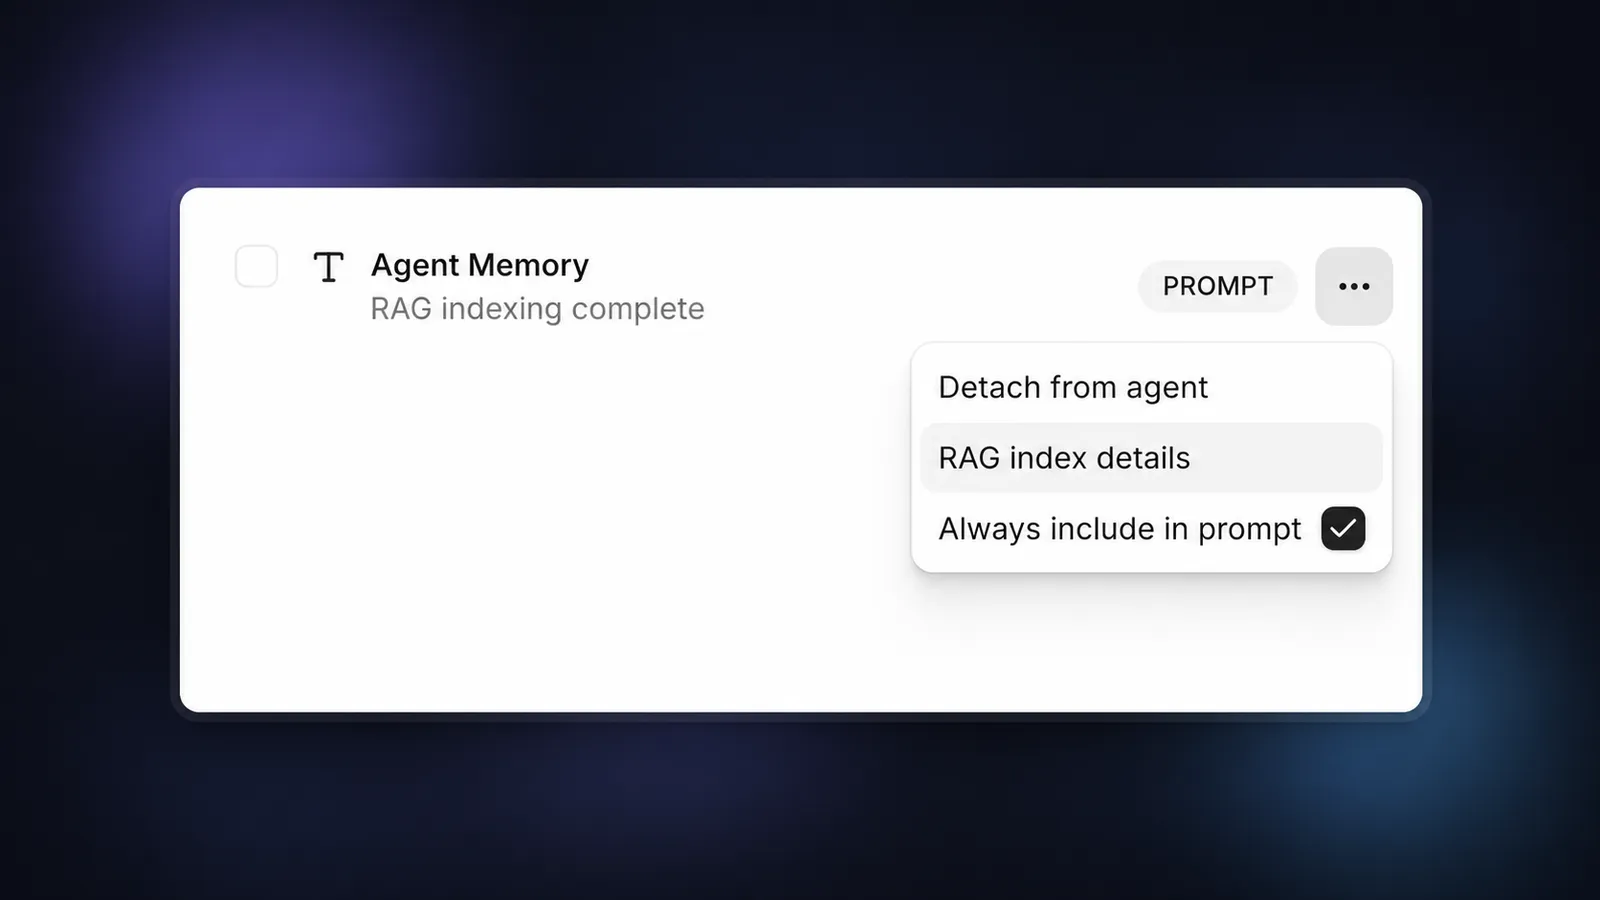
Configurar demasiados documentos en el modo “Prompt” puede superar los límites de contexto. Usa esta opción con moderación para información crítica.
Prueba tu agente con RAG activado
Después de guardar la configuración, prueba tu agente haciendo preguntas relacionadas con tu base de conocimiento. Ahora el agente debería poder recuperar y consultar información específica de tus documentos.
Límites de uso
Para garantizar una asignación justa de recursos, ElevenLabs aplica límites al tamaño total de los documentos que se pueden indexar para RAG por espacio de trabajo, según el nivel de suscripción.
Los límites son los siguientes:
Nota:
- Estos límites se aplican al tamaño original del archivo total de los documentos indexados para RAG, no al tamaño de almacenamiento interno del propio índice RAG (que puede ser considerablemente mayor).
- Los documentos de menos de 500 bytes no se pueden indexar para RAG y, en su lugar, se usarán automáticamente en el prompt.
Implementación de la API
También puedes implementar RAG mediante la API: