

Geração Aumentada por Recuperação
Visão geral
A Geração Aumentada por Recuperação (RAG) permite que seu agente acesse e use grandes bases de conhecimento durante as conversas. Em vez de carregar documentos inteiros na janela de contexto, o RAG recupera apenas as informações mais relevantes para cada consulta do usuário, permitindo que seu agente:
- Acesse bases de conhecimento muito maiores do que caberiam em um prompt
- Forneça respostas mais precisas e fundamentadas em conhecimento
- Reduza alucinações ao consultar o material de origem
- Amplie o conhecimento sem criar vários agentes especializados
O RAG é ideal para agentes que precisam consultar documentos extensos, manuais técnicos ou grandes bases de conhecimento que excederiam os limites da janela de contexto dos prompts tradicionais. O RAG adiciona uma pequena latência ao tempo de resposta do seu agente, de cerca de 250 ms.
Este vídeo foi gravado com uma versão anterior do painel. As etapas de configuração do RAG continuam as mesmas, mas alguns elementos da interface podem parecer diferentes.
Como o RAG funciona
Quando o RAG está ativado, seu agente processa as consultas dos usuários seguindo estas etapas:
- Processamento da consulta: a pergunta do usuário é analisada e reformulada para uma recuperação ideal.
- Geração de embeddings: a consulta processada é convertida em um embedding vetorial que representa a pergunta do usuário.
- Recuperação: o sistema encontra o conteúdo semanticamente mais semelhante na sua base de conhecimento.
- Geração de resposta: o agente gera uma resposta usando tanto o contexto da conversa quanto as informações recuperadas.
Esse processo garante que informações relevantes para a consulta do usuário sejam passadas ao LLM para gerar uma resposta factualmente correta.
Guia
Pré-requisitos
- Uma conta da ElevenLabs
- Um agente conversacional da ElevenLabs configurado
- Pelo menos um documento adicionado à base de conhecimento do seu agente
Ative o RAG para seu agente
Atualizar pelo painel
Atualizar pela CLI
Atualizar pela API
Nas configurações do seu agente, abra Base de conhecimento e selecione a aba Recuperação. Em Modo de recuperação, escolha A cada turno para pesquisar a base de conhecimento em todos os turnos, ou Sob demanda para que o agente pesquise somente quando decidir que precisa. Somente prompt desativa a recuperação.
Configure o modelo de embedding, o limite de distância vetorial e o número de candidatos em Pesquisa semântica, além dos limites de caracteres e blocos em Limites de recuperação.
Indexação da base de conhecimento
Cada documento na sua base de conhecimento precisa ser indexado antes de poder ser usado com RAG. Esse processo acontece automaticamente quando um documento é adicionado a um agente com RAG ativado.
A indexação pode levar alguns minutos para documentos grandes. Você pode verificar o status da indexação na lista da base de conhecimento.
Configure os modos de uso de documentos (opcional)
Para cada documento na sua base de conhecimento, você pode escolher como ele será usado:
- Automático (padrão): o documento só é recuperado quando é relevante para a consulta
- Prompt: o documento é sempre incluído no prompt do sistema, independentemente da relevância
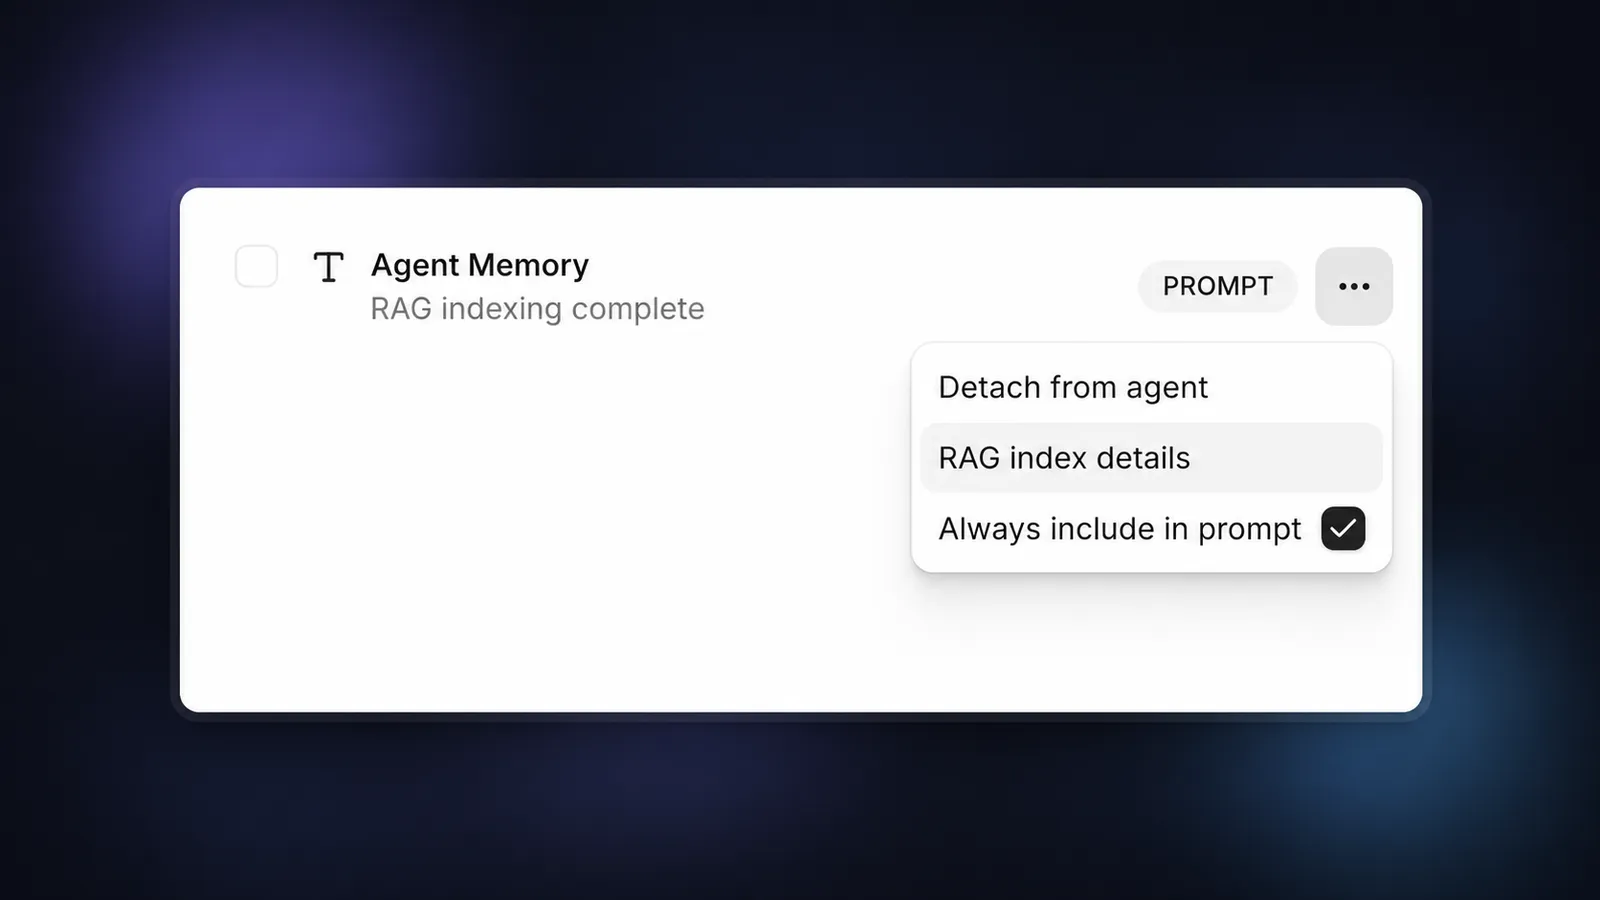
Definir muitos documentos como modo “Prompt” pode exceder os limites de contexto. Use esta opção com moderação para informações essenciais.
Teste seu agente com RAG ativado
Depois de salvar sua configuração, teste seu agente fazendo perguntas relacionadas à sua base de conhecimento. Agora, o agente deve conseguir recuperar e consultar informações específicas dos seus documentos.
Limites de uso
Para garantir uma alocação justa de recursos, a ElevenLabs aplica limites ao tamanho total de documentos que podem ser indexados para RAG por espaço de trabalho, com base no nível de assinatura.
Os limites são os seguintes:
Observação:
- Esses limites se aplicam ao tamanho original do arquivo dos documentos indexados para RAG, não ao tamanho do armazenamento interno do próprio índice RAG (que pode ser significativamente maior).
- Documentos menores que 500 bytes não podem ser indexados para RAG e serão usados automaticamente no prompt.
Implementação da API
Você também pode implementar RAG pela API: