

Retrieval-Augmented Generation
Erweitern Sie Ihren Agenten mit großen Wissensdatenbanken durch RAG.
Übersicht
Retrieval-Augmented Generation (RAG) ermöglicht Ihrem Agenten, während Gesprächen auf große Wissensdatenbanken zuzugreifen und sie zu nutzen. Statt ganze Dokumente in das Kontextfenster zu laden, ruft RAG für jede Nutzeranfrage nur die relevantesten Informationen ab. So kann Ihr Agent:
- Auf deutlich größere Wissensdatenbanken zugreifen, als in einen Prompt passen würden
- Genauere, wissensbasierte Antworten geben
- Halluzinationen reduzieren, indem er Quellmaterial berücksichtigt
- Wissen skalieren, ohne mehrere spezialisierte Agenten zu erstellen
RAG eignet sich ideal für Agenten, die auf große Dokumente, technische Handbücher oder umfangreiche Wissensdatenbanken zugreifen müssen, welche die Kontextfensterlimits herkömmlicher Prompts überschreiten würden. RAG erhöht die Antwortzeit Ihres Agenten geringfügig, um etwa 250 ms.
Dieses Video wurde mit einer früheren Version des Dashboards aufgenommen. Die Schritte zur RAG-Konfiguration sind unverändert, einige Oberflächenelemente können jedoch anders aussehen.
So funktioniert RAG
Wenn RAG aktiviert ist, verarbeitet Ihr Agent Nutzeranfragen in diesen Schritten:
- Anfrageverarbeitung: Die Frage des Nutzers wird analysiert und für einen optimalen Abruf umformuliert.
- Embedding-Generierung: Die verarbeitete Anfrage wird in ein Vektor-Embedding umgewandelt, das die Frage des Nutzers repräsentiert.
- Abruf: Das System findet die semantisch ähnlichsten Inhalte aus Ihrer Wissensdatenbank.
- Antwortgenerierung: Der Agent erstellt eine Antwort anhand des Gesprächskontexts und der abgerufenen Informationen.
Dieser Prozess stellt sicher, dass relevante Informationen zur Nutzeranfrage an das LLM übergeben werden, damit es eine faktisch korrekte Antwort erzeugen kann.
Anleitung
Voraussetzungen
- Ein ElevenLabs-Konto
- Ein konfigurierter ElevenLabs-Konversationsagent
- Mindestens ein Dokument in der Wissensdatenbank Ihres Agenten
RAG für Ihren Agenten aktivieren
Über das Dashboard aktualisieren
Über die CLI aktualisieren
Über die API aktualisieren
Öffnen Sie in den Einstellungen Ihres Agenten Knowledge Base und wählen Sie den Tab Retrieval. Wählen Sie unter Retrieval mode die Option Every turn, um die Wissensdatenbank bei jedem Zug abzufragen, oder On demand, damit der Agent nur sucht, wenn er es für nötig hält. Prompt only deaktiviert den Abruf.
Konfigurieren Sie unter Semantic search das Embedding-Modell, das Vektordistanzlimit und die Anzahl der Kandidaten sowie unter Retrieval limits die Zeichen- und Chunk-Limits.
Indexierung der Wissensdatenbank
Jedes Dokument in Ihrer Wissensdatenbank muss indexiert werden, bevor es mit RAG verwendet werden kann. Dieser Prozess erfolgt automatisch, wenn ein Dokument zu einem Agenten mit aktiviertem RAG hinzugefügt wird.
Die Indexierung großer Dokumente kann einige Minuten dauern. Sie können den Indexierungsstatus in der Liste der Wissensdatenbank prüfen.
Dokumentnutzungsmodi konfigurieren (optional)
Für jedes Dokument in Ihrer Wissensdatenbank können Sie festlegen, wie es verwendet wird:
- Auto (Standard): Das Dokument wird nur abgerufen, wenn es für die Anfrage relevant ist
- Prompt: Das Dokument wird unabhängig von seiner Relevanz immer in den System-Prompt aufgenommen
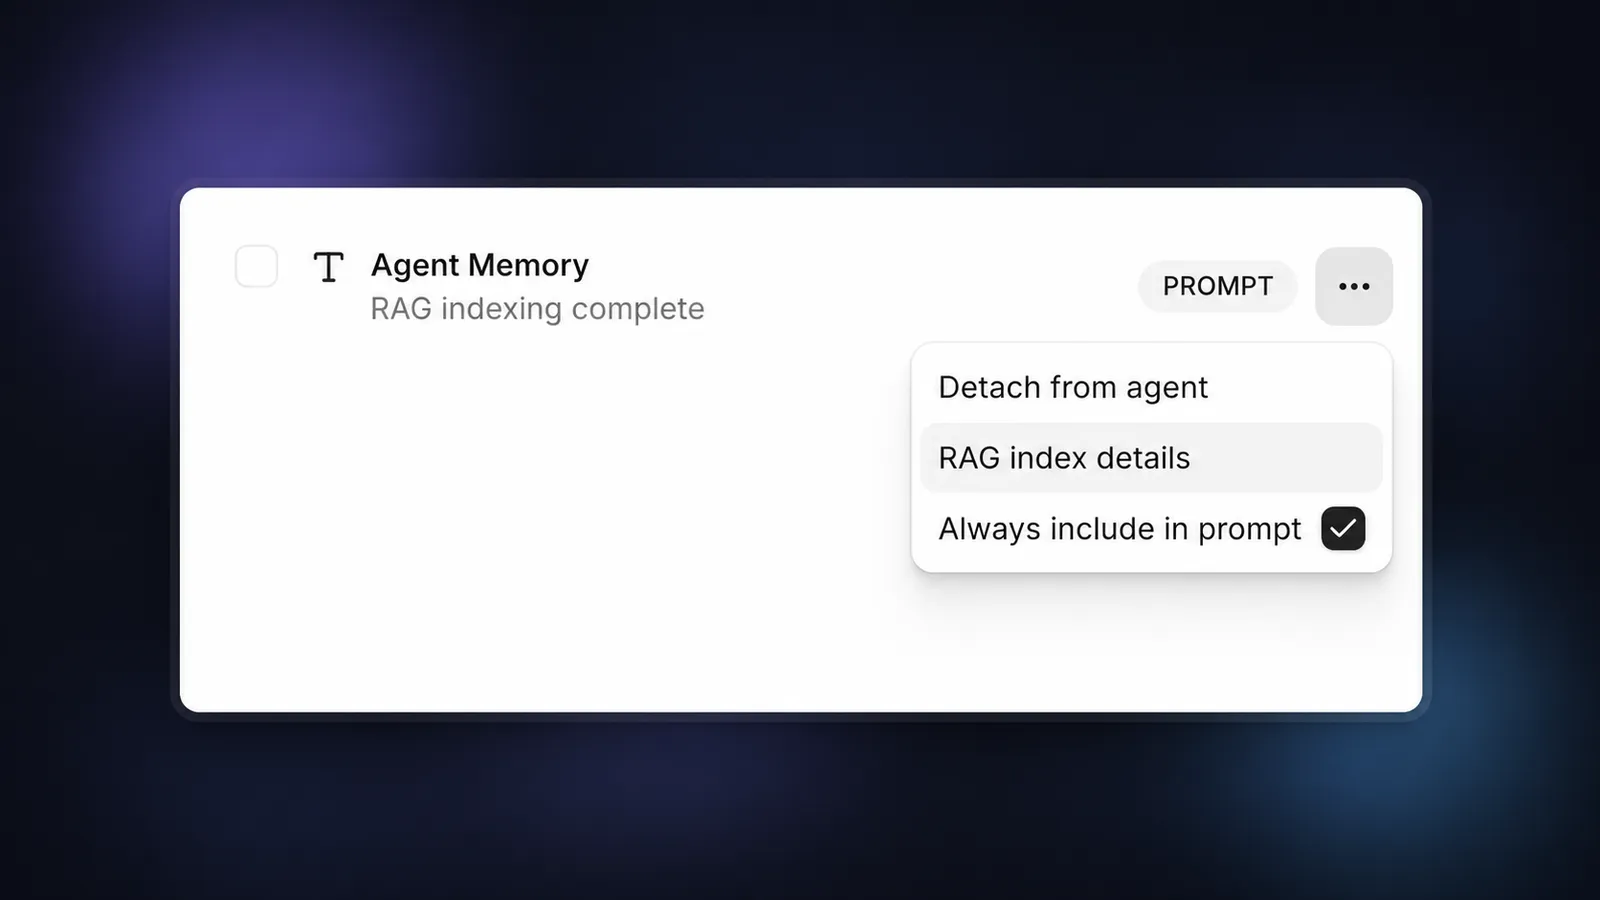
Wenn zu viele Dokumente auf den Modus „Prompt“ gesetzt werden, können die Kontextlimits überschritten werden. Nutzen Sie diese Option sparsam für wichtige Informationen.
Ihren RAG-fähigen Agenten testen
Testen Sie Ihren Agenten nach dem Speichern der Konfiguration, indem Sie Fragen zu Ihrer Wissensdatenbank stellen. Der Agent sollte jetzt spezifische Informationen aus Ihren Dokumenten abrufen und darauf verweisen können.
Nutzungslimits
Um Ressourcen fair zu verteilen, begrenzt ElevenLabs die Gesamtgröße der Dokumente, die pro Workspace für RAG indexiert werden können. Die Limits richten sich nach dem Abonnement.
Die Limits sind wie folgt:
Hinweis:
- Diese Limits gelten für die gesamte ursprüngliche Dateigröße der für RAG indexierten Dokumente, nicht für die interne Speichergröße des RAG-Index selbst, die deutlich größer sein kann.
- Dokumente mit weniger als 500 Byte können nicht für RAG indexiert werden und werden stattdessen automatisch im Prompt verwendet.
API-Implementierung
Sie können RAG auch über die API implementieren: