

検索拡張生成
RAGを使用して、大規模なナレッジベースでエージェントを強化します。
概要
検索拡張生成(RAG) を使用すると、会話中にエージェントが大規模なナレッジベースへアクセスして活用できます。ドキュメント全体をコンテキストウィンドウに読み込む代わりに、RAGはユーザーのクエリごとに最も関連性の高い情報だけを取得するため、エージェントは次のことが可能になります。
- プロンプトに収まらないほど大規模なナレッジベースにアクセス
- ナレッジに基づく、より正確な応答を提供
- ソース資料を参照してハルシネーションを削減
- 複数の専門エージェントを作成せずにナレッジを拡張
RAGは、大規模なドキュメント、技術マニュアル、または従来のプロンプトでは コンテキストウィンドウの制限を超える広範なナレッジベースを参照する必要があるエージェントに最適です。 RAGを使用すると、エージェントの応答時間に約250msのわずかな遅延が加わります。
この動画は以前のバージョンのダッシュボードで収録されています。RAGの設定手順は 変わっていませんが、一部のインターフェース要素は異なる場合があります。
RAGの仕組み
RAGを有効にすると、エージェントはユーザーのクエリを次の手順で処理します。
- クエリ処理:ユーザーの質問を分析し、最適な取得のために再構成します。
- 埋め込み生成:処理済みのクエリを、ユーザーの質問を表すベクトル埋め込みに変換します。
- 取得:ナレッジベースから意味的に最も類似したコンテンツを見つけます。
- 応答生成:会話のコンテキストと取得した情報の両方を使用して、エージェントが応答を生成します。
このプロセスにより、ユーザーのクエリに関連する情報がLLMに渡され、事実に基づいた正確な回答が生成されます。
ガイド
前提条件
- ElevenLabsアカウント
- 設定済みのElevenLabs 会話型エージェント
- エージェントのナレッジベースに追加されたドキュメントが少なくとも1つ
エージェントでRAGを有効にする
ダッシュボードで更新
CLIで更新
APIで更新
エージェントの設定で ナレッジベース を開き、取得 タブを選択します。取得モード で、ターンごとにナレッジベースを検索する場合は 毎ターン を選択し、エージェントが必要と判断した場合にのみ検索させる場合は オンデマンド を選択します。プロンプトのみ を選択すると、取得はオフになります。
セマンティック検索 で埋め込みモデル、ベクトル距離の上限、候補数を設定し、取得制限 で文字数とチャンク数の上限を設定します。
ナレッジベースのインデックス作成
ナレッジベース内の各ドキュメントは、RAGで使用する前にインデックスを作成する必要があります。この プロセスは、RAGを有効にしたエージェントにドキュメントを追加すると自動的に実行されます。
大規模なドキュメントでは、インデックス作成に数分かかる場合があります。インデックス作成のステータスは ナレッジベースのリストで確認できます。
ドキュメントの使用モードを設定(任意)
ナレッジベース内の各ドキュメントについて、使用方法を選択できます。
- 自動(デフォルト):クエリに関連する場合にのみドキュメントを取得します
- プロンプト:関連性にかかわらず、ドキュメントを常にシステムプロンプトに含めます
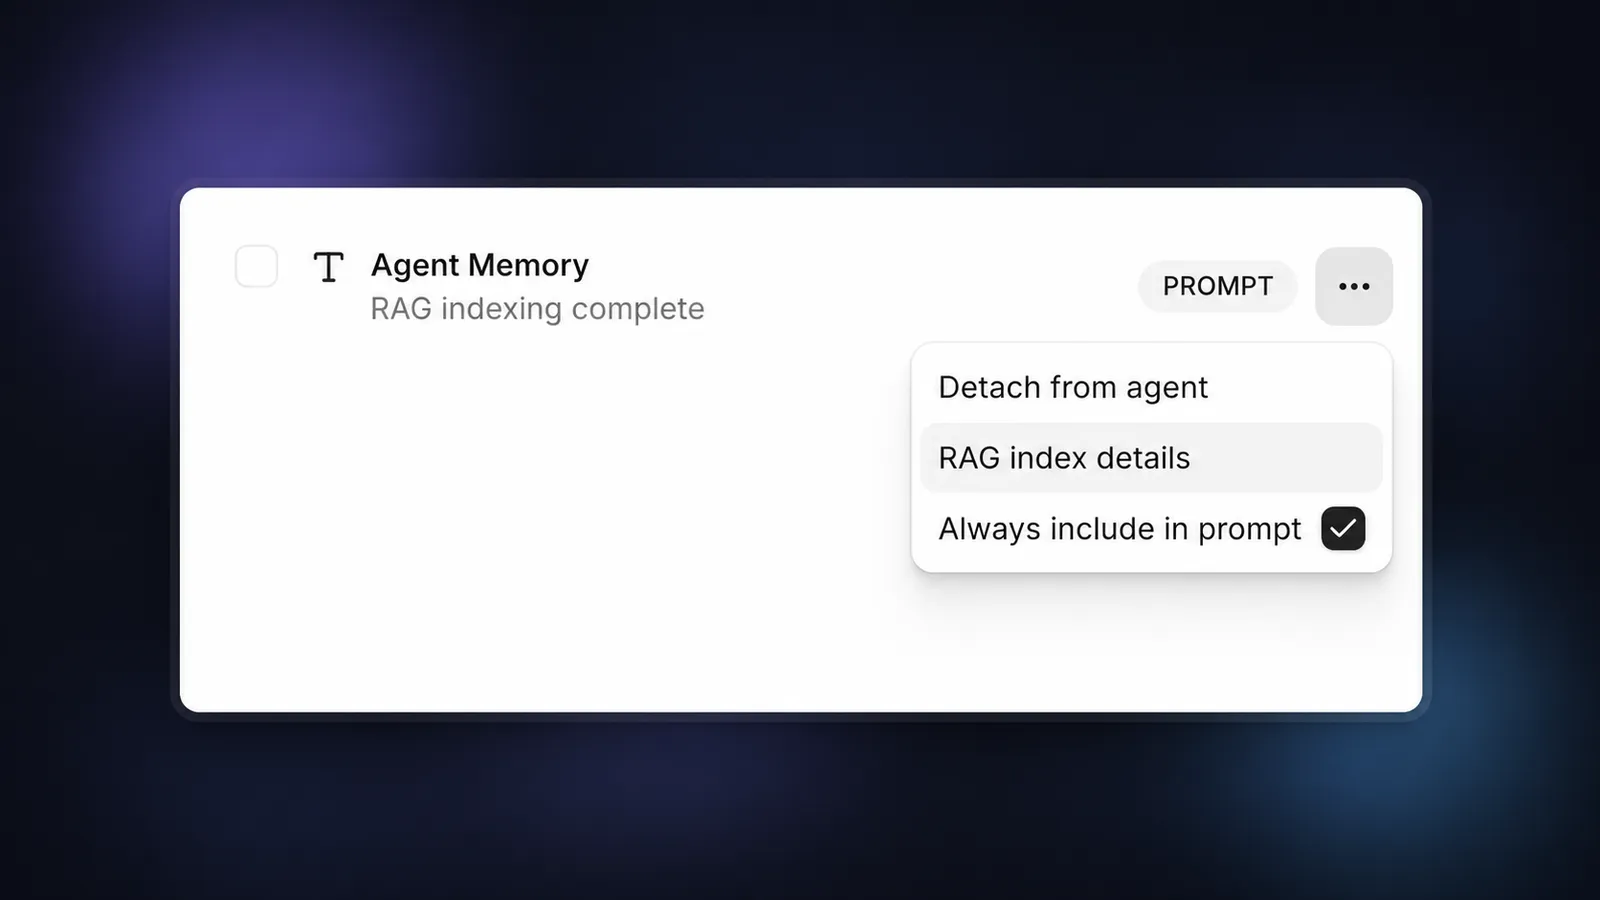
多くのドキュメントを「プロンプト」モードに設定すると、コンテキストの上限を超える可能性があります。 重要な情報に限って慎重に使用してください。
RAG対応エージェントをテストする
設定を保存したら、ナレッジベースに関連する質問をしてエージェントをテストします。これで、エージェントはドキュメントから特定の情報を取得して参照できるようになります。
使用上限
公平なリソース配分を確保するため、ElevenLabsはサブスクリプションのティアに応じて、ワークスペースごとにRAG用にインデックスを作成できるドキュメントの合計サイズに上限を設けています。
上限は次のとおりです。
注:
- これらの上限は、RAG用にインデックス化されるドキュメントの合計 元ファイルサイズ に適用されます。RAGインデックス自体の内部ストレージサイズ(大幅に大きくなる場合があります)には適用されません。
- 500バイト未満のドキュメントはRAG用にインデックス化できず、代わりに自動的にプロンプトで使用されます。
API実装
APIを通じてRAGを実装することもできます。