

Retrieval-Augmented Generation
Overzicht
Retrieval-Augmented Generation (RAG) geeft je agent tijdens gesprekken toegang tot grote kennisbanken en laat deze gebruiken. In plaats van volledige documenten in het contextvenster te laden, haalt RAG alleen de meest relevante informatie op voor elke gebruikersvraag. Hierdoor kan je agent:
- Veel grotere kennisbanken gebruiken dan in een prompt passen
- Nauwkeurigere, op kennis gebaseerde antwoorden geven
- Hallucinaties verminderen door bronmateriaal te raadplegen
- Kennis opschalen zonder meerdere gespecialiseerde agents te maken
RAG is ideaal voor agents die grote documenten, technische handleidingen of uitgebreide kennisbanken moeten raadplegen die de limieten van het contextvenster van traditionele prompting zouden overschrijden. RAG voegt een geringe vertraging toe aan de reactietijd van je agent, ongeveer 250 ms.
Deze video is opgenomen met een eerdere versie van het dashboard. De stappen voor RAG-configuratie zijn ongewijzigd, maar sommige interface-elementen kunnen er anders uitzien.
Zo werkt RAG
Wanneer RAG is ingeschakeld, verwerkt je agent gebruikersvragen via deze stappen:
- Queryverwerking: De vraag van de gebruiker wordt geanalyseerd en geherformuleerd voor optimale retrieval.
- Embeddings genereren: De verwerkte query wordt omgezet in een vector embedding die de vraag van de gebruiker vertegenwoordigt.
- Retrieval: Het systeem zoekt de semantisch meest vergelijkbare content in je kennisbank.
- Antwoord genereren: De agent genereert een antwoord met zowel de gesprekscontext als de opgehaalde informatie.
Dit proces zorgt ervoor dat informatie die relevant is voor de query van de gebruiker, wordt doorgegeven aan de LLM om een feitelijk correct antwoord te genereren.
Handleiding
Vereisten
- Een ElevenLabs-account
- Een geconfigureerde ElevenLabs-conversatieagent
- Minstens één document dat is toegevoegd aan de kennisbank van je agent
RAG inschakelen voor je agent
Bijwerken via het dashboard
Bijwerken via de CLI
Bijwerken via de API
Open in de instellingen van je agent Knowledge Base en selecteer het tabblad Retrieval. Kies onder Retrieval mode Every turn om de kennisbank bij elke beurt te doorzoeken, of On demand zodat de agent alleen zoekt wanneer deze besluit dat nodig te hebben. Met Prompt only schakel je retrieval uit.
Configureer onder Semantic search het embeddingmodel, de limiet voor vectorafstand en het aantal kandidaten, en onder Retrieval limits de limieten voor tekens en chunks.
Kennisbank indexeren
Elk document in je kennisbank moet worden geïndexeerd voordat je het met RAG kunt gebruiken. Dit gebeurt automatisch wanneer een document wordt toegevoegd aan een agent waarvoor RAG is ingeschakeld.
Het indexeren van grote documenten kan enkele minuten duren. Je kunt de indexeringsstatus in de kennisbanklijst controleren.
Gebruiksmodi voor documenten configureren (optioneel)
Voor elk document in je kennisbank kun je kiezen hoe het wordt gebruikt:
- Auto (standaard): Het document wordt alleen opgehaald wanneer het relevant is voor de query
- Prompt: Het document wordt altijd opgenomen in de systeemprompt, ongeacht de relevantie
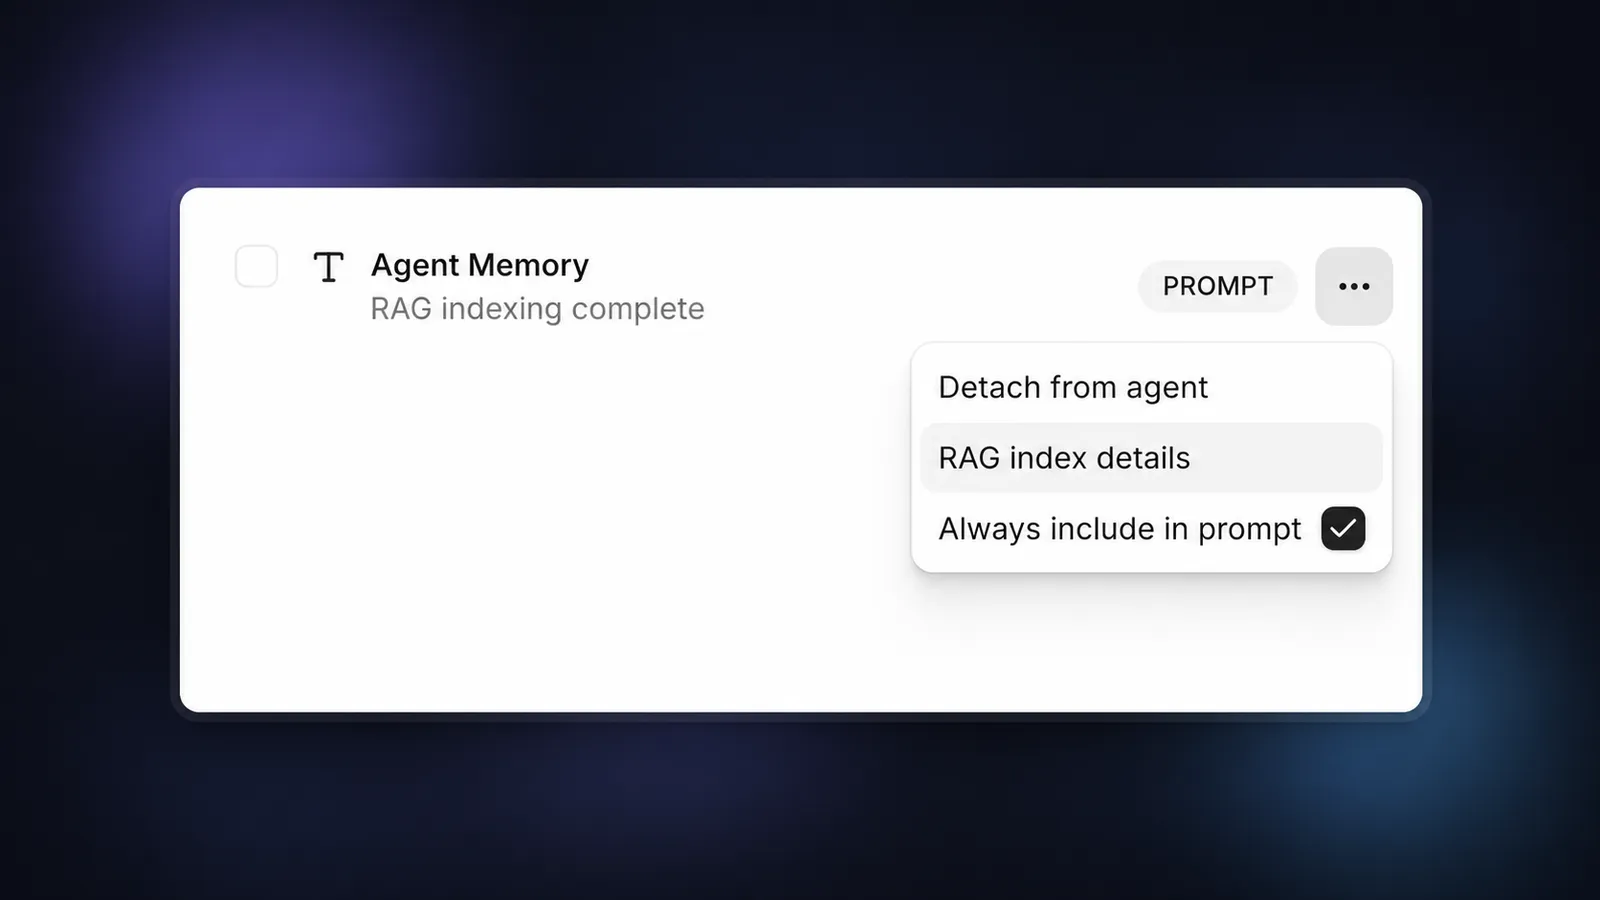
Als je te veel documenten instelt op de modus “Prompt”, kunnen contextlimieten worden overschreden. Gebruik deze optie spaarzaam voor cruciale informatie.
Je agent met RAG testen
Test je agent na het opslaan van je configuratie door vragen te stellen over je kennisbank. De agent zou nu specifieke informatie uit je documenten moeten kunnen ophalen en raadplegen.
Gebruikslimieten
Om resources eerlijk te verdelen, hanteert ElevenLabs per workspace limieten voor de totale grootte van documenten die voor RAG kunnen worden geïndexeerd, afhankelijk van je abonnementsniveau.
De limieten zijn als volgt:
Opmerking:
- Deze limieten gelden voor de totale oorspronkelijke bestandsgrootte van documenten die voor RAG zijn geïndexeerd, niet voor de interne opslaggrootte van de RAG-index zelf (die aanzienlijk groter kan zijn).
- Documenten kleiner dan 500 bytes kunnen niet voor RAG worden geïndexeerd en worden in plaats daarvan automatisch in de prompt gebruikt.
API-implementatie
Je kunt RAG ook implementeren via de API: