

オーディオブック
エンドツーエンドのワークフローで、書かれたコンテンツをスタジオ品質のオーディオに変換
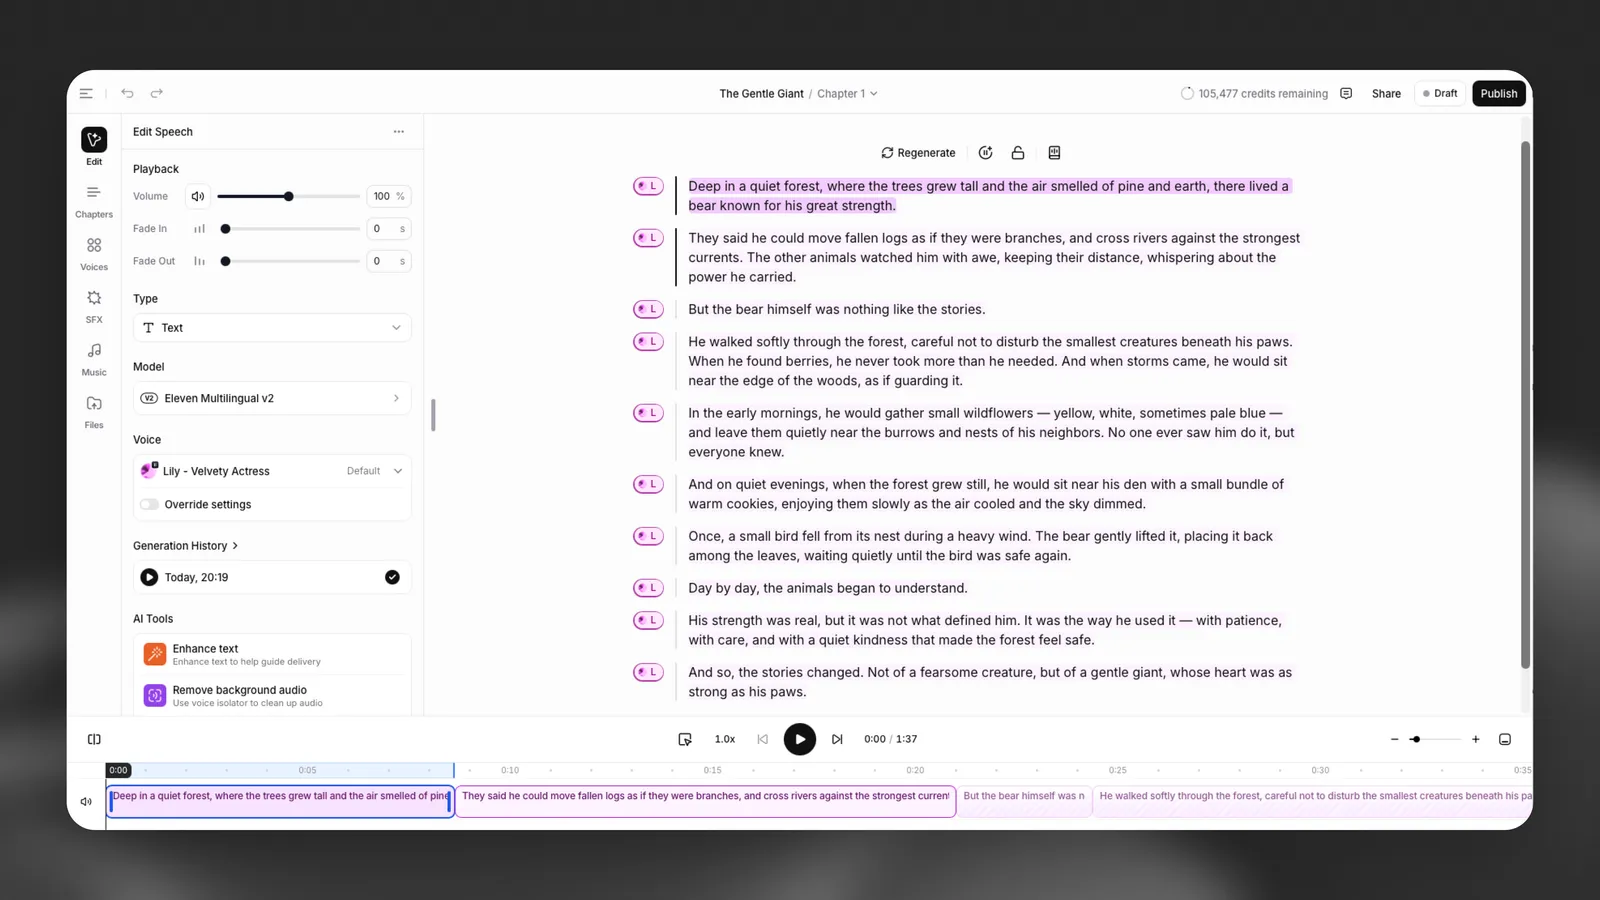
概要
オーディオブックでは、書かれたコンテンツをスタジオ品質のオーディオに変換するためのエンドツーエンドのワークフローを提供します。
原稿を貼り付けまたはアップロードし、ElevenLabsのボイスでリアルなナレーションを生成して、プロジェクトを章ごとに構成できます。音楽やサウンドエフェクトでオーディオブックを強化し、エディター上でナレーションを直接編集・調整できます。
キャラクターキャスティングは、原稿内の登場人物を検出し、それぞれにボイスを提案します。書籍内の実際のセリフで試聴することもできます。登場人物のボイスを変更すると、その人物のすべてのセリフが書籍全体で更新されます。
完成後は、オーディオブックをエクスポートするか、ElevenReaderやパートナーマーケットプレイスなどのリスニングプラットフォームに直接公開できます。
オーディオブックは、リスナーが再生中に好みのボイスを選べるダイナミックナレーションにも対応しています。
ガイド
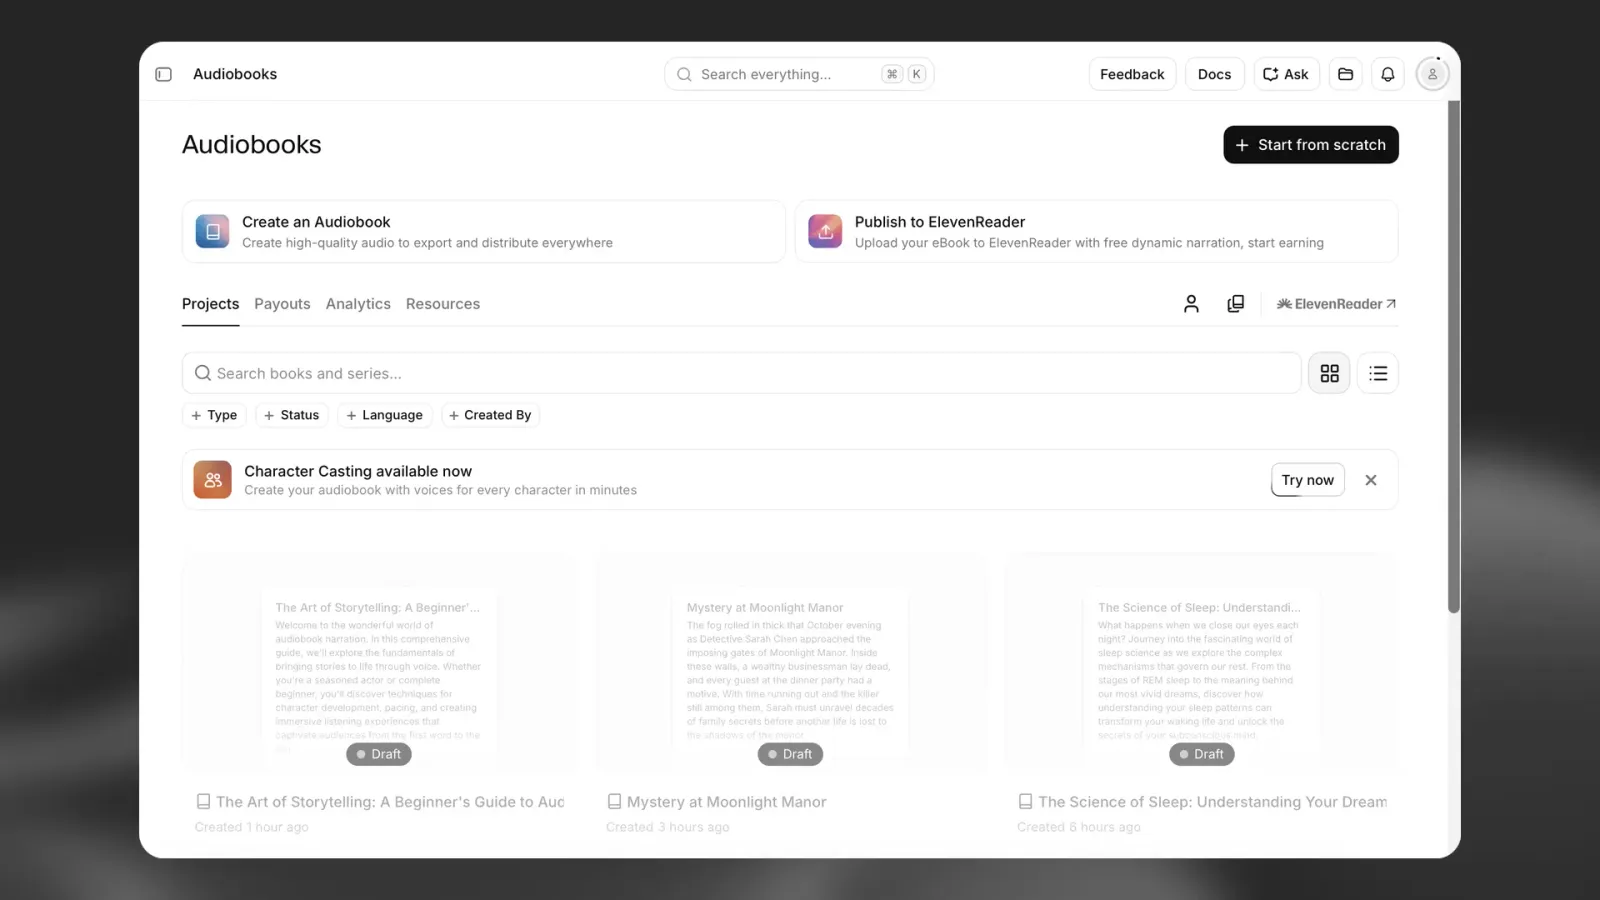
ファイルをアップロードして基本設定を選択
オーディオブックページで オーディオブックを作成 を選択すると、新しいプロジェクトを開始できます。
原稿をアップロード
原稿をアップロードエリアにドラッグ&ドロップするか、デバイスを参照してファイルを選択します。現在、Audiobooksは以下の形式に対応しています。
- EPUB
ナレーションスタイルを選択
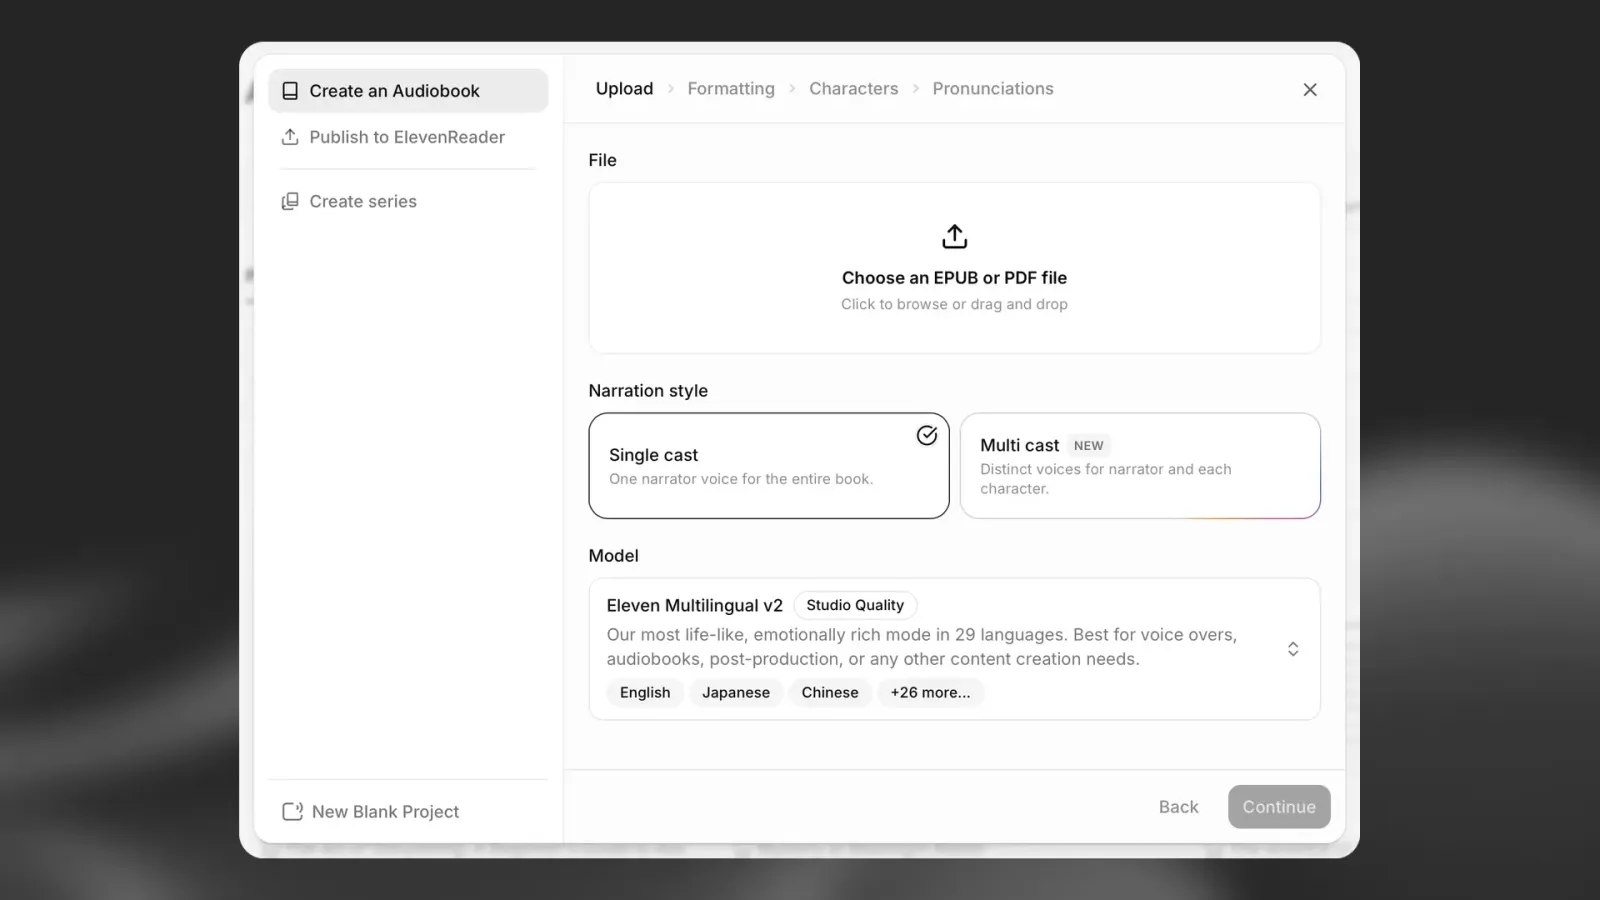
オーディオブックのナレーション方法を選択します。
- シングルキャスト — 1人のナレーター音声が本全体を読み上げます
- マルチキャスト — ナレーターと、原稿内で検出された登場人物に異なる音声が割り当てられます
1つの音声で本全体をナレーションする場合は シングルキャスト を選択します。ナレーターと登場人物に別々の音声を使用した、より演劇的な制作にしたい場合は マルチキャスト を選択します。
モデルを選択
オーディオブックで使用するAIモデルを選択します。自然で感情豊かな仕上がりを得るには、長尺のボイスオーバーやオーディオブック向けに Eleven Multilingual v2(スタジオ品質) をおすすめします。29言語に対応しています。
続行 を選択して、原稿の処理を開始します。
原稿を解析して書式設定
続行 を選択すると、ElevenLabsがファイルを自動的に解析します。システムはドキュメントを分析し、メタデータ、章、書式を抽出します。
解析が完了すると、書式設定 画面が表示されます。
カバー画像を確認
EPUBまたはPDFにカバーが含まれている場合、システムが自動的に抽出してオーディオブックのアートワークとして表示します。以下を行えます。
- カバーを置き換える
- カバーを削除する
- 抽出されたカバーをそのまま使用する
検出されたセクションを確認
ElevenLabsは、原稿内の以下のような構造的なセクションを識別します。
- 著作権表示
- 献辞
- 序章
- 章
- 終章
- その他の書式設定されたセクション
チェックボックスを使用して、オーディオブックに含めるセクションを選択または選択解除します。
続行する前に、検出された構造をよく確認してください。原稿の書式はさまざまであり、システムが常に意図どおりにセクションを識別するとは限りません。
音声を選択して登場人物をキャスティング
登場人物 のステップで、オーディオブックに使用する音声を選択します。
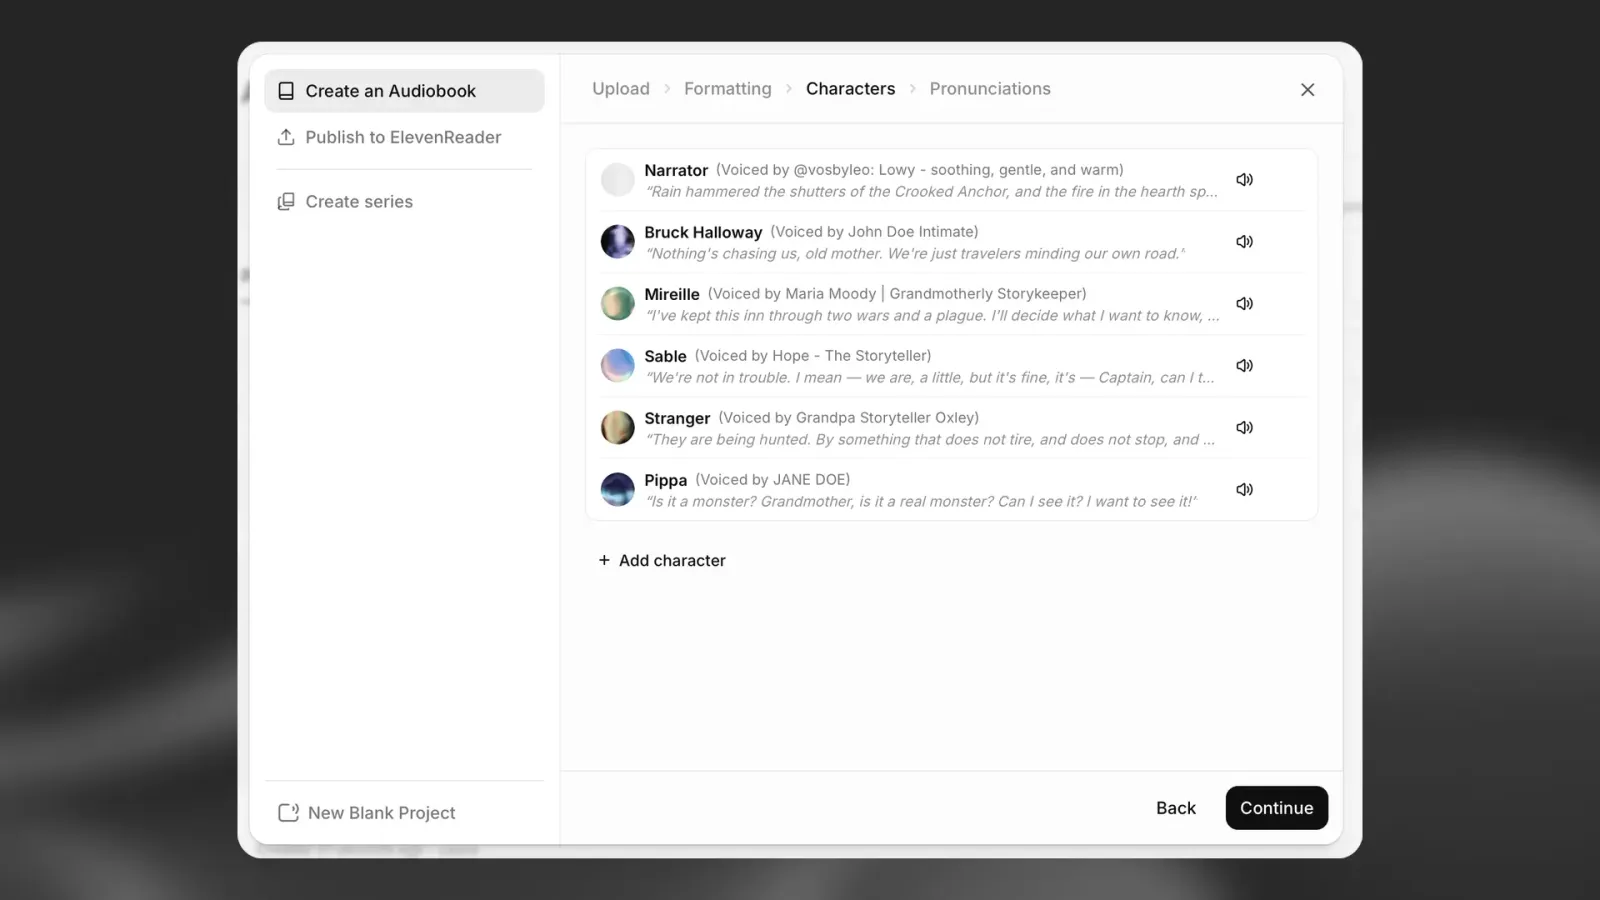
マルチキャストのオーディオブックをキャスティング
マルチキャスト を選択した場合、ElevenLabsが原稿を分析し、物語内で発話していると判断した登場人物を検出します。その後、以下に固有の音声を割り当てられます。
- メインナレーター
- 検出された各登場人物
- 原稿内で特定されたその他の話者
登場人物の検出はAIによって生成されるため、出発点として扱ってください。特に脇役、名前のない登場人物、周囲のナレーションと区別しにくい話者は、システムが識別できない場合があります。
検出された登場人物リストを確認し、必要に応じてキャストを調整します。最終的なキャストが原稿に合うよう、音声の割り当てを追加、変更、削除してください。
ボイスライブラリを探索
利用可能なスタジオ品質の音声を参照するか、検索とフィルターを使用して適した音声を見つけます。フィルターには以下があります。
- 言語
- アクセント
- カテゴリ
- 性別
- 年齢
割り当てる前に音声をプレビューできます。
発音ルールを確認して追加
発音 のステップでは、名前、地名、造語、その他の珍しい用語の読み方を調整できます。
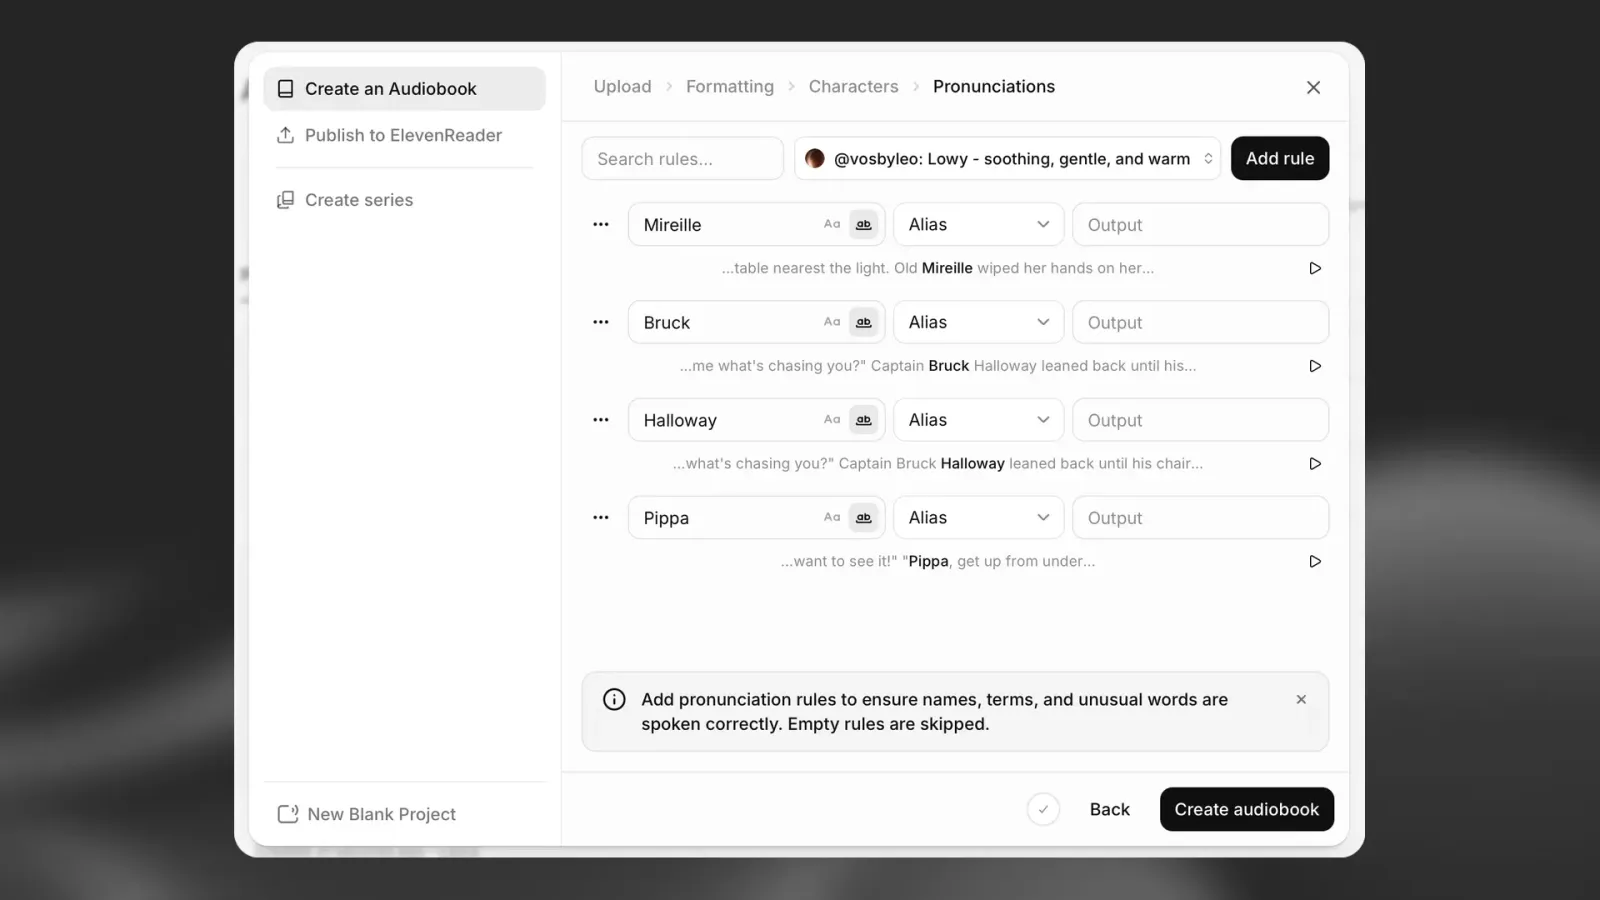
自動検出された用語を確認
ElevenLabsは原稿をスキャンし、発音ルールが必要になる可能性のある用語を提案します。登場人物名、地名、架空の用語などが含まれる場合があります。
提案は自動生成されるため、本にとって重要なすべての単語が含まれるとは限りません。リストを確認し、特別な扱いが必要な重要用語にルールを追加してください。
発音ルールを追加
各用語に対して、エイリアス などのルールを作成し、希望する 出力 を入力できます。出力は、その用語をどのように発音するかをモデルに指示します。
右上の ルールを追加 を選択して、単語を手動で検索し、発音を定義することもできます。
文脈内で発音をプレビュー
ルールの横にある 再生 アイコンを選択すると、選択した音声が原稿内でその用語が使われている文を読み上げます。
文脈の中で聞くと、以下を確認できます。
- 発音
- リズム
- 前後の文
- 割り当てた音声でルールが機能するかどうか
空のルールはスキップされ、それらの用語にはモデルのデフォルトの発音が使用されます。
編集と再生
オーディオブックの作成後は、エディターで調整や強化を行えます。
ナレーションの生成とプレビュー
コンテンツを追加すると、エディター内で直接ナレーションを生成・プレビューできます。
- 再生 ボタンを使用して、ナレーションを生成するか、すでに生成済みのオーディオを再生します
- 生成は各章内の段落単位で行われます
各段落のステータスは、テキスト左側のバーで表示されます。
- 濃いバー — ナレーションが生成済み
- 薄いグレーのバー — ナレーションがまだ生成されていない
再生モード
再生ボタンの左にあるモードセレクターで、再生と生成の動作を選択できます。
- 最後まで(一度に1つずつ生成) — 選択した段落から章の終わりまで再生し、段落を1つずつ生成します
- 最後まで(先行してクリップを生成) — 選択した段落から章の終わりまで再生し、よりスムーズに再生できるよう複数の段落を先行して生成します
すでに生成済みのオーディオを再生してもクレジットは消費されません。クレジットが使用されるのは、 新しいナレーションを生成するときのみです。
オーディオブックを編集
テキストの編集、音声設定の調整、タイミングの変更を行い、必要に応じて特定のセクションを再生成できます。
タイムラインでは、ナレーション、音楽、サウンドエフェクトがどのように一緒に再生されるかを確認し、エクスポート前に調整できます。
オーディオブックを強化
オーディオブックには、追加のオーディオレイヤーを加えられます。
- 音声 — ナレーション音声を選択または更新
- サウンドエフェクト(SFX) — ライブラリからエフェクトを追加するか、カスタムサウンドを生成
- 音楽 — Music Marketplaceから選択するか、新しいトラックを生成
音楽またはサウンドエフェクトを追加するには、以下を行います。
- + アイコンをクリックしてプロジェクトにインポートします
- タイムライン上に別トラックとして表示され、ナレーションと同時に再生されます
音声とモデルの設定
エディターのサイドバーとプロジェクト設定にある 音声とモデルの設定 を使用して、オーディオブックのサウンドをカスタマイズできます。
音声とモデルの選択
- 音声 — オーディオブックで使用するナレーターを選択します
- モデル — 音声品質、表現力、対応言語を決定します
以下の2か所で変更できます。
- エディターのサイドバー — 選択した段落またはセクションに設定を適用します
- プロジェクト設定 — プロジェクト全体のデフォルト音声とモデルを設定します
プロジェクトレベルの設定にアクセスするには、左上のメニューを開き、プロジェクト設定 を選択します。
利用可能なモデル
ElevenLabsは、異なる強みを持つ複数の音声モデルに対応しています。
- Eleven v4 — 最高品質と最も幅広い言語サポートを備えた最新モデル
- Eleven v3 — 以前の表現力豊かなモデル(より多くのプロンプト制御が必要)
- Eleven Multilingual v2 — 高品質で自然なナレーション(ほとんどのオーディオブック用途のデフォルト)
- Eleven Flashモデル — 速度と低レイテンシ向けに最適化
モデルはいつでも切り替えられます。ただし、以下にご注意ください。
モデルを変更しても、すでに生成済みのオーディオは更新されません。影響を受ける段落を再生成する必要があり、クレジットを使用します。
デフォルト設定
新しいオーディオブックを作成するとき:
- デフォルトモデルは Eleven Multilingual v2 です
- デフォルトの音声は自動的に選択されます(いつでも変更可能)
- デフォルト言語は 自動検出 に設定されます
音声設定(選択ごと)
エディター内で作業する際、特定の段落の音声設定を上書きできます。サイドバーで 設定を上書き を有効にすると、プロジェクト全体に影響を与えずに話し方を調整できます。
再生コントロール
コンテキストサイドバーには、ナレーションを細かく調整するための再生コントロールがあります。
- 音量 — 音の大きさを調整
- フェードイン/フェードアウト — オーディオの開始と終了のしかたを調整
これらの設定は、選択した段落に適用されます。
AIツール
サイドバーには、オーディオブックを改善するAI搭載ツールも用意されています。
- テキストを改善 — 話し方と明瞭さを改善するためにテキストを調整
- バックグラウンドオーディオを除去 — ボイスアイソレーションでオーディオをクリーニング
- ボイスチェンジャーを使用 — 既存オーディオの音声を変更
- 自分の声で話し方を指定 — 話し方のガイドとなる参照オーディオを録音(アクターモード)
品質とエクスポート設定
オーディオ品質はサブスクリプションプランとプロジェクト設定によって自動的に決まり、クレジット使用量には影響しません。
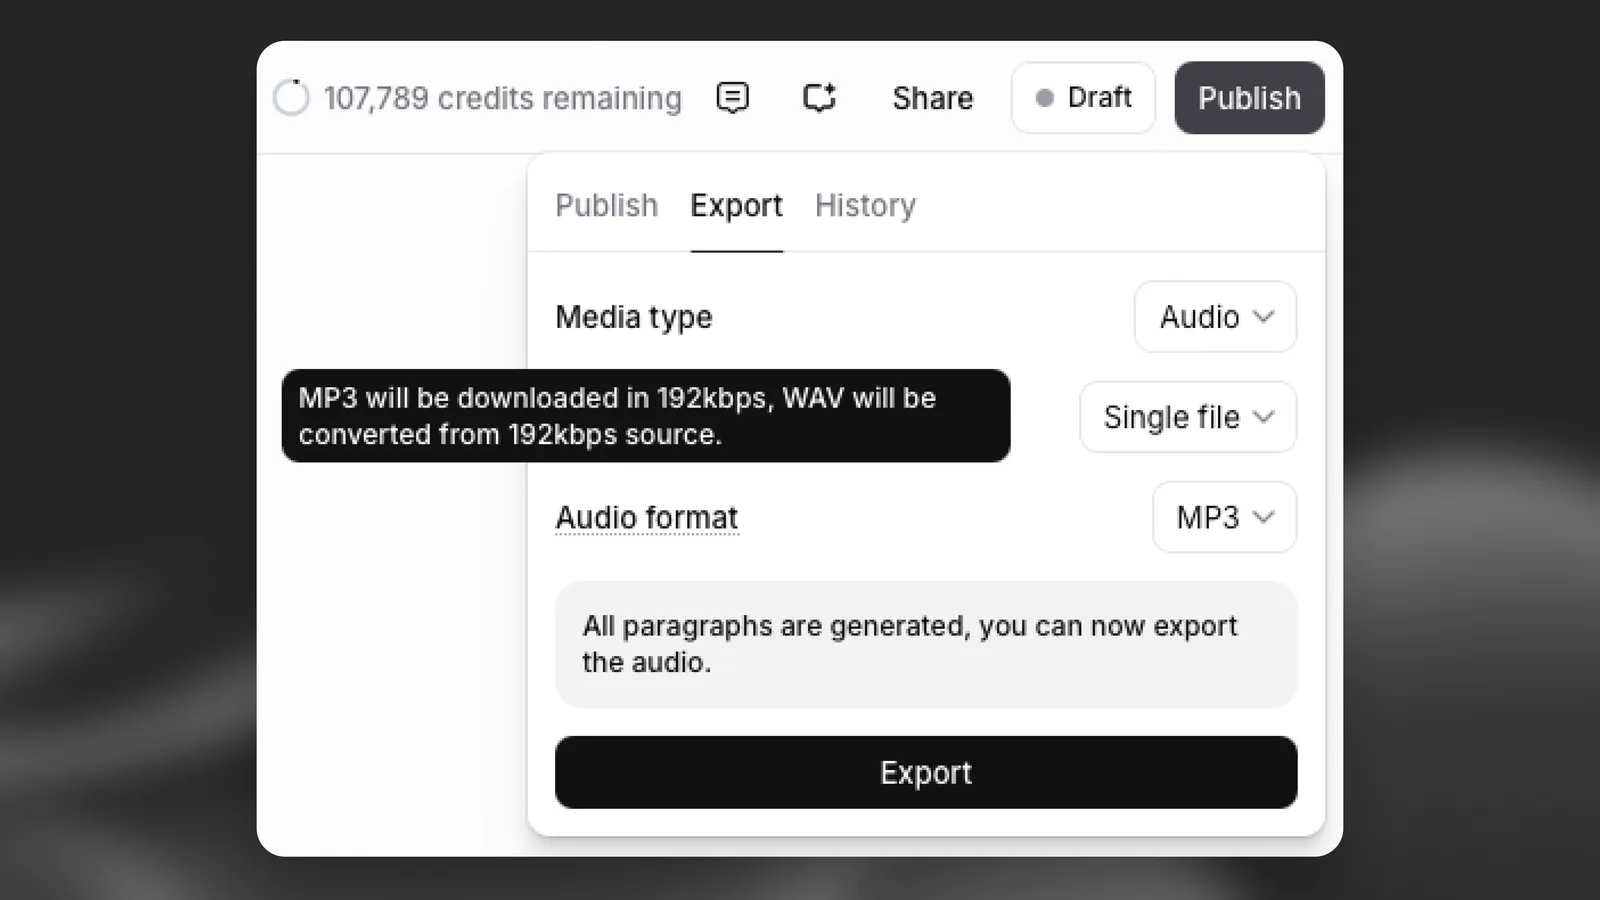
プロジェクトの正確な出力品質を確認するには、右上の 公開 をクリックして エクスポート タブを開き、オーディオ形式 フィールドにカーソルを合わせます。ビットレートやサンプルレートなどの詳細を確認できます。
重要な動作
オーディオの生成後に音声またはモデルの設定を変更した場合:
- 既存の段落は自動的に更新されません
- 変更を反映するにはオーディオを再生成する必要があり、クレジットを使用します
コンテキストサイドバー
コンテキストサイドバーは、プロジェクト内で選択した内容に応じて更新されます。
ナレーションでは、以下を利用できます。
- 再生コントロール
- 音声とモデルの選択
- 設定の上書き
- 生成履歴
- AIツール
これにより、非常に細かいレベルでナレーションを調整・改善できます。
発音辞書
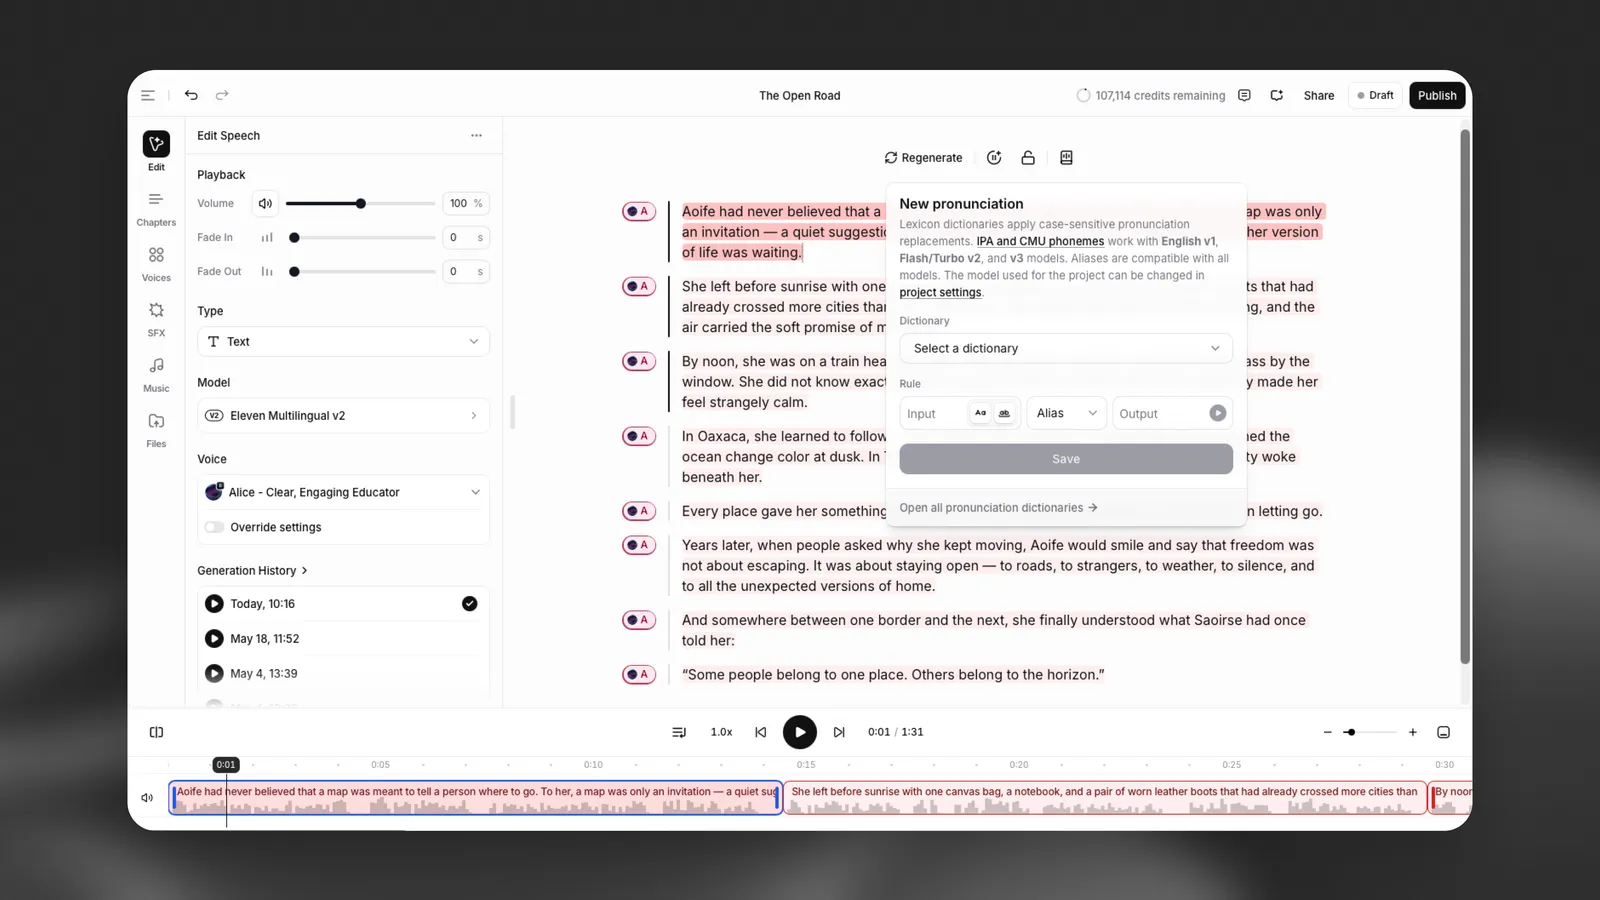
発音辞書を使用すると、特定の単語の読み方を調整できます。
これは以下の場合に便利です。
- 登場人物名
- ブランド名
- 頭字語
- 珍しい単語や曖昧な単語
発音辞書では、以下を使用して単語の読み方を定義できます。
- 音素ルール — 音声記号を使用して発音を指定
- エイリアス — 希望する発音になる別のスペルで単語を置き換え
テキスト内の単語が接続された辞書内のルールに一致すると、システムは定義した発音を使用します。
発音辞書の使い方
- ツールバーから 発音エディター を開きます
- 新しい辞書を作成するか、既存の辞書を選択します
- 調整したい単語のエントリーを追加します
- 接続 をクリックして、辞書をプロジェクトに適用します
辞書ファイルをアップロードすることも、発音エディターからすべての辞書を管理することもできます。
重要な注意事項
- 辞書は順番に適用されます。最初に一致したルールが使用されます
- 変更は新しく生成するオーディオにのみ適用されます。更新を聞くには、段落を再生成 する必要があります
- 音素ルールは、Flash v2などの英語モデルでのみサポートされています
発音辞書は、長いオーディオブック全体で一貫性を保つのに特に役立ちます。
登場人物のキャスティング
登場人物のキャスティングでは、本の登場人物に音声を割り当てられます。原稿をアップロードすると、Audiobooksが登場人物を検出し、それぞれに音声を提案します。本の実際のセリフでプレビューすることもできます。
生成後に登場人物を更新
オーディオ生成後に登場人物の音声を変更すると、その登場人物の以前のオーディオは削除されます。新しい音声を使用してオーディオを再生成する必要があり、クレジットを使用します。続行する前に変更の確認を求められます。
登場人物が話すすべてのセリフが、本全体で更新されます。個々の段落や章を手動で再割り当てする必要はありません。影響を受けるすべての段落のオーディオを自動的に再生成するには、オーディオブックの新しいバージョンをエクスポートします。クレジットが請求されるのは、再生成が必要な段落のみです。
ボイスライブラリ
Audiobooksは、10,000を超える音声ライブラリで90以上の言語のナレーションに対応しています。自分でナレーションしたり、登場人物の音声を提供したりする場合は、数秒で自分の声をクローンすることもできます。
ベストプラクティス
解析ステップから進む前に、書式設定を確認してください。セクションが誤って検出されると、最終的なオーディオブックに影響する可能性があります。
マルチキャストプロジェクトでは、検出されたすべての登場人物と音声の割り当てを確認してください。特に、名前のない登場人物や脇役は、システムが正確に識別しにくい場合があります。
書かれたルールだけに頼らず、文脈の中で発音プレビューを聞いてください。単独では正しく聞こえる発音でも、文章全体では調整が必要になる場合があります。
エクスポートまたは公開する前に、生成されたオーディオブックを確認してください。Audiobooksは制作プロセスの多くを自動化できますが、洗練された仕上がりには編集と品質チェックが不可欠です。
章
オーディオブックは章で構成され、手動で作成することも、ドキュメントのインポート時に自動検出することもできます。
以下を行えます。
- + ボタンを使用して新しい章を追加
- 章の名前変更または並べ替え
- 章ごとにナレーションを生成
章を使用すると、長いコンテンツを整理しやすくなり、エクスポートの柔軟性も高まります。
ナレーションモード
Audiobooksは、目的に応じて2つの異なるナレーション方法に対応しています。
オリジナルオーディオ
選択した音声を使用してオーディオが事前に生成され、すべてのリスナーに対して固定されます。
このモードは、以下を完全にコントロールしたい場合に最適です。
- 音声の選択
- タイミングと話し方
- 音楽とサウンドデザイン
ダイナミックナレーション
固定音声を使用する代わりに、ダイナミックナレーションではリスナーが再生中に好みの音声を選択できます。
このモードは以下に最適です。
- アクセシビリティ
- パーソナライズ
- リスナーの好み
音楽、サウンドエフェクト、外部オーディオは、ダイナミックナレーションの再生には含まれません。
エクスポートと公開
エクスポートオプション
オーディオブックをエクスポートするには、右上の 公開 をクリックして エクスポート タブを開きます。
Audiobooksでは、コンテンツの利用方法に応じた柔軟なエクスポートオプションを提供しています。
エクスポート範囲
- プロジェクト全体
- 個別の章
メディアタイプ
- オーディオ
- タイムラインデータ(AAF)
- 字幕
ファイル構造
- 単一ファイル
- 章ごとのZIP
オーディオ形式
- MP3
- WAV
一部のセクションがまだ生成されていない場合、エクスポート中に自動的に完了します。この処理にはクレジットを使用します。
公開と配信
オーディオブックを配信するには、右上の 公開 をクリックし、公開 タブを開いたままにします。
以下に直接公開できます。
- ElevenReader — アプリ内でのリスニングと配信
- SpotifyやInAudioなどの パートナープラットフォーム
- 追加形式向けの ElevenLabs Video または オーディオネイティブ
公開すると、オーディオブックをリスナーと共有できます。また、ElevenReaderなどの対応プラットフォームでは、配信による収益化を開始できます。
ElevenReaderに公開
ElevenReaderに公開する際は、オーディオブックを配信向けに準備するための提出フローを進めます。
これには以下が含まれます。
- 著者プロフィールの作成または選択
- 書籍メタデータ(タイトル、サブタイトル、カバー画像)の追加
- 配信詳細の提供
- 支払いと契約の設定
- オーディオブックの確認と提出
提出後、ElevenReaderアプリで利用可能になる前にオーディオブックが審査されます。
シリーズでオーディオブックを整理
複数のオーディオブックをシリーズにまとめて、関連コンテンツを整理し、見つけやすさを向上できます。
シリーズを作成するには:
- Bookshelf に移動します
- シリーズを作成 ボタン(右上)をクリックします
- 以下を入力します。
- シリーズ名
- 説明
- 著者プロフィール
- 言語
- 必要に応じて既存の本をシリーズに追加します
- シリーズを作成 をクリックします